AI探索指南

  1. Andrej Karpathy 的《Let's reproduce GPT-2 (124M)》视频真是学习 LLM 的至宝,虽然时间有点长(4小时), 但完整跟下来收获巨大,强烈推荐

    Andrej Karpathy 的《Let's reproduce GPT-2 (124M)》视频真是学习 LLM 的至宝,虽然时间有点长(4小时), 但完整跟下来收获巨大,强烈推荐。
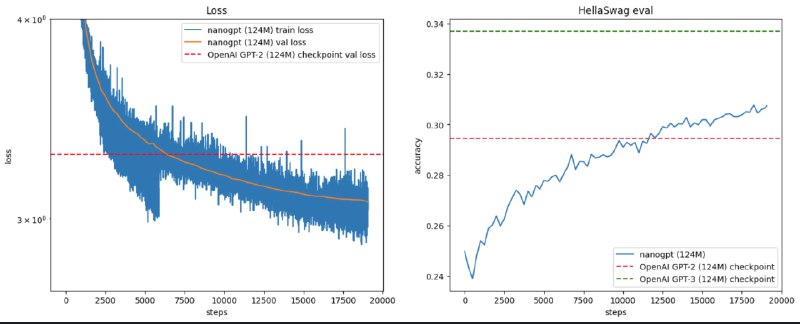
    如果你和我一样,一步一步地跟着增加、修改代码,而不是拿着最终结果 repo 里的代码去直接运行的话,有个小坑:见图 1,红框中的代码,在原视频中是在 L500 loss.backward() 之前才调用的,但如果这么做的话,会导致 loss & HellaSwag eval 没有视频里的效果好,训练完成后没能超过 OpenAI GPT-2 124M checkpoint,见图 2。
    需要像红框中代码一样,model.require_backward_grad_sync 放在 forward pass 之前,就能成功复现出来了,参见图 3(所以要注意 repo 里带有“# added after video”的 comment😅)

  2. 今天用了一下 Claude 的 prompt 调试台,真的强烈推荐

    今天用了一下 Claude 的 prompt 调试台,真的强烈推荐。

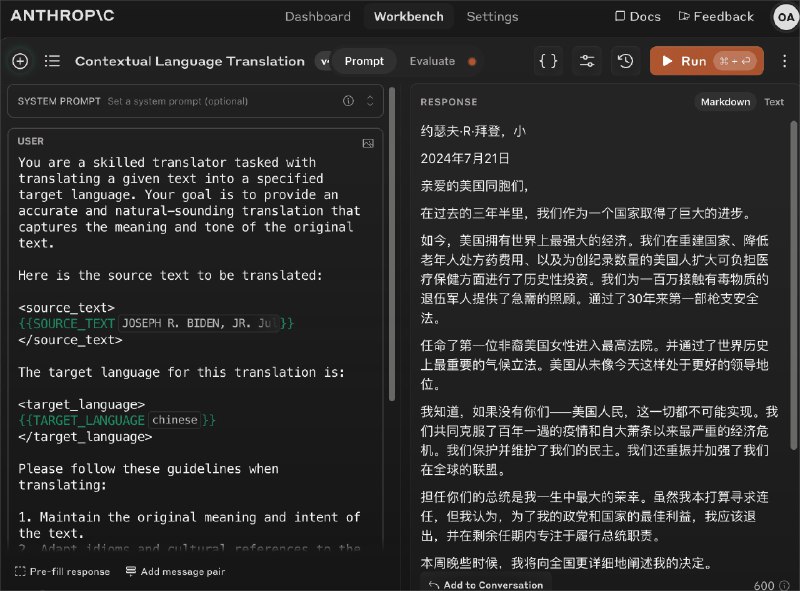
    写一句话任务,自动生成 prompt
    简单修改 prompt 之后测试了三个 case
    指令遵循非常好
    翻译结果非常好
    要不要例句都能随时提要求
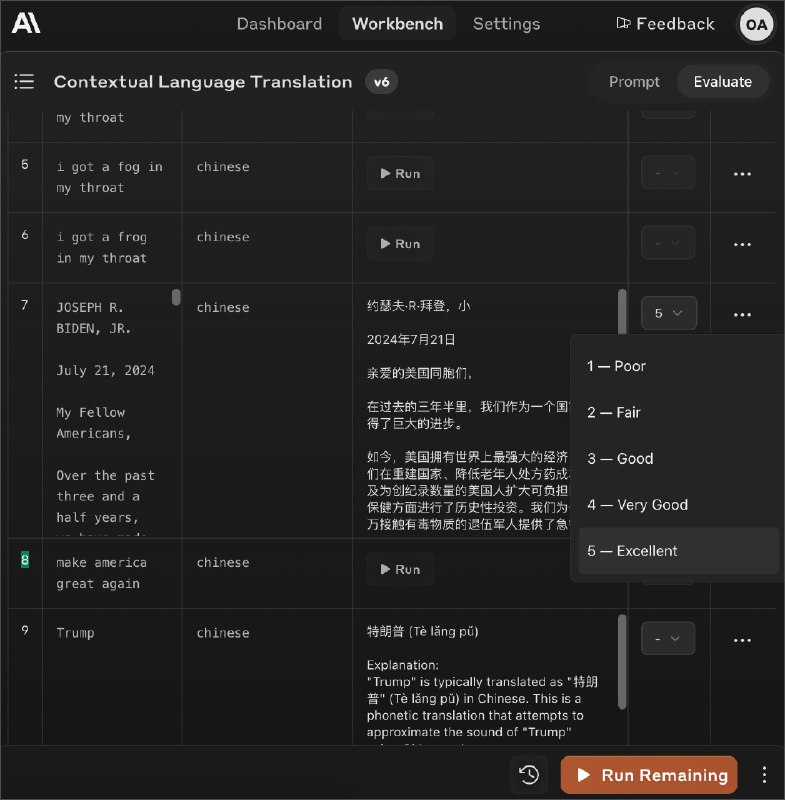
    还可以用表格批量跑结果
    跑完结果还能直接打分评估

    这是把大模型公司的内部的最佳实践工具直接做成了产品

    使用地址:
    https://console.anthropic.com/dashboard

  3. 实现垂类 AI 搜索引擎 SOP👇

    实现垂类 AI 搜索引擎 SOP👇

    # 确定三个核心问题:

    1. source list 从哪些地方检索数据
    2. answer prompt 使用什么提示词模板回复
    3. llm model 使用哪个大语言模型回复

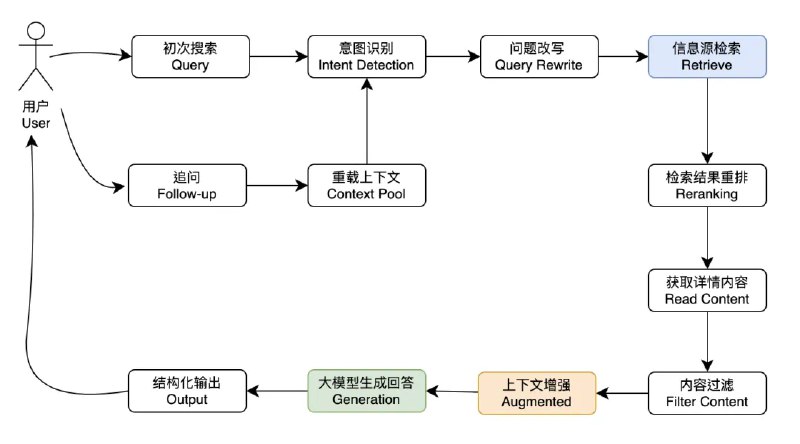
    # 搜索前query rewrite:

    1. 结合历史消息,判断当前 query 是否需要 retrieve
    2. 结合历史消息,做指代消解,把代词替换成具体的名词
    3. 从指代消解后的 query 提取关键词 keywords

    # RAG 流程

    1. 使用query + keywords 作为入参,从source list 获取检索结果(在线API检索+本地index检索),必要时可对 query + keywords 进行翻译,使用不同语言进行多轮检索
    2. 检索结果聚合重排reranking
    3. 获取重排后 top_k 条内容详情
    4. 使用回复提示词 + 检索内容 + 历史消息作为 context,带上最新 query 请求 LLM 回复

    # 主要工程量

    1. 对内容源 build index

    对于没有标准API的source,需要对source站点的数据构建索引。增量构建使用source的搜索框,存量构建使用搜索引擎网页快照,很难拿到某个 source 的全量数据

    2. 更新 source 权重

    系统预置权重 + 用户点击更新 source 权重,多信息源检索时依据 source 权重返回结果数量和初始排序

    3. 多信息源重排

    需要一个高效/快速的 reranking 框架,比如 FlashRank

    4. 构建 chunk 内容池

    对检索到的内容进行 chunk 拆分,存储向量数据库,挂载上下文请求 LLM 回答时,相似度匹配部分内容,避免暴力传输

    5. 构建关键词库

    定期分析历史 query,提取热搜关键词,构建关键词库。命中关键词库的 query,retrieve 环节走缓存

    ------

    AI 搜索引擎,做一个容易,做好太难,细节太多,需要大量的雕花工作。

    欢迎补充。

  4. 1. AI投资和创业热度回落,开始找垂类应用场景

    1. AI投资和创业热度回落,开始找垂类应用场景。技术上也开始考虑如何用大模型蒸馏小模型。
    2. AI+游戏不成立,还是要回归到游戏本身的体验和价值,AI带来了多少加成。AI NPC没有什么意义,不需要一个更智能的NPC,试问有多少人玩游戏会和主线任务之外的NPC对话?如果用AI去生成任务和奖励,又需要考虑这些对游戏经济体系平衡性的冲击。
    3. 一部分同人爱好者自己训一些同人角色谈恋爱,并能分享给其他同好。需要解决新鲜感衰退和长时记忆的问题。对于这一个小众群体是立住了,但市场规模确实不大。乙女恋游想要稳定生成能够提供稳定情绪价值的角色和情节有一定随机性。
    4. AI agent用于SLG游戏训练替身,最终实现类似于“自走棋”的效果。如何增加个性化和技能点数可调节是个问题。
    5. AIGC能够批量化生成及格线的内容,但头部和精品内容可能仍需要二次加工或创作。又或者AIGC内容可以找到一个对内容有批量化需求但对质量要求不高的赛道,比如购物app的视频页。
    6. AI的广泛使用造成人类失业是短期内的震荡,就像历史上工业革命一样,每次生产力的进步都会促使人类产生新的生产方式和技能迁移。比如prompter。又或者一个有运镜经验的导演生成的视频还是会比一般的使用者生成更优质的视频。
    7. AI的应用不会让人类有更多的娱乐时间,就好像移动互联网的出现让工作和生活的界限变得模糊,AI只会使这一现象更加严重。AI的监督可能会使现在数据驱动滴滴司机和骑手一样,让人在工作时更卷。
    8. 人类后面会变成如何为AI生产能量和高质量的数据。
    9. 如果AIGC还是用于PGC,那模式和之前的内容生产没有太大区别,真正要想成为爆款,核心还是UGC和社区,而核心不在于AI。

  5. 首个直膝行走的人形机器人 |CyberRobo

    首个直膝行走的人形机器人 |CyberRobo

    膝关节是人体内最大、最复杂的关节,也是最大的承重关节,它在我们站立和行走时起着非常重要的作用。人在走路时,膝盖通常会稍微弯曲,这样可以减缓走路时的震动,起到缓冲的作用。直膝行走有助于人形机器人更好地适应楼梯、坡道等人类环境中常见的地形。

  6. 学习langgraph时感觉langchain这个项目的封装确实比较过度,于是我尝试了完全不用框架,不用function call/tools/json mode,只用最基础llm chat api, 来构建一个自带流程图的noiton写作agent,开源地址:

    学习langgraph时感觉langchain这个项目的封装确实比较过度,于是我尝试了完全不用框架,不用function call/tools/json mode,只用最基础llm chat api, 来构建一个自带流程图的noiton写作agent,开源地址:https://github.com/etrobot/Flow2Agent
    用了硅基流动的免费api,以及jina.ai的免费搜索api,不得不说免费就是香啊!

    Invalid media: video