AI探索指南

  1. 【佐伊】听👉武大郎的绝唱

    【佐伊】听👉武大郎的绝唱
    昨天的恐怖片演绎了现代版真实的你死我活的惊悚。
    今天把镜头拉回来,听一听武大郎临终前的绝唱,不得不说:大郎啊,如果你当初有这样的才华,那潘金莲怎么能出轨呢?

    现在的AI是真强大,药下得也猛,这歌西门庆听了,应该退避三舍。

    有道是:红烛下的海誓山盟,都是虚谎。
    最后只有一句:大郎喝药了,然后流下一滴出卖的泪。
    听一首歌:《出卖》
    Media is too big
    VIEW IN TELEGRAM

  2. 推特和作品就是你最好的简历

    推特和作品就是你最好的简历

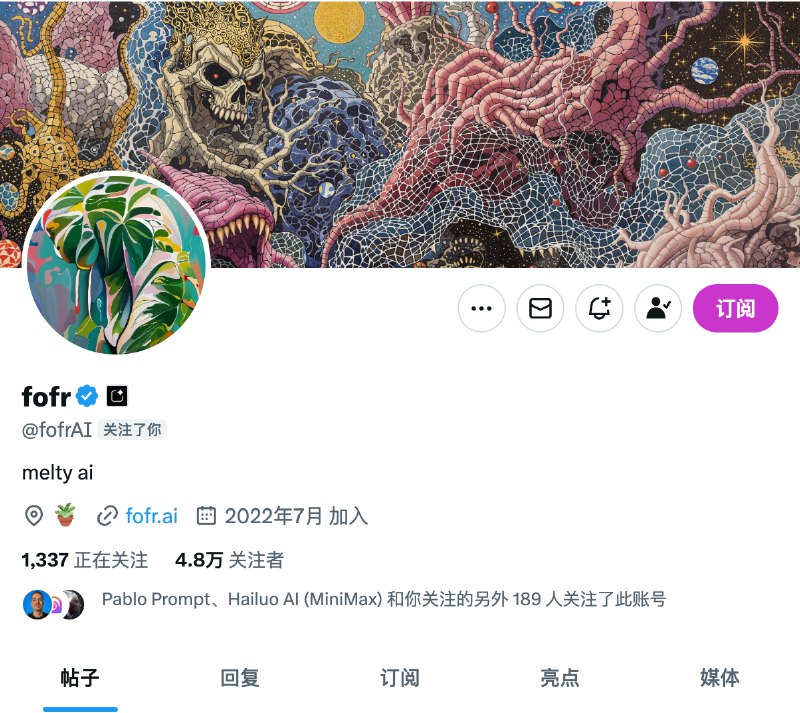
    原来在 Replicate 干的 fofr 加入了 DeepMind

    很多人应该都会对这哥们有印象,在 Nano Banana 和 GPT-4o 图像发布的时候都持续产出了非常多好的案例和测试

    估计 Deepmind 想用他补上自己在图像和视频上的宣传路径,哥们这下这结起飞了

    当然,很荣幸老哥也关注了我

  3. 不是官方数字

    AI探索指南
    昨晚 Kimi K2 的训练团队在 Reddit LocalLLaMA 频道做了一次 AMA 看了一下海外用户对于 K2-Thinking 的评价和国内在我评论区的评价还是挺不一样的。 海外用户对价格相对没那么敏感,当然也提到了按调用次数而不是按 Token 这样有些问题,总体来说还是跟关注技术和质量,当然也跟 LocalLLaMA 这个频道的属性有关系。 他们昨晚也在 AMA 里面回答了很多问题,我整理了一些有信息量的: ---------------------------- KDA 会用在下一代旗舰模型…
    不是官方数字。很难量化训练成本,因为很大一部分属于研究和实验。

    在制作 K2 thinking 的过程中,你们遇到的最大挑战是什么?谢谢!

    一个挑战是支持交错的“思考 - 工具 - 思考 - 工具”模式。这在 LLMs 中是相对新颖的行为,实现起来需要大量工作才能正确运行。

    K2 thinking 在几个月来经过许多评测后,已经能抓到 Sonnet 4.5 和 Opus 4.1 漏掉的问题。说实话,感觉 K2 thinking 只差一点系统提示(system prompt)调整就能达到同等水平。这全都要归功于你们的新架构吗?还是你们的训练数据质量也有提升?

    我认为拥有合适的评估方法和数据对性能至关重要。架构和优化器提高了样本效率。

    你们训练堆栈的硬件是什么样的?想了解你们的基础设施如何与那些美国大型公司使用的堆栈相比?

    使用带有 Infiniband 的 H800 GPU;它们不如美国的高端 GPU,而且数量也不占优势,但我们把每一张卡都充分利用起来#ai创造营##kimi#

  4. 昨晚 Kimi K2 的训练团队在 Reddit LocalLLaMA 频道做了一次 AMA

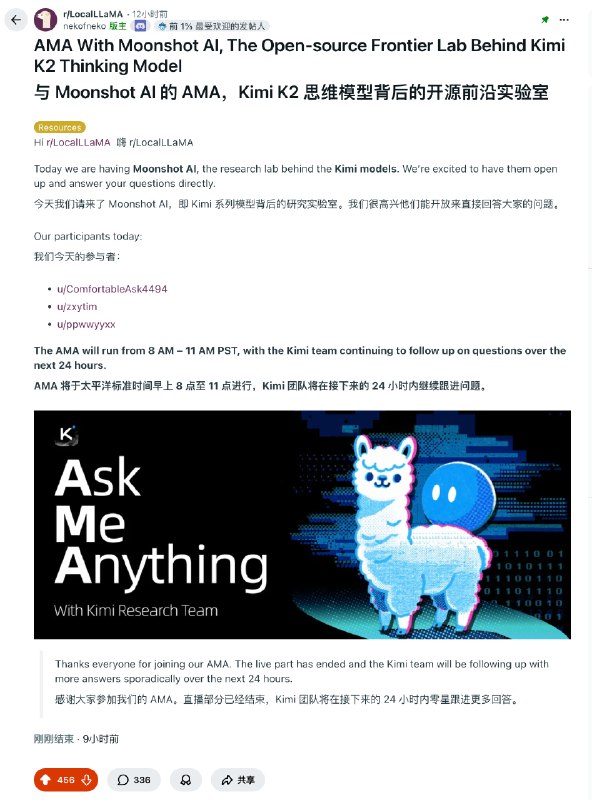
    昨晚 Kimi K2 的训练团队在 Reddit LocalLLaMA 频道做了一次 AMA

    看了一下海外用户对于 K2-Thinking 的评价和国内在我评论区的评价还是挺不一样的。

    海外用户对价格相对没那么敏感,当然也提到了按调用次数而不是按 Token 这样有些问题,总体来说还是跟关注技术和质量,当然也跟 LocalLLaMA 这个频道的属性有关系。

    他们昨晚也在 AMA 里面回答了很多问题,我整理了一些有信息量的:

    ----------------------------

    KDA 会用在下一代旗舰模型 Kimi 吗?它的优势是什么?

    KDA 混合结构(KDA hybrids with NoPE MLA)比传统的 MLA + RoPE 表现更好。

    它在预训练和 RL 阶段都更快、更经济、更高效。

    可以更快预训练、更快上线,也能服务更多用户。

    可能会用在 K3 的训练里面。

    K2 会有视觉语言(VL)版本吗?

    有的,正在做。

    K2 明显不像其他模型那样讨好用户(不拍马屁),是刻意设计的吗?这是后训练的结果吗?

    K2 的非迎合式人格 是通过精心数据挑选设计出来的。

    预训练和后训练都对这种风格有贡献。预训练编码了相关的先验,而后训练则为其增添了一些风味。

    当前 Kimi for Coding 的计费方式按 API 请求数计算,极不透明,一次 prompt 可能多次请求,是否能改成按 token 或 prompt?

    当前按请求数计费是因为:对用户可见;更符合他们的成本结构。但确实理解用户困惑,会考虑改进。

    请问你认为 fp4 相比 int4 真的是一个很重要的改进吗?还是说 int4 已经足够好的编码了?

    选择 int4 是为了对非 Blackwell GPU 更友好,同时利用现有的 int4 推理 marlin 内核。

    K2 Thinking 模型比 GPT-5 Thinking 更强,但输出速度慢很多,是否刻意让它“思考更久”?

    承认 K2-Thinking 在推理阶段更细致、更耗时,但优化正在进行。

    专注于纯文本代理是为了在短期内以牺牲换取达到 SOTA 吗,还是一项长期押注?

    要把视觉语言模型(VL)的数据和训练做对需要时间,因此我们选择先发布文本模型。

    那个 460 万美元的 K2 Thinking 训练费用是真的吗?

  5. 昨天和一个创业的朋友聊

    昨天和一个创业的朋友聊
    总结出产品经理未来的三个趋势

    第一是:从文档到Demo

    从字节到阿里
    老板们已经开始强制要求只看AI Coding出来的Demo了
    这很好理解,比起文档和PPT
    可交互的成品更容易理解

    很多年前蒋凡开会不带电脑
    直接用iPad、手机看Demo

    只不过过去需要产研团队协作才能做到
    现在甚至1-3人即可快速完成

    第二是:产品经理都要变成工程师

    这种偏Demo的工程师会由现在的产品和UI转行
    之前的研发就是偏落地的工程师

    最后就全都是工程师
    转不了的直接被淘汰

    最近参加的黑客松都体现了快速Demo
    用社媒获客和迭代产品的强大趋势
    产品经理落地能力将会得到质的飞跃
    不再是办公室里吹空调比嘴皮子了

    第三是:Spec Coding必定盛行

    先写文档再开发,这本来也是产品的基本工作
    所以新招人就直接招产品经理
    然后学Vibe Coding直接开干

    再加上AI,可以生成非常详细的PRD
    以及不断迭代的PRD
    Spec = PRD = Code

    最后,为何这个变化不可逆

    效率与组织逻辑的必然
    1. 减少沟通损耗
    2. 大厂效率提升
    3. 小团队崛起

    如果大厂也这么变化
    “大团队和小团队没有什么成本和执行力的问题,没有区别了,最后就是想法。”

  6. 推特和作品就是你最好的简历

    推特和作品就是你最好的简历

    原来在 Replicate 干的 fofr 加入了 DeepMind

    很多人应该都会对这哥们有印象,在 Nano Banana 和 GPT-4o 图像发布的时候都持续产出了非常多好的案例和测试

    估计 Deepmind 想用他补上自己在图像和视频上的宣传路径,哥们这下这结起飞了

    当然,很荣幸老哥也关注了我#ai创造营#

  7. 一家公司最大的耻辱就是员工们都在做副业

    一家公司最大的耻辱就是员工们都在做副业
    不过很快就不会这样了
    因为公司的组织将开始粒子化
    从前牛马给公司打工 未来都是阿米巴组织
    公司只是一种资源参股而已

    以前人们需要协作,缺少大量的资源,要依靠公司来配齐
    未来单人都可以靠AI,公司的溢价能力降低了

    从前个体的溢价能力是很低很低的
    利益链条从LP开始,投资机构,创始人,管理者,中层,基层螺丝钉
    屁股决定收益分配链条的位置和比重
    如果独立出走,也不一定效率会比企业高
    所以需要组织这些人的掮客游走其中

    当组织扁平化之后 你就会发现
    擅长汇报沟通搞关系的人 可能很难发挥了
    从前资源协调很困难 总需要这些人“拼缝儿”当掮客
    但接下来3-5个人就是一个成型的组织
    一个AI就可以自动化做汇报 基于数字智能化系统就可以提问
    流程也会透明化 老板可以知晓到细节
    这些人很可能直接被泯灭了

    AI在打破以前的资源魔咒
    可怕的是 从前有钱人的那套模式要玩不转了
    他们也很可能因此快速返贫
    AI将重新分配社会资产

  8. 分享一个我常用的,避免我们跟ai对话时,走向信息茧房的神级prompt

    分享一个我常用的,避免我们跟ai对话时,走向信息茧房的神级prompt

    请你在每次回答我提出的问题或陈述时,都按照以下三个步骤来组织你的回答:
    1.【首要共识】首先,基于我提供的信息,给出一个直接、优质的回答或分析。

    2.【破壁视角】其次,必须为我提供一个与上述回答可能相悖的、对立的或来自完全不同角度的关键观点、理论或事实。请说明这个视角的合理性与价值。

    3.【认知检查】最后,向我提出一个反思性问题,旨在挑战我可能存在的潜在假设、思维定式或信息盲区。

    请确认你已理解此指令。我们开始。

  9. 这么多抽奖该如何抽呢?

    AI探索指南
    ListenHub 从来不打折,因为模型都是用顶级的,永远不降智 这次AI双11,给藏师傅的社群一个五折年费Pro会员支持 不赚钱,就和大家交个朋友 转发 @歸藏: 来了!藏师傅 & 30+ AI 产品终极优惠礼包! 在 17 日之前购买藏师傅的 AIGC 周刊,将会获得: 一年的 AIGC 周刊内以及所有往期 AIGC 周刊的存档内容; 30 多个知名 AI 产品的高额优惠券,一定有你想的产品; 30 多个 AI 产品的免费会员抽奖,总数超过了 1000 份100% 中奖。 下面是活动细节,也可以直接看长图👇:…
    这么多抽奖该如何抽呢?
    我会在 11.17 开始在会员群开启抽奖,每天会抽两到三个产品,争取可以一周全部抽完,由于活动就我一个人处理所以可能会比较慢,见谅,你订阅后就可以添加我微信进群,注意备注的格式,因为订阅的用户很多,不按备注格式备注的我可能会加不上。

    老会员可以享受这些福利吗?
    只要你现在是订阅会员,你的订阅状态还有效,都可以享受这些福利。

  10. ListenHub 从来不打折,因为模型都是用顶级的,永远不降智

    ListenHub 从来不打折,因为模型都是用顶级的,永远不降智
    这次AI双11,给藏师傅的社群一个五折年费Pro会员支持
    不赚钱,就和大家交个朋友

    转发 @歸藏: 来了!藏师傅 & 30+ AI 产品终极优惠礼包!

    在 17 日之前购买藏师傅的 AIGC 周刊,将会获得:

    一年的 AIGC 周刊内以及所有往期 AIGC 周刊的存档内容;

    30 多个知名 AI 产品的高额优惠券,一定有你想的产品;

    30 多个 AI 产品的免费会员抽奖,总数超过了 1000 份100% 中奖。

    下面是活动细节,也可以直接看长图👇:

    可能很多人还不了解藏师傅的 AIGC 周刊,我以前很少主动宣传。

    其实周刊已经从ChatGPT发布的那周开始更新稳定运营三年,其中前两年还是免费更新的,口碑和品质都有保证,很多看周刊长大的朋友都已经在行业站稳脚跟。

    订阅后可以获得,一份不只有新闻资讯的AIGC周刊包括:记录上周值得关注的AI领域主要发布;核心从业者需要关注的AI动态;涉及各个AI领域的优质内容;

    这次藏师傅拉到了几乎能够想到的所有国产 AI 产品和模型厂商,他们要么提供了非常高额的折扣,要么提供了相当数量的免费会员抽奖,要不两者都有,接下来介绍优惠顺便介绍一下产品。

    详细产品介绍可以看常长文:https://mp.weixin.qq.com/s/0AXFbGJdamiorfiHD6e7BQ

    有没有可能不花钱订阅周刊呢

    有的,兄弟有的,藏师傅的 AIGC 周刊开通了小报童的合伙人计划。

    如果你的朋友使用你的订阅链接订阅的话你会获得订阅价格 20% 的收益。推荐三个朋友基本上就可以免费看一年享受这些福利了

    你可以扫描二维码在页面下方的“分享有礼”部分获取带有 7 折优惠券的推荐链接

    那么在哪里订阅呢

    藏师傅的 AIGC 周刊现在有两个渠道。

    Quaily 适合海外用户,可以用美元和日元结算,也适合有 NewsLetter 阅读习惯的用户。

    小报童适合国内在微信阅读信息的用户,同时还有合伙人计划以及方便的国内支付渠道。

    最后是一些细节的Q&A

    这些优惠活动会从什么时候开始,如何领取?
    优惠码或者链接的领取地址,都会写在 11.17 号那一期的周刊最后面,这样大家可以选择自己喜欢的产品订阅,另外这些优惠码大部分都有时间限制,建议在 11.17 那一周购买完成,后面的话不保证还能用。