
这条帖子我会稍微多讲一点,Notion 为什么是当下所有 Agent 最好的上下文伴侣,远超 Google Drive、Obsidian 这些。
先说大家都知道的 Notion 是个直接对终端用户的产品, 因此它有一个完善的应用层。也就是,它的界面体验还不错。虽然很多人觉得 Notion 现在已经非常臃肿了,但你用过任何一款 Notion 的替代品就会发现,他们都在做 Notion 的子集。一旦深度使用,你就会发现他们缺乏某些 Notion 有但它没有的功能。 Notion 和当年的 Office 有点像——里面的每个按钮都对应着可能 5%-10% 的用户在用,没有任何功能是多余的, 区别只是你是否用得到。
然后,Notion 真正强大的是数据层。
其实早在 Notion 今年官方推出跨 Agent 记忆层之前,我就已经在用 Notion 做跨 Agent 记忆层了。
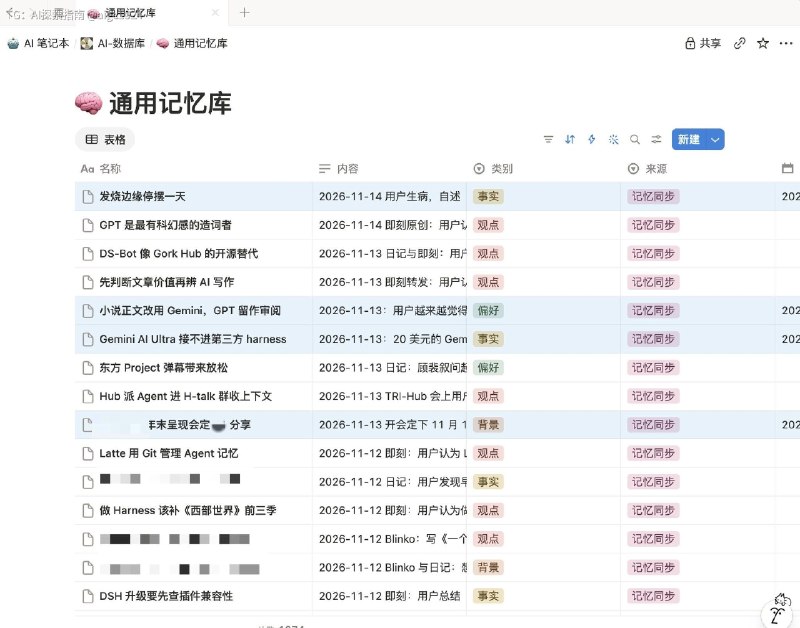
我在 Notion 里建了一个数据库,并设置了合理的增删改查规则, 然后把它连到我的 Codex、Workbuddy、Herme、DSH 以及任何支持 MCP 的 Agent 上,实现了跨 Agent 的记忆大一统。
我为什么用 Notion 做跨 Agent 记忆层,这就要说到我说 Notion 好用的第二点:
很少有人意识到,Notion 在数据层上其实是三层镜像——块结构、Markdown 文档和向量数据库, 并且三层镜像是秒级同步的。
当你接入 Notion 的 MCP 或做 Notion 的 API 开发的时候,会发现 Notion 可以对一个数据库进行字段筛选,可以进行关键词匹配搜索,还可以进行模糊搜索(实际是由 Notion 搜索 API 完成的向量搜索)。
取回数据的时候,可以精确的按字段取回,按块取回,还可以取回整个 Markdown 文件。
它几乎可以满足 Agent 对数据检索、存放和写入的所有需求。唯一的问就是 API 并发不高,不能真的当对外的 App 的数据库来用,但对个人使用来说绰绰有余,绝对碰不到限速。
你要使用开源框架在自己的环境里实现这一点, 光是性能消耗就不小,更别提三个版本数据之间的冲突管理。
而更秒的是,其他类似的开源方案,都不会在提供如此复杂的底层数据逻辑的前提下,还给你一个可以
