
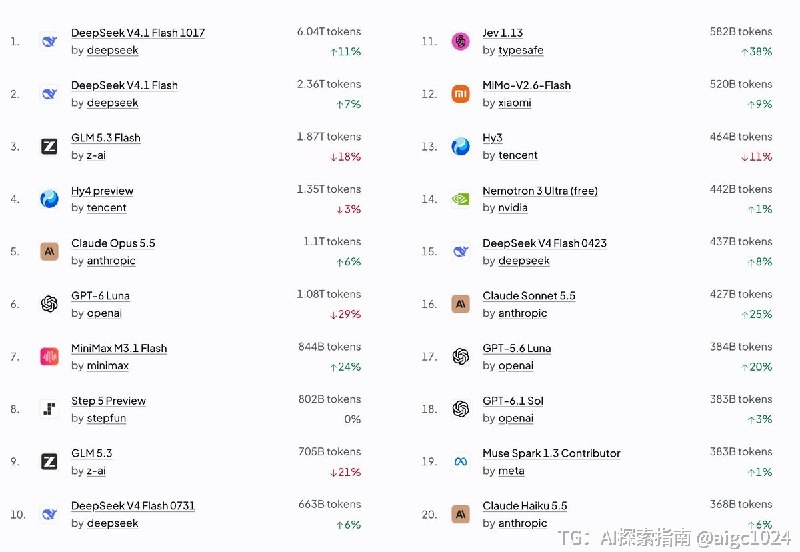
最大的推理算力平台OpenRouter 上最热的 DeepSeek模型,一天的量差不多一台 GB300(大约 600–700 万美元)就能扛;就算暗需求再乘 10,也到不了 1 亿美元算力。推理侧算力泡沫可能已经很不理智了。
翻了一下今天的Openrouter前20模型排名,加起来token吞吐量一共约21.2T token,如果按照同样的算法也就是满载约 4 台GB300。不过肯定也得考虑load balancing为峰值留下余量,比如再来6–8 台。
我个人并不懂算力硬件行业,有没有朋友解释一下。按照这样的模式来看,是否的确大量算力硬件还是被闭源模型推理和其他大厂训练模型吃掉了,应用使用开源模型消耗的算力远远支撑不起来庞大的算力机房行业?
@aigc1024
