AI探索指南

  1. 我的第一个产品:Ai播客生成器现在上线了!

    我的第一个产品:Ai播客生成器现在上线了!
    地址 https://mypodmates.com/
    这是一个你可以放入PDF或网页,自动生成双人对话的播客。你会看到有两个ai机器人在对你输入的内容进行聊天和讨论
    ✅核心内容:
    1.PDF分析:目前最高支持上传15-20页,5M以内的文件
    2.网页分析:上传网页链接,分析网页内容
    3.问题导向:可以输入你想重点聊的话题,比如放入一篇关于苹果简介的pdf文档,想重点关注苹果的生产地有哪些,播客内容会重点围绕这部分
    ❌待提升:
    1.目前只支持英文,多语言(包括中文)未来可能放入,主要看用户反馈,不知道中文需求多不多
    2.语音生成能力待提高:现在已经找到了更好的语音生成模型和解决方案,打算先收集一下用户反馈
    3.PDF更长的文件支持

    由于成本问题,我自己也是今年刚毕业,没什么储蓄,所以目前新用户免费赠送2次生成音频的额度,如果有更多的使用需求欢迎付费。关于产品的任何反馈或者疑问也欢迎向我提出

    最后感谢:
    GitHub开源库:https://github.com/meta-llama/llama-recipes
    感谢豆哥的社群技术支持@艾逗笔
    感谢飞哥的社群seo支持@哥飞
    还有感谢一些路上为我排忧解难的朋友,太多了就不一一艾特了。

  2. Bolt New 的产品和销售数据出来了!

    Bolt New 的产品和销售数据出来了!

    - 4周时间,从0到400万美金的 ARR!
    - 使用的 Claude API 消耗量每天翻倍式增长
    - 每周有十万人持续使用

    这种爆发式的增长,核心是因为它解决了一个一直以来的行业难题:
    Web 是世界上使用最广泛的平台,但开发者却无法在浏览器中构建 Web 应用。
    通过开创性的 WebContainers 技术和先进的 AI Coder 解决了这个问题。

    Bolt 认为未来人人都是开发者,十亿级别的开发者!
    一个现实的例子是,一位用户在 Upwork 上获得了 5000 美元的报价和 2-3 个月的时间来打造她的 MVP。几天后 Bolt 发布,她购买了 50 美元/月的计划,并在不到 2 周的时间内构建并推出了她的产品。

    引用链接:https://www.anthropic.com/customers/stackblitz

  3. 我回来了~

    我回来了~

    因为一连贯的原因,在去年11月脱离了AI这股浪潮
    甚至为了节约精力,主动切割了和这个行业的联系

    期间的忙碌和疲惫尚可切磋,但时不我与的感觉可真不好受
    沉舟侧畔千帆过,不是沉舟竟过千帆,而是千帆已过,你却陷于沉舟

    好在还有病树床头万木春的下半场,还能有杯酒长精神的意气
    重新入学,重新开始,马丁3.0

    顺便,谁能告诉我,最近一年,AI最大的进展是啥?
    除了字节杀入了几乎所有领域以外(这一年里最放不下我的就是字节的猎头了)

  4. 字节的通用图像编辑模型 SeedEdit 发布了

    字节的通用图像编辑模型 SeedEdit 发布了。之所以说是编辑模型,因为可以基于刚刚生成的图片改图,包括修图、换装、美化、转化风格、在指定区域添加删除元素等各类编辑操作。

    跟普通的编辑最大的区别是自然语言交流。我试用了一下,相当顺畅。自然语言驱动的编辑在业内还是少见的,尤其考虑到豆包本就是目前最有影响力的 AI 通用产品之一,这次可能会真的影响很多人设计的方式。

    我之前用 Midjourney,跟很多朋友一样,急迫需要连贯性一致性的绘制形式,可以满足长篇的连贯的设计表达,比如做出有同个主人公的漫画、同类海报的不同呈现等等。

    在豆包的官网 doubao.com 能体验到,大家可以试试看。

  5. 过去一年半做了多个AI项目,有简单有复杂的,有面向超大规模的小白用户,也有面向垂类人群,其中prompt是非常核心的要素,也是大家在做项目时绕不开的逻辑

    过去一年半做了多个AI项目,有简单有复杂的,有面向超大规模的小白用户,也有面向垂类人群,其中prompt是非常核心的要素,也是大家在做项目时绕不开的逻辑。在此总结了做prompt方案设计的经验和教训

    核心结论:

    GenAI带来应用新范式,支持通过prompt生成优质的个性化结果,但大众用户不想打开键盘,也不知道填什么prompt,所以需要在保证最终效果的前提下,尽可能通过低成本的表达方式来获得用户的意图。

    对话式交互是未来,但目前还无法取代传统图形化交互。

    1. 交互:不要让prompt变成操作阻力

    - 非必要,勿填prompt,让用户多填一个字,都是对用户规模和转化率的巨大折损;

    - 如果有prompt的效果更好,那么把prompt做成选填,让专业用户有选择,又不影响小白用户的使用路径;或者首次不填,快速预览结果,后续深度使用再填

    - 如果必须填,尽可能填用户不需要额外思考的,否则用户一思考,数据就掉

    - 通过推荐词降低输入门槛,并保证对prompt的响应,避免拔高用户预期后但结果又不符预期

    2. 信息:通过算法、或信息授权方式来获取用户意图和context背景信息,而不一定要手动输入

    3. 流程:把prompt填写留在最后一步,让用户先完成简单的熟悉的操作,增加沉没成本

    4. 生态:少数偏专业用户的prompt,沉淀在端内成为模板流转,服务更广大小白用户一键套用和二创。对工具产品来说,飞轮逻辑可能比漏斗逻辑更重要,因为效果比效率更重要。要站在整个平台,整个大生态去思考,从更长周期看对用户的价值,对平台的增长和商业化的价值

    提示:

    - 我是在一个已有的大体量的移动互联网产品中融入AI能力,用户的习惯、预期,以及业务指标护栏都会对新方案的设计做限制

    - 以上交互案例是表象,数据也是表象,仅供参考,不一定能复用到其他产品

    - 最重要的是,你的用户是谁,他们的需求是什么,你的产品当前处于什么领域、什么阶段,如何更好的满足他们的需求

  6. 刚刚国内的一个做网文的客户看了下效果,表示满意

    刚刚国内的一个做网文的客户看了下效果,表示满意。
    然后,他们公司把这个程序买下来了……
    有点夸张,但是真的……
    感谢AI赏饭吃,本周加鸡腿。

    把我整理出来的prompt分享给大家吧:

    视角:视角为上帝视角,读者知道每个人物的行为动机,和心里活动。

    读者群体:15到25岁的少女或者女性群体,晋江网站的读者

    文风:幽默风趣,俏皮,充满着女性的可爱和柔美

    段落风格:多换行,少用长句子,多用对话推进情节,避免过多的解释

    情节:可以按照你的理解增加新的故事情节,如果你觉得当前的情节不足以支撑过多的字数情节,你可以按照你的理解来丰富内容,甚至创造新的支线剧情

    避免重复:不仅避免相同的句子、情节、对话、场景描述和情感表达,还要确保任何重复的信息都能有所不同地呈现,以增加故事层次感,减少冗余感。

    剧情快速推进:在每一章或每一个重要场景中,确保有推动情节发展的事件或决策。减少缓慢的内心独白或背景介绍,通过角色的行动和对话来展示故事关键要素。

    连贯无断层:每个情节的承接点应自然流畅,从一个场景进入下一个场景时,合理描述事件或情绪的变化,避免突然的情节转折让读者感到突兀。

    起承转合清晰:在每个段落或章节中,设置小的高潮和转折,并为主要情节做好铺垫,使读者能够循序渐进地融入情节发展。

    无意义的对话和场景减少:确保每一句对话、每一个场景都具有明确的情节功能(推动情节或展现角色性格)。无实质内容的对话避免出现,每一场景的描写都应紧扣情节或人物发展。

    多换行、少用长句:增加视觉上的“喘息”空间,使用短句增强节奏感。在描述情绪时用简练的词汇,不冗长,保证阅读时顺畅。

    语言流畅自然:选用简洁明了的现代用词,减少过多修饰,避免用过于冗杂或华丽的语言,特别是在紧张的情节或情绪描写中。

    情感和情绪的准确表达:用更直接、精准的方式表达人物情绪,避免含糊或过于抽象的情感表述。情感逐步递进,增加人物情感的张力。

    视觉与情境感的渲染:在环境描写中,用简洁而富有画面的文字,将场景“画”出来,使读者更容易融入。

  7. Anthropic CEO 接受了 Lex Fridman 长达五个小时的访谈

    Anthropic CEO 接受了 Lex Fridman 长达五个小时的访谈。里面的信息非常丰富,老哥真的实诚。

    整理了一下笔记,内容包括:

    - AGI 何时到来
    - Scaling Hypothesis的定义以及是否结束
    - Anthropic的产品策略
    - LLM可解释性研究
    - AI发展时间线的介绍和预测

    长文内容:https://mp.weixin.qq.com/s/OClP9QhQUGAp5DHZ9zh3jQ

  8. 用 Gemini 拉片是真的方便

    用 Gemini 拉片是真的方便。

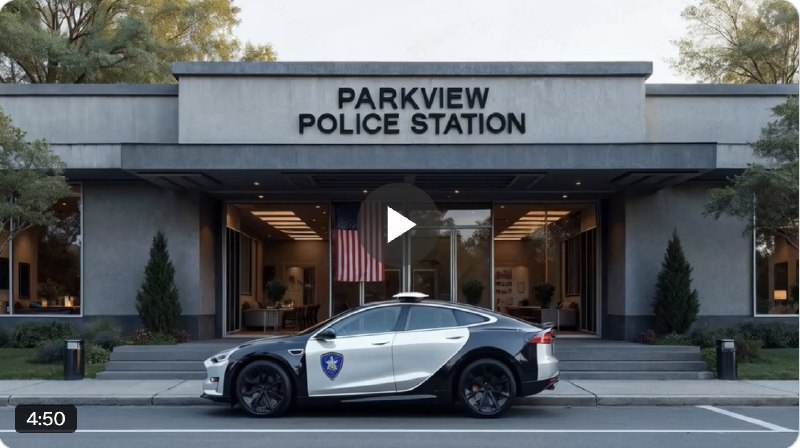
    用 Gemini 详细分析前几天那个机器人艺术家谋杀的 AI 视频每个分镜的画面内容和对应的台词。

    把表格下下来,再搭配对应分镜的一个视频就拆解完了。

    如果 Gemini 以后要是能自动把每个分镜剪出来就更好了。

    不过 Gemini 分析完整视频会报错,我剪到 1 分钟就还行。