AI探索指南

  1. ◆使用真实世界的网页内容来训练开放源代码的多模态大语言模型

    AI探索指南
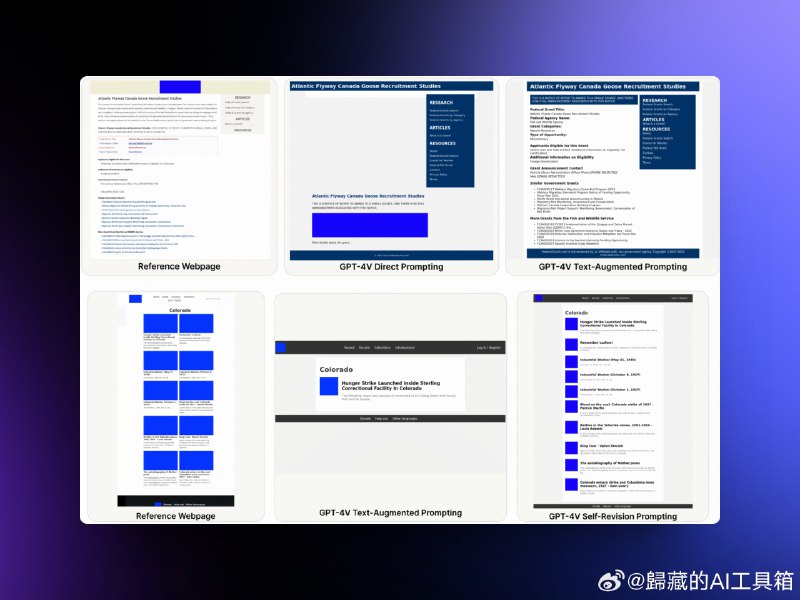
    微软和 Deepmind 的一篇论文探讨利用 LLM 从设计生成代码,这个实践经验对想做相关 Design2Code 工具的很有参考性。#ai# 我整理了一下里面对我们自己通过 LLM 生成代码可能有用的提示词和经验。感兴趣可以看看。 他们发现第一次生成的网页通常质量不太行,但是第二次增强提示之后 GPT-4V 生成网页代码质量明显变好,下面是对应提示词。 第一次代码生成提示词: 假设你是一位精通HTML和CSS的网页开发专家。当用户提供一张网页的截图给你时,你的任务是创建一个HTML文件。这个文…
    ◆使用真实世界的网页内容来训练开放源代码的多模态大语言模型。我们的初步实验表明,直接在真实的网页上进行训练存在挑战,因为这些网页往往内容繁杂、数据杂乱。未来的研究可能会探索数据清洗和优化的方法,以实现更稳定有效的训练过程。

    ◆超越传统的截图输入方式,例如,尝试使用前端设计师的Figma框架或手绘草图作为测试输入。这种方法的扩展还需要我们仔细地重新设计评估体系。

    ◆将研究范围从静态网页扩展到动态网页。这意味着评估过程需要考虑网页的交互功能,而不仅仅是视觉效果的相似性。

    项目地址:网页链接

  2. 微软和 Deepmind 的一篇论文探讨利用 LLM 从设计生成代码,这个实践经验对想做相关 Design2Code 工具的很有参考性

    微软和 Deepmind 的一篇论文探讨利用 LLM 从设计生成代码,这个实践经验对想做相关 Design2Code 工具的很有参考性。#ai#

    我整理了一下里面对我们自己通过 LLM 生成代码可能有用的提示词和经验。感兴趣可以看看。

    他们发现第一次生成的网页通常质量不太行,但是第二次增强提示之后 GPT-4V 生成网页代码质量明显变好,下面是对应提示词。

    第一次代码生成提示词:

    假设你是一位精通HTML和CSS的网页开发专家。当用户提供一张网页的截图给你时,你的任务是创建一个HTML文件。这个文件需要用HTML和CSS编码来精确还原截图中的网站设计。重要的是,所有的CSS样式代码都要直接写在HTML文件里,而不是链接到其他文件。

    如果原网页中有图片,你可以用一个名为"rick.jpg"的图片作为所有图片的替代品。即便网页中的某些图片已经被蓝色的矩形占位符替代了,你同样需要使用"rick.jpg"作为这些位置的图片。记住,你的HTML文件中不应包含任何外部文件的链接。

    此外,这个任务不需要你使用JavaScript编写动态交互脚本。你的重点应该放在复原网页元素的大小、文本、位置、颜色以及整体布局上。最终,你需要提供完整的HTML文件内容,其中包含了所有必要的CSS样式代码。

    增强提示词:

    作为一名擅长HTML和CSS的网页开发高手,你面临的挑战是修改一个已有的HTML文件。这个文件是用来构建一个网页的,但它目前有一些缺失或错误的部分,使得它与原网页有所不同。我将向你展示我想要创建的网页原型和目前HTML实现的网页效果。同时,我也会提供你我想在网页中包含的所有文本。

    你的任务是仔细比较这两个网页,并根据提供的文本内容,修改原始的HTML代码。你需要确保新的实现在外观上与参考网页完全一致。在编码时,要保证HTML代码语法正确,能够生成一个结构完整的网页。对于需要图片的地方,你可以暂时用一个名为"rick.jpg"的图片作为占位符。

    在进行代码修订时,请特别注意网页元素的大小、文本内容、位置布局和颜色等方面,确保最终的布局和原网页高度相似。完成后,请直接提供新修订的HTML文件内容,无需附加任何解释。

    LLM 通过设计生成代码未来重点和研究方向:

    ◆为多模态大语言模型开发更有效的提示技巧,尤其是在处理复杂网页设计时,例如通过分步骤生成网页的不同部分。

  3. Open AI 公布了和马斯克的邮件往来,来应对马斯克的诉讼,终于又在 Open AI 的文件中看到了Ilya的名字

    Open AI 公布了和马斯克的邮件往来,来应对马斯克的诉讼,终于又在 Open AI 的文件中看到了Ilya的名字。看来还是没有完全闹掰。#ai#

    我大致总结了一下声明的内容,里面邮件被涂掉的内容才是最重要的。

    声明总结:

    OpenAI发布了一篇博客,详细介绍了其与埃隆·马斯克(Elon Musk)的关系以及公司的使命。OpenAI的使命是确保人工通用智能(AGI)惠及全人类,这不仅包括构建安全、有益的AGI,还包括帮助创造广泛分布的利益。OpenAI意识到,构建AGI将需要比最初想象的更多资源。马斯克建议宣布对OpenAI的初始10亿美元资金承诺。自2015年底成立以来,该非营利组织从马斯克那里筹集了不到4500万美元,从其他捐赠者那里筹集了超过9000万美元。

    在讨论为了进一步使命而采取的营利性结构时,马斯克希望OpenAI与特斯拉合并,或者他希望拥有完全控制权。最终,马斯克离开了OpenAI,表示需要有一个能与谷歌/DeepMind竞争的相关对手,并且他将自己去做。2017年底,OpenAI和马斯克决定下一步是创建一个营利性实体。马斯克希望拥有多数股权、最初的董事会控制权,并担任CEO。在这些讨论中,他暂停了资金支持。

    OpenAI强调,他们通过构建广泛可用的有益工具来推进使命,使技术在赋能人们和改善他们的日常生活方面广泛可用,包括通过开源贡献。例如,阿尔巴尼亚利用OpenAI的工具加速其加入欧盟的进程长达5.5年;Digital Green通过在OpenAI的基础上构建,帮助肯尼亚和印度的农民收入提高了100倍;罗德岛最大的医疗保健提供者Lifespan使用GPT-4简化其手术同意书,从大学阅读级别简化到六年级水平;冰岛使用GPT-4保护冰岛语言。

    马斯克理解使命并不意味着开源AGI。随着OpenAI接近构建AI的目标,他们开始变得不那么开放。OpenAI表示,他们对与曾经深受尊敬、激励他们设定更高目标的人——马斯克的关系走到这一步感到遗憾,尽管他后来告诉他们他们会失败,启动了一个竞争对手,然后在他们开始朝着OpenAI的使命取得有意义的进展时起诉他们。OpenAI专注于推进其使命,并且还有很长的路要走。随着他们继续改进工具,他们兴奋地部署这些系统,以便赋能每个人。

    全文:网页链接

  4. 今天和Claude Opus一起工作了一天,提效非常明显:

    今天和Claude Opus一起工作了一天,提效非常明显:

    1. 数据分析场景:把需要查询的几张表的表结构和select * from xxx limit 10的结果发给Claude,说一下几张表的关联关系,然后说我想要查询xxx,让Claude直接给我写sql,然后无脑粘贴进bi平台查询,基本上嵌套关系在三层以内的sql都不会出错。另外把数据分析的结果发给Claude,让它给我补充分析背景和分析结论,非常好用,我只需再补充一些后续产品todo即可。不方便的地方是没有code interpreter所以不能像在ChatGPT里那样直接帮我把图表也给画了。

    2. PRD场景:直接把实习生写的PRD复制粘贴发给Claude,让它挑刺,给出来的建议非常的客观具体详实,是一个比我好很多的产品mentor。

    补充: Claude模型能力和GPT4比哪个更强不好评价,但long context无损压缩的用户体验好太多了。自从OpenAI devday搞了Assistant api之后,在chatgpt上第n轮交互不一定会把前几轮的Query和answer放到上下文。这就造成,我如果把所有背景在一轮交互里都讲清楚了,gpt4很完美,但如果问followup questions它就表现的很垃圾。我坚信目前这些在工程上carefully arrange context window来节约成本的都是雕花行为,long context才是新时代的摩尔定律。

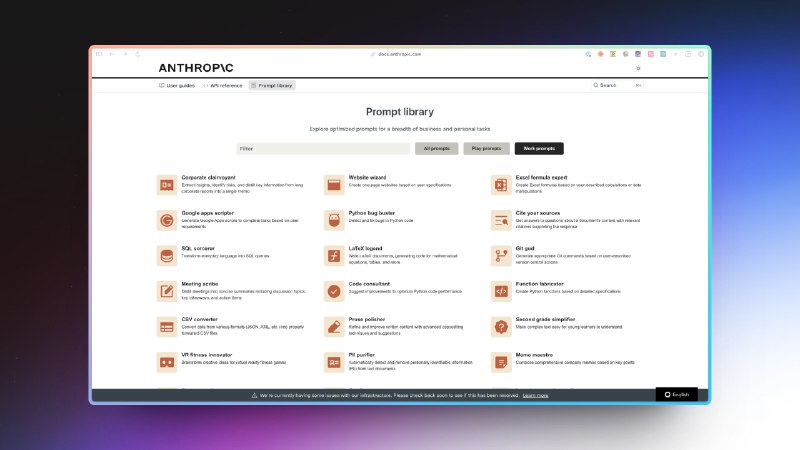
  5. 伴随 Claude 3 推出的还有一个提示词库,里面有Anthropic提供的非常多的示例提示词,方便开发者和用户尝试

    伴随 Claude 3 推出的还有一个提示词库,里面有Anthropic提供的非常多的示例提示词,方便开发者和用户尝试。

    详情页还给出了对应提示词的示例回答和 API,可以去看看学一下 Claude 的提示词写法。

    这里访问:https://docs.anthropic.com/claude/prompt-library

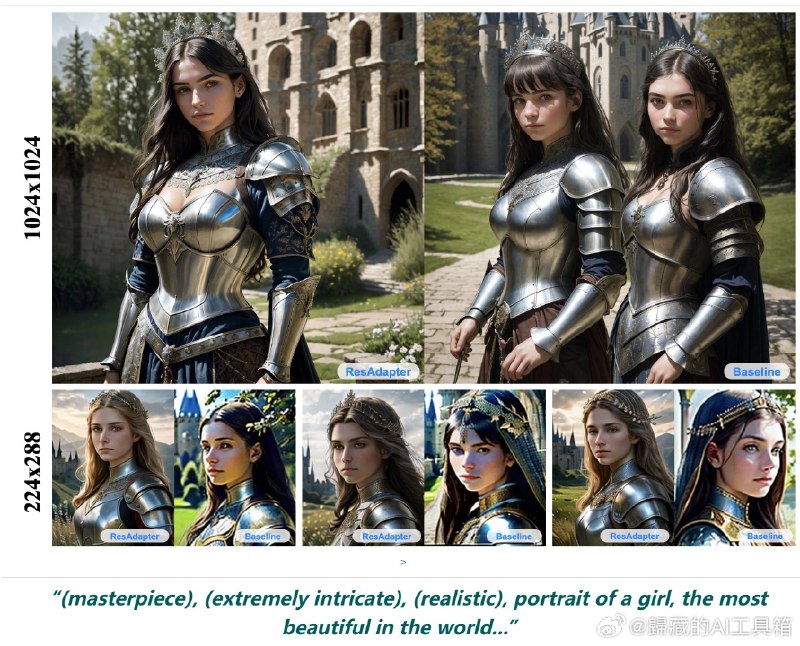
  6. 字节发布ResAdapter,可以解决SD生成超大图片和非训练分辨率图片时的肢体异常以及画面崩坏问题

    字节发布ResAdapter,可以解决SD生成超大图片和非训练分辨率图片时的肢体异常以及画面崩坏问题。#ai#

    同时可以与现有的IPadapter以及Controlnet模型兼容。

    项目简介:

    近期,像Stable Diffusion这样的文本到图像模型和DreamBooth、LoRA等个性化技术的发展,让我们能够创造出既高质量又充满创意的图像。但这些技术在生成超出它们训练时所用分辨率的图像时,往往会受到限制。

    为了突破这一难题,我们推出了一种新型工具——分辨率适配器(ResAdapter)。

    它是一种专门为扩散模型(比如Stable Diffusion和个性化模型)设计的适配器,能够生成任何分辨率和长宽比的图像。与其它多分辨率生成方法不同,ResAdapter能直接生成动态分辨率的图像,而不是在后期处理中调整静态分辨率的图像。这种方法使得图像处理变得更加高效,避免了重复的去噪步骤和复杂的后期处理流程,显著缩短了处理时间。

    在不包含任何训练领域风格信息的情况下,ResAdapter利用广泛的分辨率先验,即使只有0.5M的容量,也能为个性化扩散模型生成不同于原训练领域的高分辨率图像,同时保持原有风格。

    大量实验显示,ResAdapter在提高分辨率方面与扩散模型配合得天衣无缝。此外,更多的实验表明,ResAdapter可以与ControlNet、IP-Adapter和LCM-LoRA等其他模块兼容,适用于创建不同分辨率的图像,也可以整合进如ElasticDiffusion这样的多分辨率模型中,高效生成更高清晰度的图像。

    项目页面:网页链接

  7. 今晚斗胆在清华人工智能联盟群里diss了一位前辈 主要他show的那个机器人我真觉得很low 完全没解释环境感知和精准导航 所以demo看着很灵 其实无法验真 就顺口说了我的方案 毕竟行业巨头已经采纳了 所以怎么说.. 长江后浪推前浪吧..

    今晚斗胆在清华人工智能联盟群里diss了一位前辈 主要他show的那个机器人我真觉得很low 完全没解释环境感知和精准导航 所以demo看着很灵 其实无法验真 就顺口说了我的方案 毕竟行业巨头已经采纳了 所以怎么说.. 长江后浪推前浪吧..

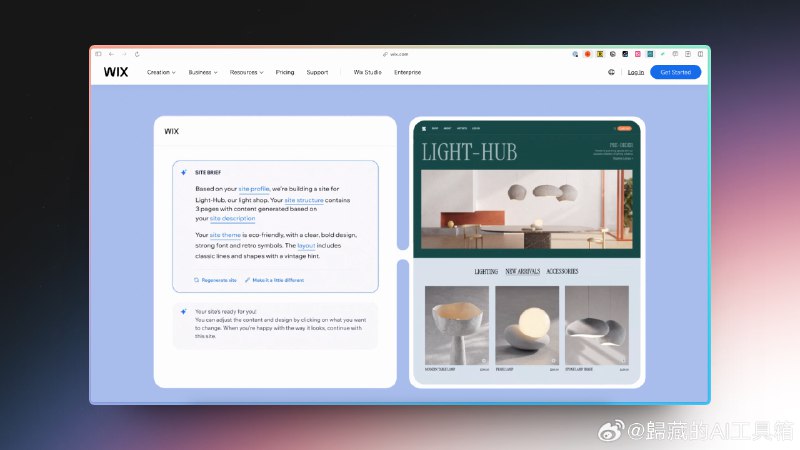
  8. 无代码网站构建工具 WIX 推出了他们的人工智能建站工具,看起来比 Framer 的稍微好点

    无代码网站构建工具 WIX 推出了他们的人工智能建站工具,看起来比 Framer 的稍微好点。#ai#

    它利用人工智能技术帮助用户在几分钟内创建网站。这个工具通过对话界面与用户互动,根据用户的需求快速生成高质量的网站。

    用户可以灵活地调整网站的主题、布局、图片和文本,直到满意为止。

    了解更多:网页链接

  9. 最近很多朋友说找不到封面图片的时候就去 Catjourney 看看,这也是我们不强调提示词而是强调图片的原因.#ai画图#

    最近很多朋友说找不到封面图片的时候就去 Catjourney 看看,这也是我们不强调提示词而是强调图片的原因.#ai画图#

    不是每个人都有 MJ 账号的,很多时候就是找张好看的图片用就行,没必要自己去生成。

    这几天 Catjourney 也在更新,下面是最近更新的图片,欢迎有需求就来看看。

    这里访问:catjourney.life
    006KpAl0ly1hng4kp0a6pj32ko29kb2g.jpg
    8.3 MB

  10. ◆灵活的文本编码器:通过在推理阶段移除内存密集型的 T5 文本编码器 (参数量高达 47 亿),SD3 的内存占用可以大幅降低,而性能损失却很小

    AI探索指南
    Stability AI 发布了他们最强的图片生成模型 Stable Diffusion 3 的技术报告,披露了 SD3 的更多细节。#ai##ai画图# 据他们所说,SD3 在排版质量、美学质量和提示词理解上超过了目前所有的开源模型和商业模型,是目前最强的图片生成模型。 技术报告要点如下: ◆根据人类偏好评估,SD3 在排版质量和对提示的理解程度上,均优于目前最先进的文本生成图像系统,例如 DALL·E 3、Midjourney v6 和 Ideogram v1。 ◆提出了新的多模态扩散 Transformer…
    ◆灵活的文本编码器:通过在推理阶段移除内存密集型的 T5 文本编码器 (参数量高达 47 亿),SD3 的内存占用可以大幅降低,而性能损失却很小。

    详细介绍:网页链接

  11. Stability AI 发布了他们最强的图片生成模型 Stable Diffusion 3 的技术报告,披露了 SD3 的更多细节

    Stability AI 发布了他们最强的图片生成模型 Stable Diffusion 3 的技术报告,披露了 SD3 的更多细节。#ai##ai画图#

    据他们所说,SD3 在排版质量、美学质量和提示词理解上超过了目前所有的开源模型和商业模型,是目前最强的图片生成模型。

    技术报告要点如下:

    ◆根据人类偏好评估,SD3 在排版质量和对提示的理解程度上,均优于目前最先进的文本生成图像系统,例如 DALL·E 3、Midjourney v6 和 Ideogram v1。

    ◆提出了新的多模态扩散 Transformer (Multimodal Diffusion Transformer,简称 MMDiT) 架构,其使用独立的权重集分别表示图像和语言。与 SD3 的先前版本相比,该架构改善了系统对文本的理解能力和拼写能力。

    ◆SD3 8B 大小的模型可以在 GTX 4090 24G 显存上运行。

    ◆SD3 将发布多个参数规模不等的模型方便在消费级硬件上运行,参数规模从 800M 到 8B 。

    ◆SD3 架构以 Diffusion Transformer (简称"DiT",参见 Peebles & Xie,2023)为基础。鉴于文本嵌入和图像嵌入在概念上存在较大差异,我们为这两种模态使用了独立的权重集。

    ◆通过这种方法,信息得以在图像 Token 和文本 Token 之间流动,从而提高了模型生成结果的整体理解力和排版质量。我们在论文中还讨论了如何轻松地将这一架构扩展至视频等多模态场景。

    ◆SD3 采用了矫正流 (Rectified Flow,简称 RF) 的公式 (Liu et al.,2022;Albergo & Vanden-Eijnden,2022;Lipman et al.,2023),在训练过程中,数据和噪声被连接在一条线性轨迹上。这导致了更直的推理路径,从而可以使用更少的步骤进行采样。

    ◆扩展矫正流 Transformer 模型:使用重新加权的 RF 公式和 MMDiT 主干网络,对文本到图像的合成任务开展了模型扩展研究。我们训练了一系列模型,其规模从 15 个 。Transformer 块 (4.5 亿参数) 到 38 个块 (80 亿参数) 不等。

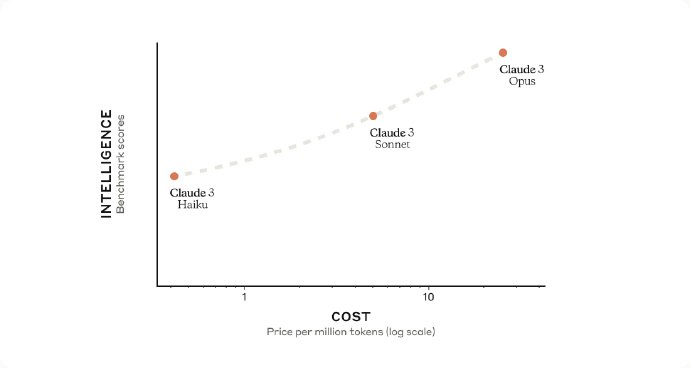
  12. Anthropic 推出 Claude 3 ,包括 Claude 3 Haiku、Claude 3 Sonnet 和 Claude 3 Opus 3个版本,能力从小到大

    Anthropic 推出 Claude 3 ,包括 Claude 3 Haiku、Claude 3 Sonnet 和 Claude 3 Opus 3个版本,能力从小到大。

    Opus 和 Sonnet 现可在 claude.ai 和 Claude API 中使用,Haiku 即将推出。

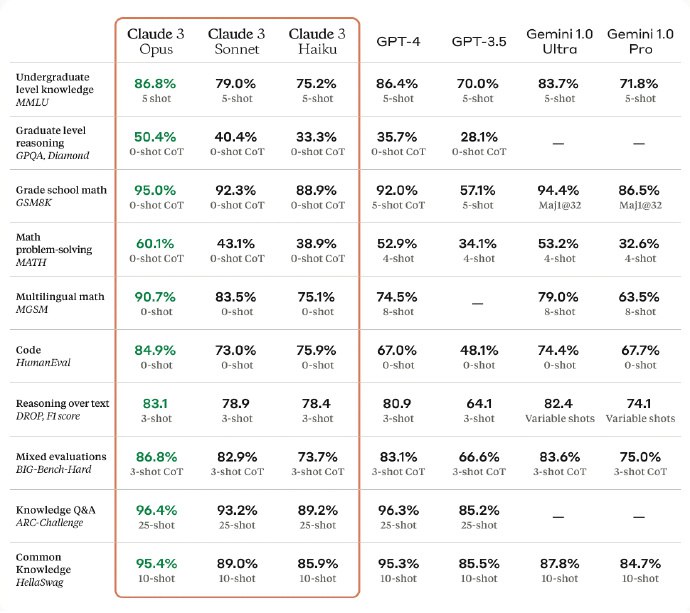
    能力方面,见图2。

    速度方面:

    - Haiku 是市场上同类智能产品中速度最快、性价比最高的模型。它可以在三秒内读取 arXiv 上一篇信息和数据密集的研究论文(约 10k tokens),并附带图表和图形。

    - Sonnet 的速度比 Claude 2 和 Claude 2.1 快 2 倍,而且智能水平更高。它擅长处理要求快速响应的任务,如知识检索或销售自动化。Opus 的速度与 Claude 2 和 2.1 类似,但智能水平更高。

    vision 能力

    - Claude 3 型号具有与其他领先模型同等的复杂 vision 功能。它们可以处理各种 vision 格式,包括照片、图表、图形和技术图表。(图3)

    准确性:

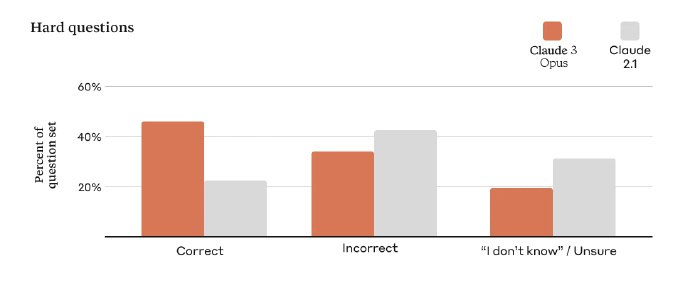
    - 与 Claude 2.1 相比,Opus 在这些具有挑战性的开放式问题上的准确率(或正确答案)提高了两倍,同时也减少了错误答案。(图4) 另外,Claude 3 模型还将很快启用引文。

    上下文能力:

    Claude 3 系列模型在推出之初将提供 20 万个上下文窗口。不过,所有三种模型都能接受超过 100 万个 tokens 的输入,Anthropic 会向特定用户提供。