AI探索指南

  1. 开通了Claude Pro尝试了Claude 3 Opus,我拿他主要做了三个测试,确实很强

    开通了Claude Pro尝试了Claude 3 Opus,我拿他主要做了三个测试,确实很强。

    首先用宝玉的翻译提示词尝试了一下复杂英文内容的翻译,Claude 比GPT-4做的好,他会主动对没有排版的内容进行分段和排版时其更加的易读。
    之前GPT-4从来没有主动进行过这种操作。翻译结果也比GPT-4更加顺畅。

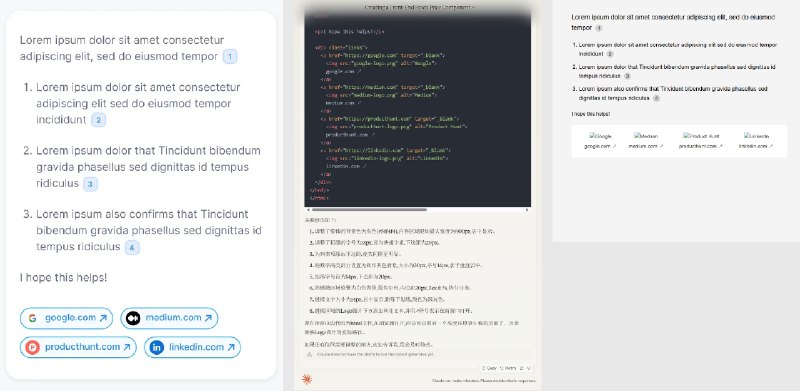
    然后我用一个样式比较复杂的设计稿组件截图让他还原,在我强调了需要还原样式之后,他对样式细节处理的非常好,相当接近设计稿了,GPT-4之前一直搞不定设计稿细节。

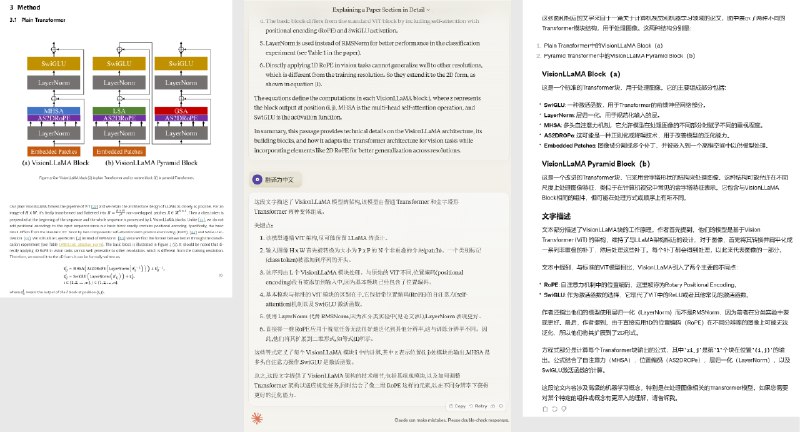
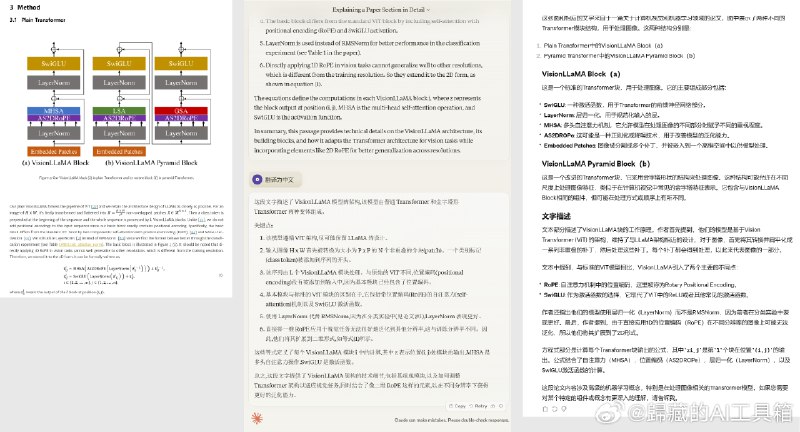
    最后是多模态,我找了一个论文的一部分让他解读,分析的也很清楚,不过给出的信息没有GPT-4丰富,感觉多模态还需要加油。

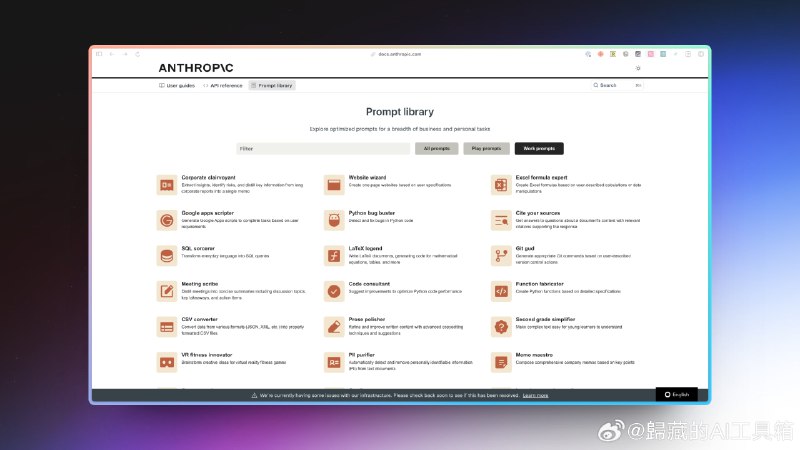
  2. 伴随 Claude 3 推出的还有一个提示词库,里面有Anthropic提供的非常多的示例提示词,方便开发者和用户尝试

    伴随 Claude 3 推出的还有一个提示词库,里面有Anthropic提供的非常多的示例提示词,方便开发者和用户尝试。#ai##claude3#

    详情页还给出了对应提示词的示例回答和 API,可以去看看学一下 Claude 的提示词写法。

    这里访问:网页链接

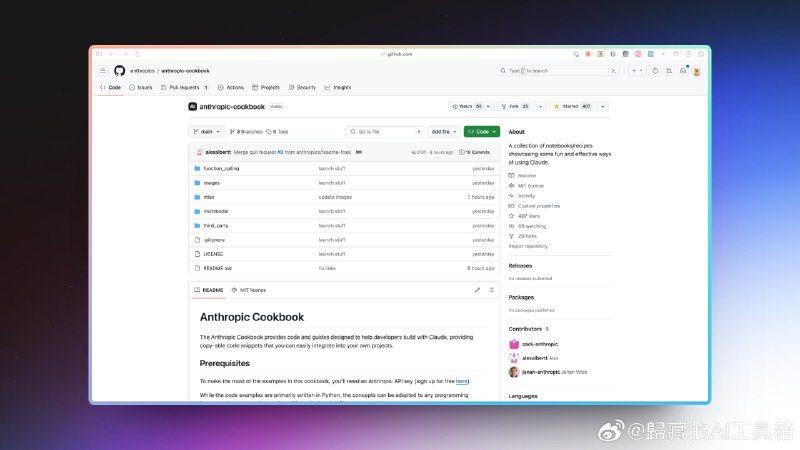
  3. 除了提示词库之外他们还更新了 Anthropic Cookbook 可以让你使用 Claude 3 新的能力的代码和提示词例子:#ai##claude3#

    除了提示词库之外他们还更新了 Anthropic Cookbook 可以让你使用 Claude 3 新的能力的代码和提示词例子:#ai##claude3#

    在Claude中使用图像:这本食谱提供了关于如何开始使用图像以及确保图像具有最高质量性能的最佳实践技巧。

    自动评估:了解如何使用Claude来自动化提示评估过程。

    启用 JSON 模式:通过这本快速简便的食谱,确保始终获得 JSON。

    使用Claude创建内容审查过滤器:了解如何使用Claude为您的应用程序创建内容审查过滤器。

    这里使用:网页链接

  4. Stability AI 太惨了老是发消息被忽略,昨晚他们还跟Tripo AI 联合推出了 TripoSR 3D 生成模型,可以在不到 1 秒的时间里生成高质量的 3D 模型

    Stability AI 太惨了老是发消息被忽略,昨晚他们还跟Tripo AI 联合推出了 TripoSR 3D 生成模型,可以在不到 1 秒的时间里生成高质量的 3D 模型。#ai#

    TripoSR的推理只需要极低的算力,甚至都不需要 GPU,极大的降低了生产成本。权重模型允许商业化使用。

    性能:TripoSR可以在其他模型所需时间的一小部分时间内创建详细的3D模型。在Nvidia A100上进行测试时,它可以在大约0.5秒内生成初步质量的3D输出(纹理网格),表现优于其他开放的图像到3D模型,如OpenLRM。

    技术细节:训练数据准备包括多种数据渲染技术,更贴近真实世界中图像的分布,显著提高了模型的泛化能力。精心策划了一个CC-BY,即Objaverse数据集的高质量子集,用于训练数据。在模型方面,还对基础LRM模型进行了多项技术改进,包括通道数优化、蒙版监督和更高效的裁剪渲染策略。

    详细信息:网页链接歸藏的AI工具箱的微博视频

  5. 尝试了一下Dashtoon 这个 AI 漫画生成应用,发现做的挺成熟的,该有的功能都有,可以一次性生成也给了充分的编辑和自定义空间

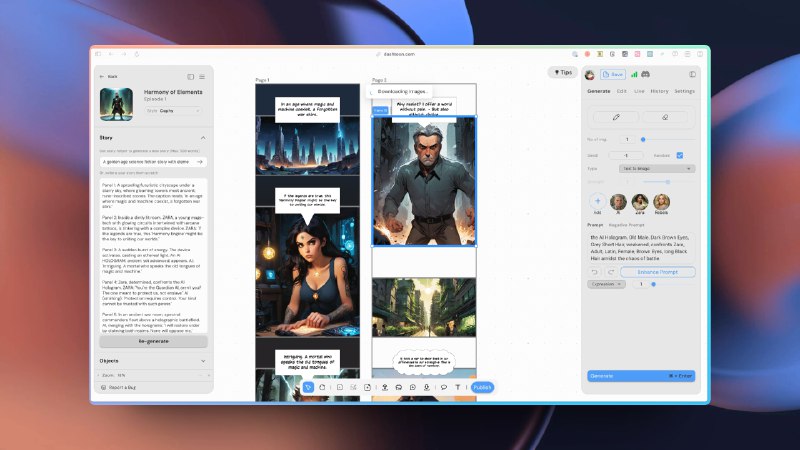
    尝试了一下Dashtoon 这个 AI 漫画生成应用,发现做的挺成熟的,该有的功能都有,可以一次性生成也给了充分的编辑和自定义空间。

    国内的很多小说视频还是手工用各种 AI 工具拼凑的阶段,可以借鉴一下这个产品的实现方式,是个机会。

    他的人物一致性是通过内置的非常多人物 Lora 实现的,目前来看这确实是最稳定的方案。

    具体的生成逻辑是你输入大概的故事描述,他会为你生成很多个场景描述,你修改确认之后就会根据文字场景描述生成图片和漫画的对话。

    这里尝试:https://dashtoon.com

  6. 开通了Claude Pro尝试了Claude 3 Opus,我拿他主要做了三个测试,确实很强

    开通了Claude Pro尝试了Claude 3 Opus,我拿他主要做了三个测试,确实很强。#claude3##ai#

    首先用宝玉的翻译提示词尝试了一下复杂英文内容的翻译,Claude 比GPT-4做的好,他会主动对没有排版的内容进行分段和排版时其更加的易读。
    之前GPT-4从来没有主动进行过这种操作。翻译结果也比GPT-4更加顺畅。

    然后我用一个样式比较复杂的设计稿组件截图让他还原,在我强调了需要还原样式之后,他对样式细节处理的非常好,相当接近设计稿了,GPT-4之前一直搞不定设计稿细节。

    最后是多模态,我找了一个论文的一部分让他解读,分析的也很清楚,不过给出的信息没有GPT-4丰富,感觉多模态还需要加油。

  7. [解读] 马斯克起诉Sam Altman、Greg Brockman及相关OpenAI公司实体

    [解读] 马斯克起诉Sam Altman、Greg Brockman及相关OpenAI公司实体

    /imagine Donating to a non-profit whose asserted mission is to protect the Amzaon rainforest, but then the non-profit creates a for-proft Amazonian logging company that uses the fruits of the donations to clear the rainforest. That is the story of OpenAI, Inc.
    马斯克起诉Sam、Greg及OAI,到底怎么回事?事情要从混乱善良的Musk创办中立善良的OpenAI, Inc.讲起...关于此案,整理了可能是全网最完整的complaint解读,万字长文带您了解始末。

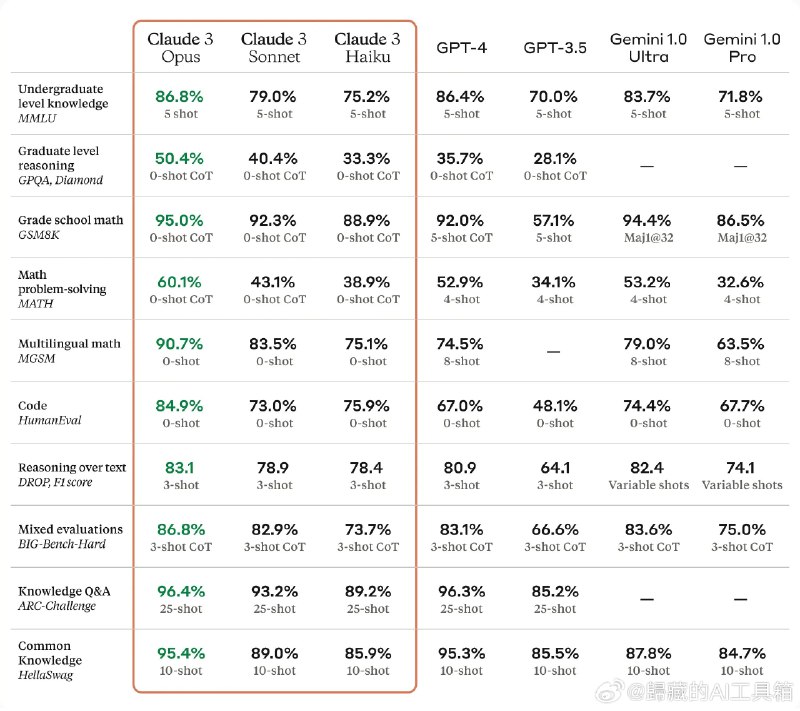
  8. Anthropic发布了Claude 3模型,当然,从测试结果来看比GPT-4强很多

    Anthropic发布了Claude 3模型,当然,从测试结果来看比GPT-4强很多。#ai#

    该系列包括三种最先进的型号(按功能升序排列):Claude 3 Haiku、Claude 3 Sonnet 和 Claude 3 Opus。支持100万Token上下文。

    你现在可以在Claude开通Claude Pro使用最强大的Claude 3 Opus模型。

    详细介绍:

    Haiku是市场上智能类别中最快速、最具成本效益的模型。它可以在不到三秒的时间内阅读一篇arXiv上信息密集、数据丰富的研究论文(约10,000个标记),包括图表和图形。

    对于绝大多数工作负载,Sonnet比Claude 2和Claude 2.1快2倍,并具有更高水平的智能。它擅长需要快速响应的任务,如知识检索或销售自动化。

    Claude 3型号具有与其他领先型号相媲美的复杂视觉能力。它们可以处理各种视觉格式,包括照片、图表、图形和技术图解。

    Opus、Sonnet和Haiku更不太可能拒绝回答接近系统底线的提示,相比以往的模型,克劳德3模型表现出更加细致的请求理解,识别真实伤害,并且拒绝回答无害提示的频率大大降低。#ai#

    与Claude 2.1相比,Opus在这些具有挑战性的开放性问题上的准确性(或正确答案)实现了两倍的改进,同时也展现出了降低的错误答案水平。

    所有三个模型都能够接受超过100万个标记的输入,可能会向需要增强处理能力的特定客户提供这一功能。

    Claude 3模型更擅长遵循复杂的多步指令。它们特别擅长遵循品牌语调和响应指南,并开发用户可以信任的客户体验。此外,Claude 3模型更擅长生成流行的结构化输出,如JSON格式。

    Opus和Sonnet现已可在API中使用,该API现已普遍可用,使开发人员能够立即注册并开始使用这些模型。Haiku将很快可用。

    详细信息:网页链接

  9. AI对齐主义有个观点是对的,就是人类首先要比AI聪明,才有能力去判断AI做的事情是不是对的

    AI对齐主义有个观点是对的,就是人类首先要比AI聪明,才有能力去判断AI做的事情是不是对的。延伸到现在很多利用AI贩卖焦虑的课程上,似乎有了AI加持之后就可以直接起飞,获得近乎无限的生产力,开启海阔天空的变现之路。事实上,无论是通过AI来写文章还是做视频,使用者本身的能力其实要比工具重要太多,这会体现在驾驭表现上。说直白点就是,如果你自己没有创作的基本功乃至审美、网感这些加分项,那么给你再优秀的AI,你生产出来的也只会是网络垃圾,无法带给你想要的回报,而你大费周章之后也会百思不得其解,最后得出结论:唉,AI还是不行!

  10. AI探索指南
    尝试了一下Dashtoon 这个 AI 漫画生成应用,发现做的挺成熟的,该有的功能都有,可以一次性生成也给了充分的编辑和自定义空间。#ai画图# 国内的很多小说视频还是手工用各种 AI 工具拼凑的阶段,可以借鉴一下这个产品的实现方式,是个机会。 他的人物一致性是通过内置的非常多人物 Lora 实现的,目前来看这确实是最稳定的方案。 具体的生成逻辑是你输入大概的故事描述,他会为你生成很多个场景描述,你修改确认之后就会根据文字场景描述生成图片和漫画的对话。后两张是我一次性生成的漫画。 这里尝试:网页链接
    006KpAl0ly1hnet467leij318g60ox6s.jpg
    4.9 MB
    006KpAl0ly1hnet48y7tnj318g9ycb2h.jpg
    9.4 MB