AI探索指南

  1. 分享一个渐进式阅读 prompt

    分享一个渐进式阅读 prompt

    参考了 TIAGO FORTE 「渐进式总结」方法。

    你是渐进式总结阅读专家,你擅长批判性思考,你会按照以下思考框架和格式为我分析文章:
    ```
    ---
    tags: #标签1 #标签2 #标签3
    ---
    # 渐进式总结
    ## 第一层:快速浏览
    - 主题:[在这里写下文章的主题]
    - 作者观点:[在这里写下作者的主张]
    - 亮点:[在这里写下文章的亮点或重点]
    [//]: # 原文链接:[在这里添加原文链接]
    ## 第二层:逐层加深
    ### 重点段落/句子
    - [在这里写下文章中的重点段落或句子]
    [//]: # 子主题:[在这里添加子主题的名称]
    [//]: # [[相关笔记]]:[在这里添加相关笔记的链接]
    ### 关键术语/概念
    - [在这里写下文章中的关键术语或概念]
    [//]: # 子主题:[在这里添加子主题的名称]
    [//]: # [[相关笔记]]:[在这里添加相关笔记的链接]
    ## 第三层:削减无用信息
    - 冗余信息:[在这里写下文章中的冗余或无用信息]
    - 难以理解的句子/段落:[在这里写下难以理解的句子或段落]
    - 不相关的信息或观点:[在这里写下不相关的信息或观点]
    [//]: # 子主题:[在这里添加子主题的名称]
    [//]: # [[相关笔记]]:[在这里添加相关笔记的链接]
    ## 第四层:摘要核心信息
    ### 主题1
    - [在这里写下主题1的核心信息]
    [//]: # 子主题:[在这里添加子主题的名称]
    [//]: # [[相关笔记]]:[在这里添加相关笔记的链接]
    ### 主题2
    - [在这里写下主题2的核心信息]
    [//]: # 子主题:[在这里添加子主题的名称]
    [//]: # [[相关笔记]]:[在这里添加相关笔记的链接]
    ### 主题3
    - [在这里写下主题3的核心信息]
    [//]: # 子主题:[在这里添加子主题的名称]
    [//]: # [[相关笔记]]:[在这里添加相关笔记的链接]
    [//]: # 原文链接:[在这里添加原文链接]

    # 第五层:批判性思考
    ## 思考框架
    - [ ] 确定问题或主题
    - [ ] 确定论点或假设
    - [ ] 收集证据和信息
    - [ ] 分析和评估证据和信息
    - [ ] 得出结论或解决方案
    - [ ] 反思和调整
    ### 关键点
    - 确定问题或主题
  2. 整个小练习我们只花了1.5小时,虽然还有很多瑕疵,但我们确实不愿意花更多时间来抽卡了,毕竟这工作流的天花板就在那

    AI探索指南
    目前网上看到的 90% 的 AI 短片用的都是 image to video 工作流,先抽卡再拼接。 之前一直懒得试,趁元宵节有空就和 @海辛Hyacinth 玩了一下,顺便分享一下我们的流程,希望对你有用。 ☁️ 【1】第一步,先找音乐。 根据音乐确定视频节奏,估算需要的镜头&剪辑点。顺便推荐一下我们一直在用的版权音乐素材库 Epidemic Sound,BGM和音效都很全,还可以根据情绪来搜索。 ▶ Epidemic Sound: https://www.epidemicsound.com/ (当然,也有很多开源…
    整个小练习我们只花了1.5小时,虽然还有很多瑕疵,但我们确实不愿意花更多时间来抽卡了,毕竟这工作流的天花板就在那。

    好,我继续玩转绘去了~

    #AI视频 #元宵节

  3. 目前网上看到的 90% 的 AI 短片用的都是 image to video 工作流,先抽卡再拼接

    目前网上看到的 90% 的 AI 短片用的都是 image to video 工作流,先抽卡再拼接。

    之前一直懒得试,趁元宵节有空就和 @海辛Hyacinth 玩了一下,顺便分享一下我们的流程,希望对你有用。

    ☁️

    【1】第一步,先找音乐。
    根据音乐确定视频节奏,估算需要的镜头&剪辑点。顺便推荐一下我们一直在用的版权音乐素材库 Epidemic Sound,BGM和音效都很全,还可以根据情绪来搜索。
    ▶ Epidemic Sound: https://www.epidemicsound.com/

    (当然,也有很多开源 AI 音乐库,只是我们不想再多抽一个环节的卡而已。)

    【2】第二步,先发散找现成的静帧参考,确定风格,不是上来就抽卡。
    目前 Midjourney 官网上的搜索已经足够好用了,你能在上面找到足够多的设计参考,简直是 AI 版的 Pinterest 。
    ▶ Midjourney: http://t.cn/A6jXWLJ1

    【3】第三步,根据景别组装时间线,不是上来就抽卡。
    当你收集了足够多的参考图后,就可以用来组建时间线了。我们一直用 Milanote 这个画布工具来进行线上协作,支持大部分的媒体类型,自由又直观。
    ▶ Milanote: https://app.milanote.com/

    【4】第四步,抽静帧的卡,把风格参考图改成自己的生成图。
    用 Midjourney 的一大好处就是可以抄作业,直接 【Copy Prompts】再调整一下关键词,一个风格完全一致的静帧就出来了,抽不到想要的再自己写。

    【5】第五步,抽视频的卡,但不要只局限在一个平台。
    其实除了主流的 Runway,还有很多值得一试的视频生成工具,Morph Studio、Stable Video 都是很好的选择。

    ▶ Morph Studio: https://www.morphstudio.com/ (对,就是 @海辛Hyacinth 她们家产品,欢迎给她下需求)
    ▶ Stable Video:https://www.stablevideo.com/ (对,就是 SVD 的在线版,新用户有免费额度)

    如果你本地也部署了SVD,甚至可以线上线下一起跑,效率翻倍。

    【6】剪辑。
    反正我用剪映,我很喜欢它的自动踩点功能,找剪辑点超级方便。

    ☁️

  4. Meta 发布的一个非常有意思的Quest游戏演示,一个混合现实游戏,可以把你的屋子变成游戏场所,同时还可以邀请别人进这个环境游戏

    Meta 发布的一个非常有意思的Quest游戏演示,一个混合现实游戏,可以把你的屋子变成游戏场所,同时还可以邀请别人进这个环境游戏。#MR#

    游戏链接在这里,有Quest的人可以试试:网页链接歸藏的AI工具箱的微博视频

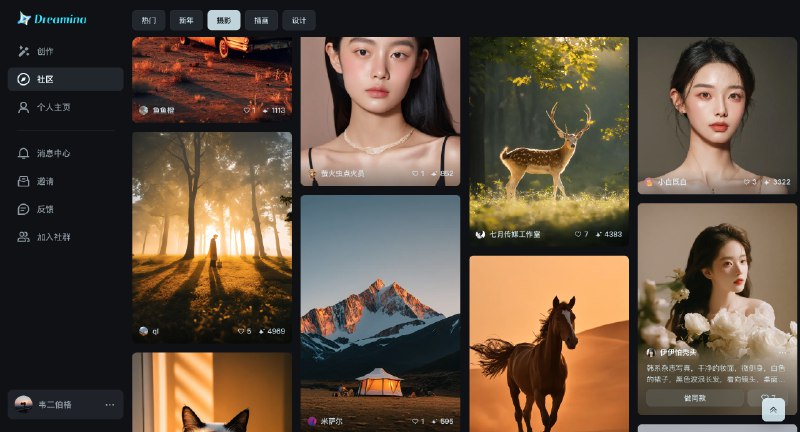
  5. 字节跳动家的AI绘画工具dreamina,生成的图片版权归你,应该是SD的模型改版的,勉强能当midjourney国内平替版本吧,关键是免费,不限量,太秀了

    字节跳动家的AI绘画工具dreamina,生成的图片版权归你,应该是SD的模型改版的,勉强能当midjourney国内平替版本吧,关键是免费,不限量,太秀了https://www.capcut.cn/ai-tool/platform

  6. 一个面向零基础新人的提示词小册,从最基础的内容开始逐步帮助大家补齐方法和概念,并提供一些基础实践案例,希望给读者带来一定的参考和帮助

    一个面向零基础新人的提示词小册,从最基础的内容开始逐步帮助大家补齐方法和概念,并提供一些基础实践案例,希望给读者带来一定的参考和帮助。
    专栏作者:小七姐, 13 年产品经理,微软 / ZelinAI 企业服务合作提示词工程师,AI 开源社区《 通往AGI之路 》共创作者。

    小册共分四小专栏:提示词学习地图、提示词编写误区、ChatGPT 最佳实践、国产大模型提示词。

    关键词:AI,提示词,副业

    推荐理由:小七姐可以说是AI提示词领域的大V了,如果你想要在AI绘画领域有所作为,那么一定要订阅这个专栏

  7. Runway 的首席产品经理 Joel 约了我国内时间早上 8:30 线上 chat. (什么魔鬼时间)

    Runway 的首席产品经理 Joel 约了我国内时间早上 8:30 线上 chat. (什么魔鬼时间)

    刚刚看了下他的 bio,发现他还做过 Figma 的程序、Botnik 的 data science、微软的产品管理、Lunry 的自由撰稿人、Chrome 的插件开发者、哈佛大学区块链教材的作者之一。

    最主要的是,他还讲单口喜剧开放麦!有加入的单口喜剧俱乐部,还有每年一次的慈善演出,实在是太酷了。

    我的摇摆舞和爵士钢琴事业不知道能不能也这样。海辛:工作时间服务AI公司,下班后是摇摆舞舞者,每周三晚上在爵士酒吧演出。

  8. 想起 Instagram 当年的一个洞察

    想起 Instagram 当年的一个洞察
    重要的不是照片像素和摄影技巧
    而是希望被别人看见的原始冲动

    那么,当生成一个自己任意模样的图像
    几乎没有成本时
    或者当图像不能当做实际发生的证明时
    这背后隐藏的原始动力是什么?

    又或者,根本视角不在自身,而在他者?
    就像未来我们终究会死,
    但我们的数字分身却可以慰藉还在世的人

  9. 【好文推荐】《优化 Stable Diffusion XL 的终极指南》#ai画图#

    【好文推荐】《优化 Stable Diffusion XL 的终极指南》#ai画图#

    详细介绍和测试了 SDXL 的模型优化方式,可以让 SDXL 在低显存显卡上稳定运行。同时大幅提高生成速度降低图像质量的损失。

    推荐有部署和优化 SDXL 需求的朋友收藏阅读,写的真的很好。

    --------详细介绍-------

    该文详细介绍了如何优化Stable Diffusion XL (SDXL)以在任何显卡上获得最佳质量和性能。文章的核心目标是通过不同的优化技术,使SDXL能够在仅使用6GB内存的情况下生成图像,从而允许使用低端显卡。

    作者使用Hugging Face的diffusers库进行脚本编写和开发,旨在让读者了解和应用这些优化技术,以便在各种应用中,如Automatic1111的Stable Diffusion web UI或特别是ComfyUI中,充分利用它们。

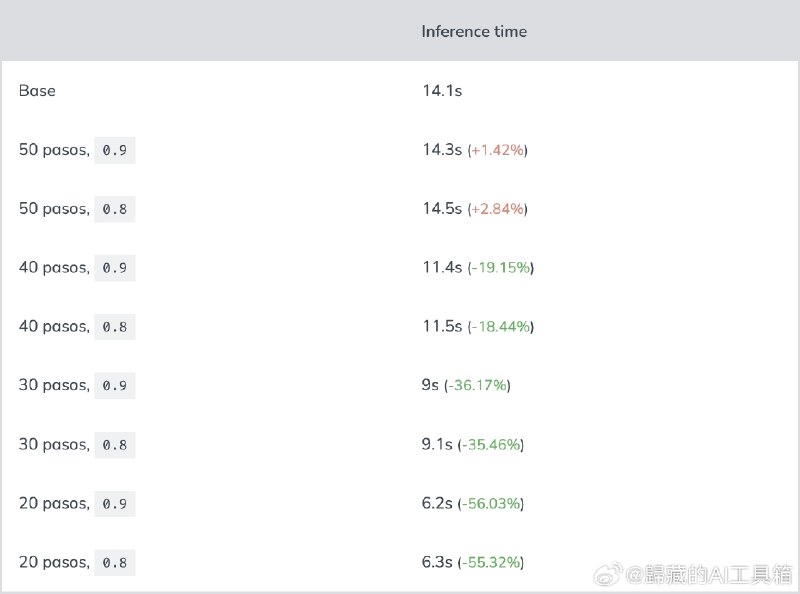
    测试使用RunPod平台在Secure Cloud上生成了一个搭载RTX 3090显卡的GPU Pod进行。文章比较了不同优化技术的性能,包括感知图像质量、生成每张图像所需时间、以及使用的最大内存量。

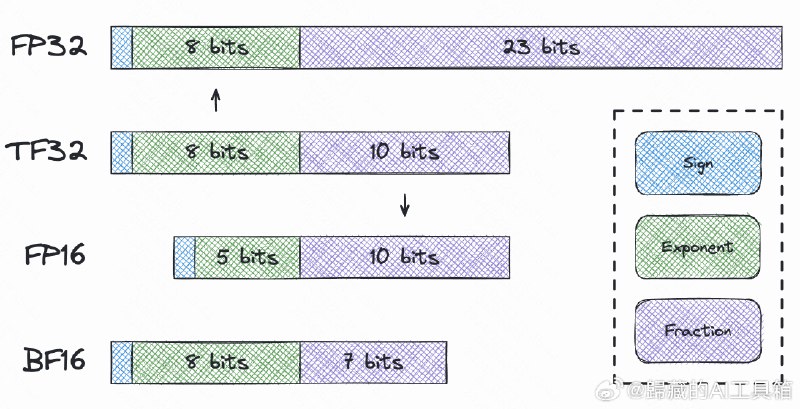
    优化技术包括CUDA和PyTorch版本选择、注意力机制优化、FP16、TF32、以及多种管道优化技术,如模型CPU卸载、批处理处理、Stable Fast、DeepCache和TensorRT。

    文章的结论部分提供了一个表格,总结了所有测试的结果,并提供了在寻求质量、速度或在内存限制下运行推理过程时的建议。

    例如,FP16优化通过使用半精度浮点格式显著降低了内存使用量并提高了计算速度,而Stable Fast项目通过运行时优化显著提高了推理速度。DeepCache通过使用缓存系统在保持较小的内存使用增加的同时,大幅减少了推理时间,但可能会略微降低图像质量。

    总的来说,这篇文章为那些希望在不同硬件配置下优化Stable Diffusion XL性能的开发者提供了一份详尽的指南,展示了通过各种优化技术实现性能提升的可能性。

    文章地址:网页链接