AI探索指南Snap Video 一种基于transformer的视频生成模型架构,其训练速度比 U-Net 快 3.31 倍(推理速度约快 4.5 倍)17:34 · 2024年2月23日 · 周五Snap Video 一种基于transformer的视频生成模型架构,其训练速度比 U-Net 快 3.31 倍(推理速度约快 4.5 倍)。#ai视频#这个架构可以高效训练一个包含数十亿参数的文本到视频模型。(arxiv 的 PDF 转 HTML 居然又好了)项目地址:网页链接歸藏的AI工具箱的微博视频17:34 · 2024年2月23日 · 周五
AI探索指南Gamma:下一代的 PPT 制作方式14:58 · 2024年2月23日 · 周五Gamma:下一代的 PPT 制作方式。文本转 PPT,这里用 ChatGPT 生成了一段关于 ChatGPT 介绍的大纲和详细内容的 Markdown,然后将这段内容交给 Gamma,看它能做出什么样的效果。Gamma 的基本功能是完全免费的,而使用 AI 功能则需要相应的积分(credits),注册赠送 400 credits。或者直接开通 Pro 账户(16美元/每月)(还挺贵)。用我的邀请链接注册也会双方各赠送 200 credits:https://gamma.app/signup?r=5gesmvu4uy95nkg14:58 · 2024年2月23日 · 周五
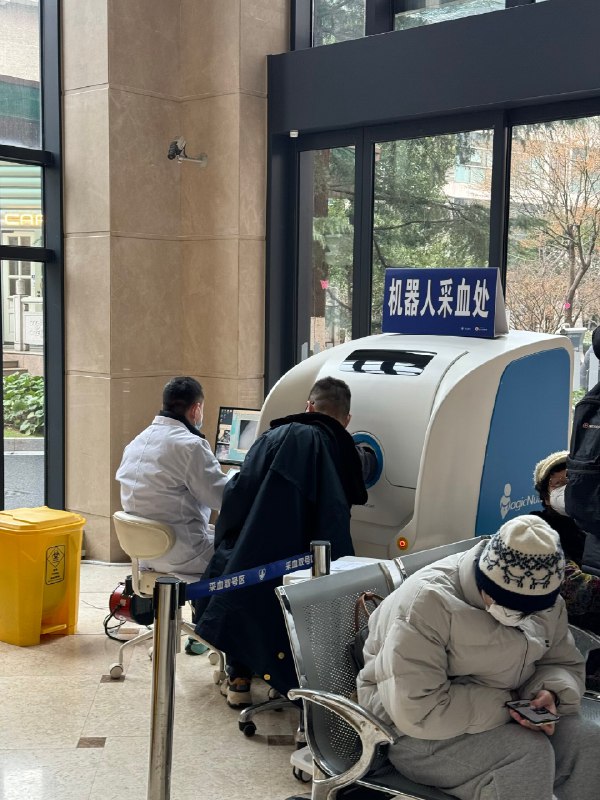
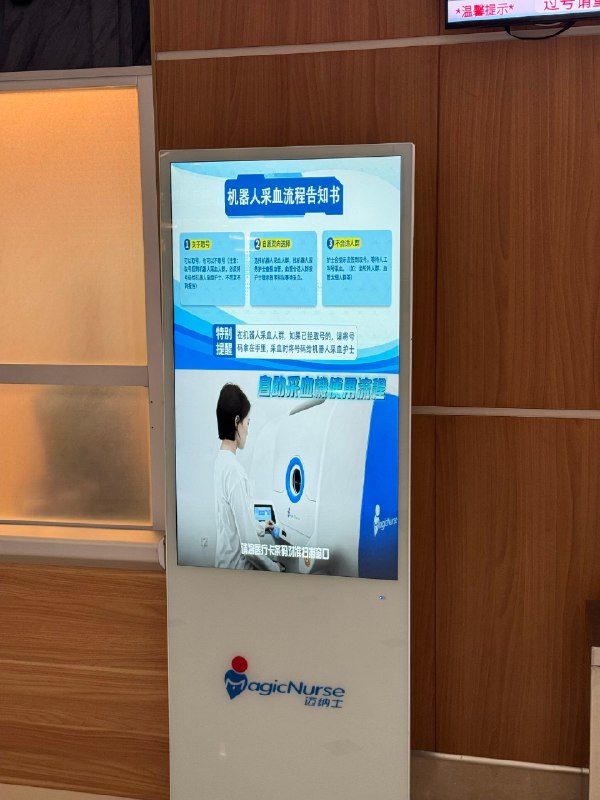
AI探索指南医院里有个机器人采血,旁边有医生辅助14:22 · 2024年2月23日 · 周五 × × 医院里有个机器人采血,旁边有医生辅助但是操作时间比较长,大概是人工采血3-5倍时间虽然不用排队,但是大家都还是愿意花更长的时间在人工窗口等待。看来人对新鲜事物都有所抗拒如果是你,你愿意试试机器人采血吗?14:22 · 2024年2月23日 · 周五
AI探索指南目前市面上做人形机器人的,14:22 · 2024年2月23日 · 周五目前市面上做人形机器人的,稚晖君,电子科技大学,华为入局了。陈建宇,星动纪元,清华的。王兴兴,宇树科技,浙江理工的,唯一一个不是top院校在这个行列。14:22 · 2024年2月23日 · 周五
AI探索指南1个1人AI公司的年度复盘(长文慎入)13:26 · 2024年2月23日 · 周五 × 1个1人AI公司的年度复盘(长文慎入)10个月前,我决定把公司开在@飞书 上,开启这个“危险”的探索。 这是个开工前的复盘……欢迎点赞转发给个鼓励,更欢迎提点需求和建议。如果对AI视频和RPA感兴趣,一起做点事,咱们私聊🙃😊13:26 · 2024年2月23日 · 周五
AI探索指南昨天的 Midjourney 透露的一些消息,Midjourney 将会在六个月内开放 API,V7 模型可以生成视频,将会有产品在中国推出12:57 · 2024年2月23日 · 周五 × 昨天的 Midjourney 透露的一些消息,Midjourney 将会在六个月内开放 API,V7 模型可以生成视频,将会有产品在中国推出。一致性和 ControlNet 能力还在打磨。-------完整内容-------网站方面#ai画图##midjourney#正在开发网站的新社交功能v6版本正在完成 v6 版本的相关工作正在开发用户最期待的角色一致性特性,尚需测试和确定监管策略提升视觉美感可能改进角色身体的一致性提高 v6 的运行速度即将推出的描述功能(预计1至2周内发布)计划加入颜色参考功能,类似于现有的风格和角色参考v6的加速模式v7版本在 v6 完成后将重点开发 v7将打造更加清晰高效的系统考虑将视频功能推迟到 v7 版本其他动态对目前的 ControlNet 进展不太满意,尤其是其外观方面将继续推进视频功能的开发未来六个月,我们可能会开始与一些顶尖 AI 实验室进行合作或建立伙伴关系(届时我们会拥有 MJ API)。我们也可能会与一些大型语言模型进行合作。中国正在研发一个类似于 MJ 的项目,预计不久后将亮相。来源:网页链接12:57 · 2024年2月23日 · 周五
AI探索指南Andrej Karpathy 提出了一个工作流希望自动将长视频内容转换为带对应示例的播客文章12:57 · 2024年2月23日 · 周五 × Andrej Karpathy 提出了一个工作流希望自动将长视频内容转换为带对应示例的播客文章。现在虽然也有一些类似工具但是都做的不好。#ai##llm#同时他还把前几天自己的视频教程转成了文字内容,觉得视频太浪费时间的可以看文本。AK 设想的完整工作流:一个有趣的大语言模型 (Large Language Model) 挑战是:将我的2小时13分钟的分词器视频转换成一本书的章节(或者博客文章)形式,专门讨论分词。具体步骤如下:为视频添加字幕或解说文字。将视频切割成若干带有配套图片和文字的段落。利用大语言模型的提示工程技术,逐段进行翻译。将结果输出为网页形式,其中包含指向原始视频各部分的链接。从更广泛的角度来看,这样的工作流程可以应用于任何视频输入,自动生成各种教程的“配套指南”,使其格式更加便于阅读、浏览和搜索。这听起来是可行的,但也颇具挑战。LLM Tokenization课程文字版本:网页链接12:57 · 2024年2月23日 · 周五
AI探索指南Emad 昨晚发布的这个 SD3 模型演示非常牛批12:57 · 2024年2月23日 · 周五Emad 昨晚发布的这个 SD3 模型演示非常牛批。开源的丐版 Sora 模型?SD3 不止可以生成图片,还可以通过文字非常精准的修改图片指定内容,而且可以生成视频。#ai视频##sora#来源:Emad推特 歸藏的AI工具箱的微博视频12:57 · 2024年2月23日 · 周五
AI探索指南Arc Search 浏览器一个很有意思的新功能,双指捏合任何一个打开的页面浏览器会自动为你总结页面内容,交互动画也非常有趣09:20 · 2024年2月23日 · 周五Arc Search 浏览器一个很有意思的新功能,双指捏合任何一个打开的页面浏览器会自动为你总结页面内容,交互动画也非常有趣。现在更新就能用。09:20 · 2024年2月23日 · 周五
AI探索指南OpenAl Sora 视频生成耗时长:挑战与机遇并存07:56 · 2024年2月23日 · 周五OpenAl Sora 视频生成耗时长:挑战与机遇并存OpenAI 发布的Sora模型虽然能够根据文本生成逼真视频,但1分钟视频需要超过1小时渲染时间,反映了当前AI视频生成技术的挑战和未来的改进空间07:56 · 2024年2月23日 · 周五
AI探索指南Arc Search 浏览器一个很有意思的新功能,双指捏合任何一个打开的页面浏览器会自动为你总结页面内容,交互动画也非常有趣00:45 · 2024年2月23日 · 周五Arc Search 浏览器一个很有意思的新功能,双指捏合任何一个打开的页面浏览器会自动为你总结页面内容,交互动画也非常有趣。现在更新就能用。#ai#歸藏的AI工具箱的微博视频00:45 · 2024年2月23日 · 周五
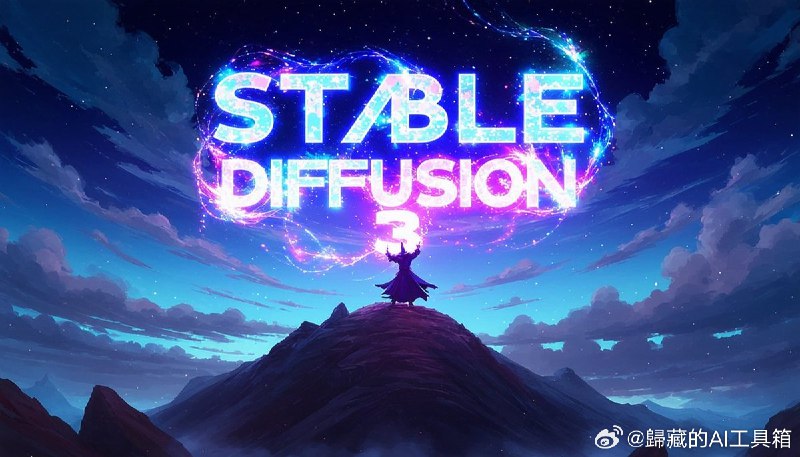
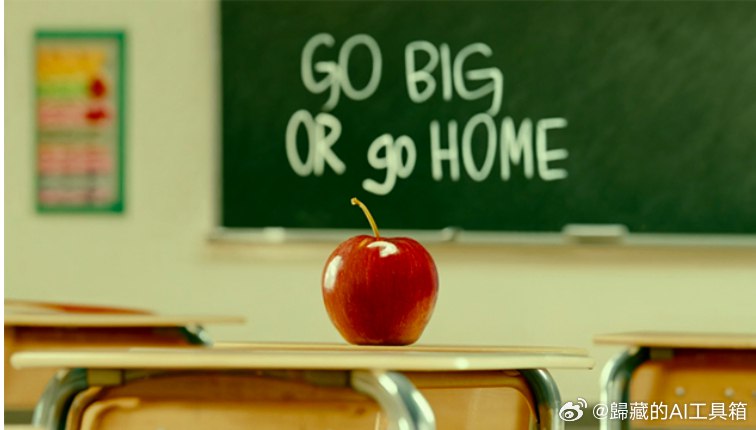
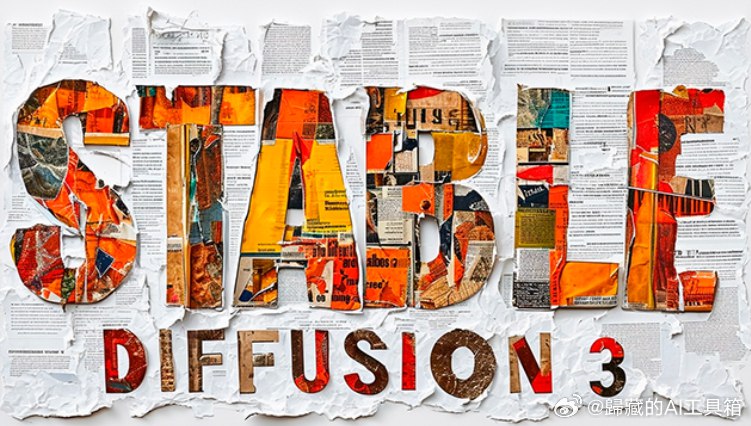
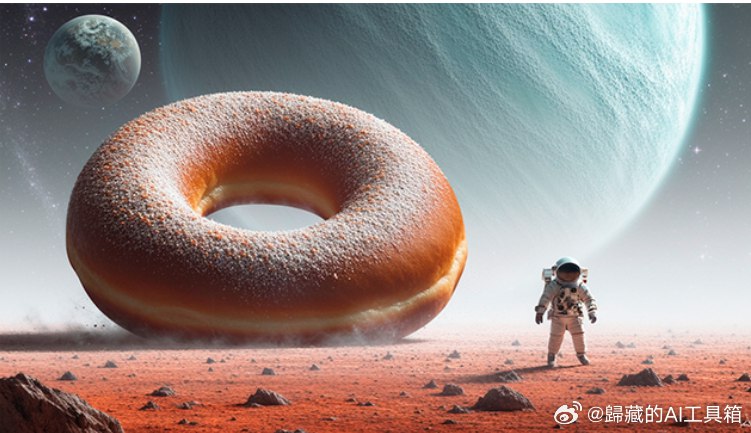
AI探索指南卧槽 Stability AI 还有货,发布了Stable Diffusion 3模型,多主题提示、图像质量和拼写能力方面的性能得到了极大的提高00:45 · 2024年2月23日 · 周五 × × × × 卧槽 Stability AI 还有货,发布了Stable Diffusion 3模型,多主题提示、图像质量和拼写能力方面的性能得到了极大的提高。#ai画图#Stable Diffusion 3 套模型目前参数范围从 800M 到 8B。Stable Diffusion 3采用了和Sora一样的diffusion transformer 架构。公告全文:网页链接00:45 · 2024年2月23日 · 周五
AI探索指南Emad关于Stable Diffusion 3的补充信息: #ai画图#00:45 · 2024年2月23日 · 周五 × Emad关于Stable Diffusion 3的补充信息: #ai画图#这项技术采用了一种新型的扩散变换器(Diffusion Transformer,类似于Sora),并结合了光流匹配(flow matching)及其他技术上的改进。利用变换器(Transformer)的最新改进,这项技术不仅能够实现更广泛的应用范围,还能处理多种类型的输入数据(多模态输入)。关于这项技术的更多技术细节,我们将很快对外公布。来源:网页链接00:45 · 2024年2月23日 · 周五
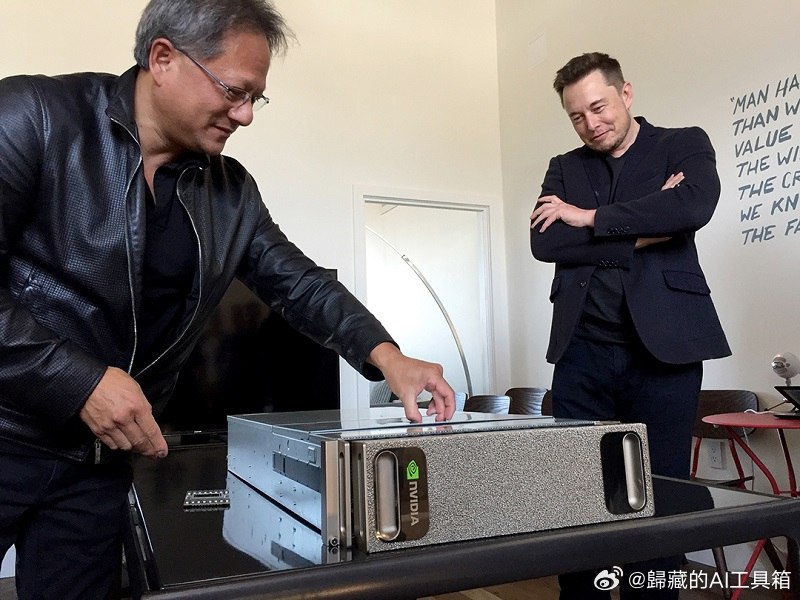
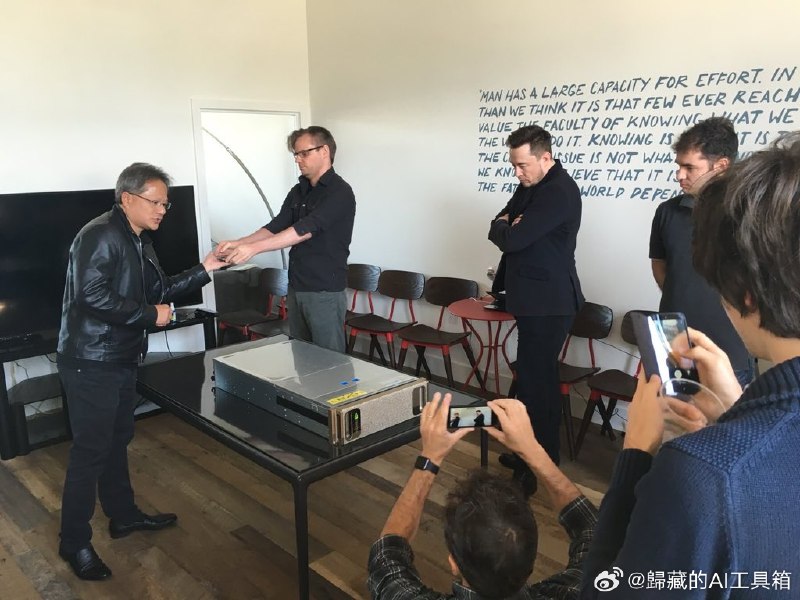
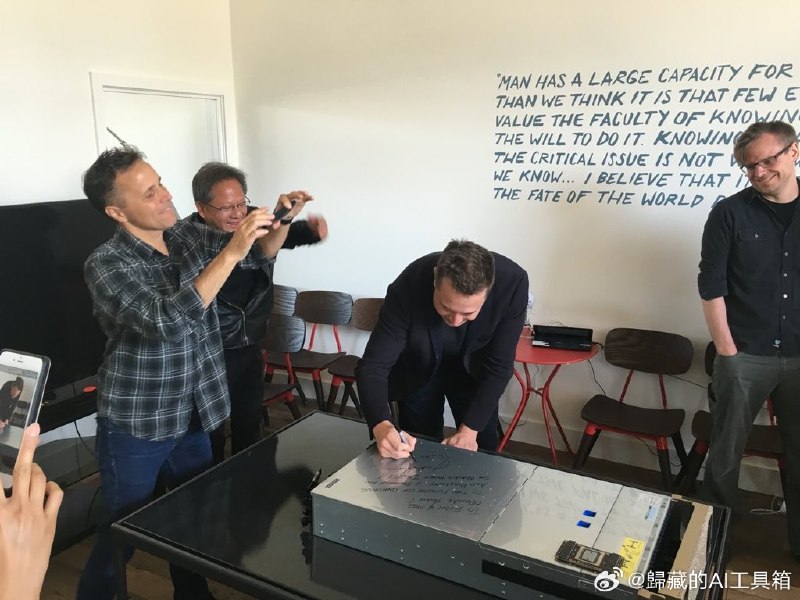
AI探索指南老黄18年把DGX-1 AI 超级计算机捐给Open AI的照片,他也没能想到当时的一个超算,会让英伟达达到这个高度吧00:45 · 2024年2月23日 · 周五 × × × 老黄18年把DGX-1 AI 超级计算机捐给Open AI的照片,他也没能想到当时的一个超算,会让英伟达达到这个高度吧。来源:马斯克推特00:45 · 2024年2月23日 · 周五