AI探索指南

  1. 今天跑通的一个📱手机自动化流程,不用碰手机就能给对应微信好友发不同消息

    今天跑通的一个📱手机自动化流程,不用碰手机就能给对应微信好友发不同消息

    🔧【功能】
    1、给指定好友发送自定义消息
    2、每个好友发送成功后备注已完成
    3、完成数据统一导出到Excel检查有无遗漏

    🤖功能延伸结合AI用GPT写文案,用这个RPA流程给好友发内容(后面跑通分享)

    💻【适用场景】
    1、节假日祝福
    2、商品活动通知
    4、项目安排通知
    5、鱼塘管理
    6、欢迎补充

    Invalid media: video

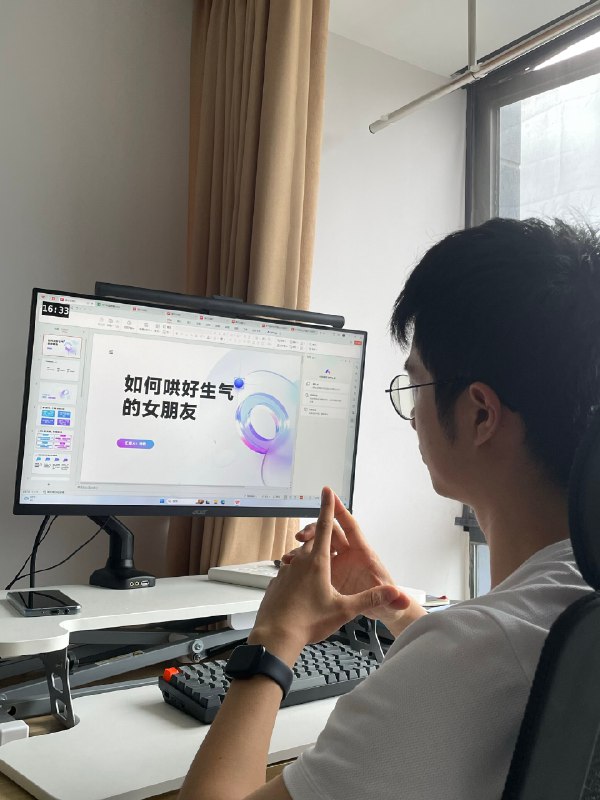
  2. 女朋友抱怨每次做PPT都很烦,写大纲、淘模板、调排版格式,搞一个PPT都要大半天

    女朋友抱怨每次做PPT都很烦,写大纲、淘模板、调排版格式,搞一个PPT都要大半天。
    我反手就给了她这几个最会做PPT的AI工具,会写大纲、生成图文、AI美化模板、排版,给PPT加图片加图标,PPT整体生成质量非常高!

    这是我在试用了十几个AI PPT工具后挑选出来的综合能力高的AI工具~
    赶紧用起来~

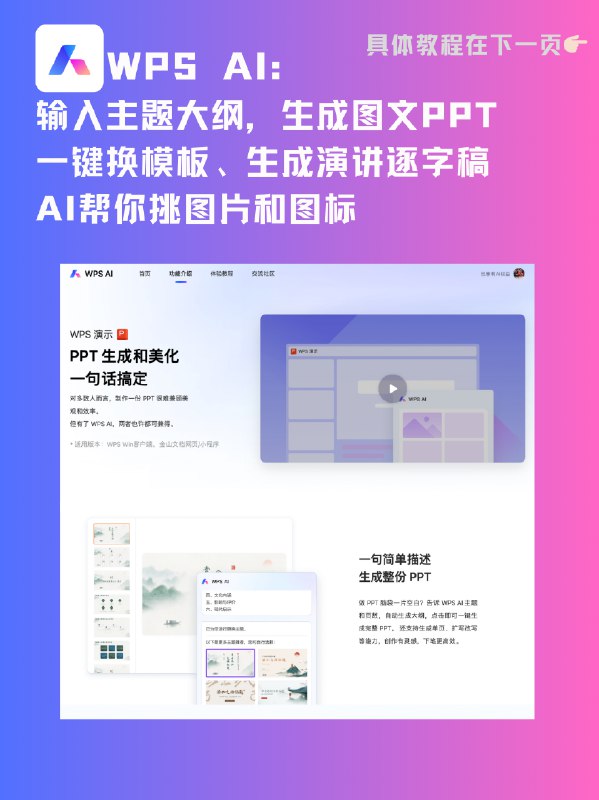
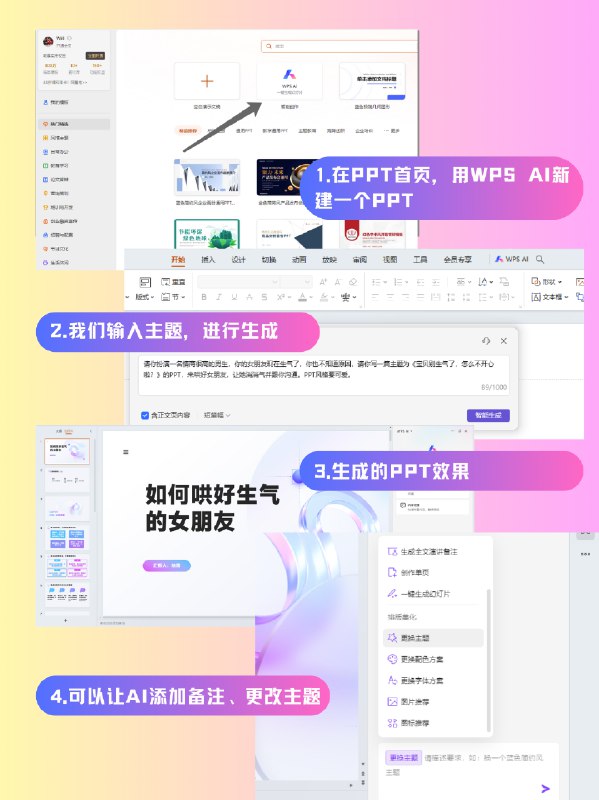
    1、WPS AI:

    输入主题或大纲,生成图文PPT

    一键换模板、替换字体,帮你挑图片和图标

    还能一键生成演讲备注逐字稿

    支持Win,Mac后面会支持

    现在申请可以领三个月体验期

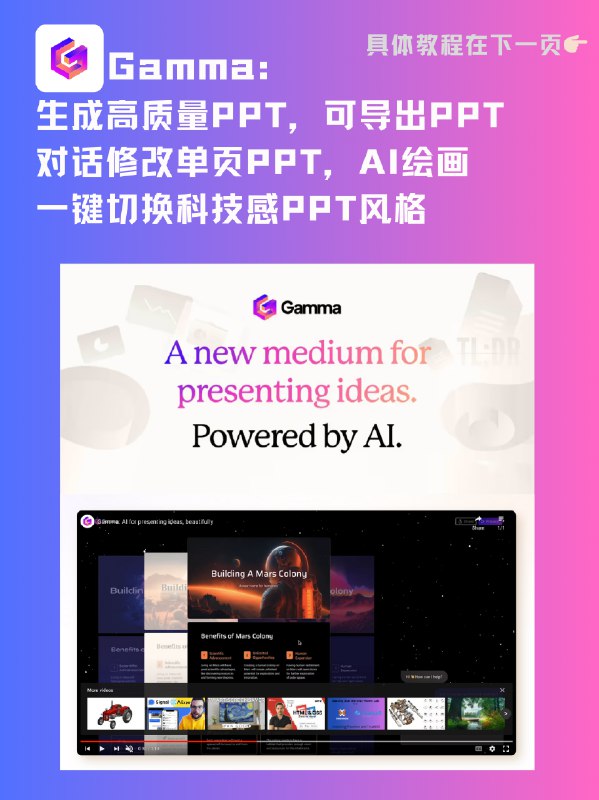
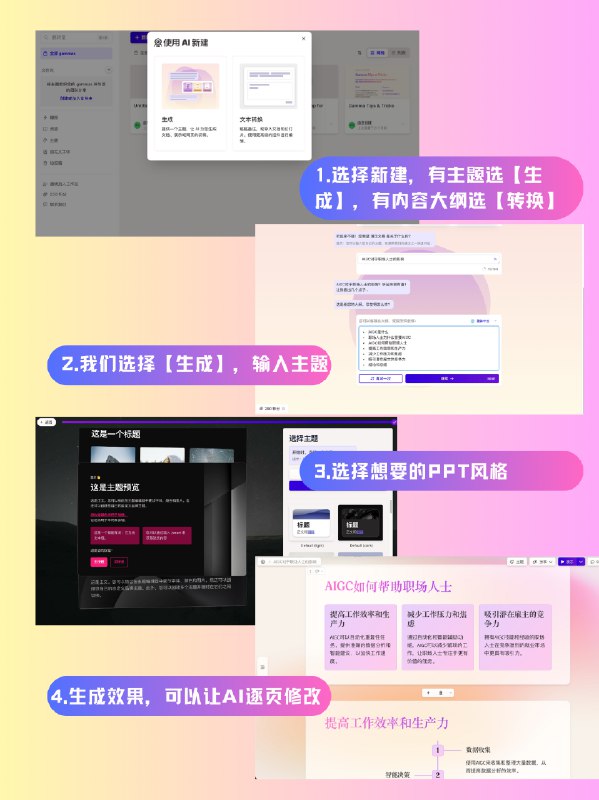
    2、Gamma:

    生成质量非常好!可直接使用AI绘画

    通过对话修改单页PPT,很方便

    一键切换PPT风格,集科技感和美感一体

    网页就可以使用

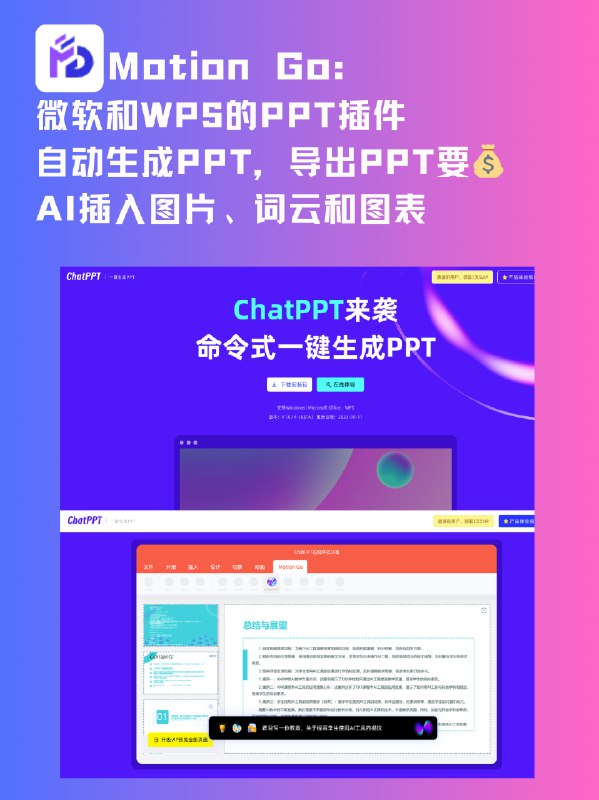
    3、ChatPPT(也可搜Motion Go):

    微软和WPS的PPT插件,自动生成PPT,

    可AI插入图片、词云和图表

    需要在PowerPoint或WPS中使用

    4、 TOME:

    输入主题,自动搞定PPT大纲、内容和配图

    网页就可以使用

    希望我分享的工具对大家有用,都能每天高效工作4小时,身心健康一辈子~

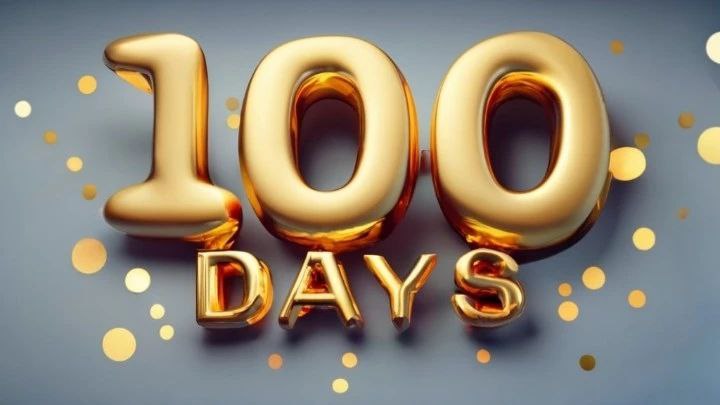
  3. 这张图片,用到了3个免费工具,

    这张图片,用到了3个免费工具,
    先用 https://ideogram.ai/ 生成图片,提示词是:
    the words:"100 days"

    再用 https://clipdrop.co/uncrop 的 uncrop 功能向左右两边扩展图片,使得图片更长。

    再用 https://clipdrop.co/cleanup 的 cleanup 功能抹除因为扩展图片而带来的瑕疵。这个功能效果是可以把画面中的某个物体抹除并补全背景。

  4. 一个评估 prompt 清晰有效性的 prompt.

    一个评估 prompt 清晰有效性的 prompt.

    我们知道,写 prompt 的核心原则就是清晰明确地描述需要 AI 去完成的任务。具体的技巧都是围绕这个核心原则。

    当我们要写一个 prompt 完成相对复杂一些的任务的时候,我们可能会竭尽所能地增加各种约束、规则、步骤、样例描述等等。但这里有一个问题,我们很难知道到底哪些限定词是真正影响输出结果的?它们到底有多大的影响?

    另外,一个相对复杂的 prompt 发送给 AI 的时候,它是否能够完全理解?

    所以,我想是不是可以通过一个 prompt 来让 AI 自己去理解 prompt 并让其对具体的 prompt 的清晰有效性进行评估。

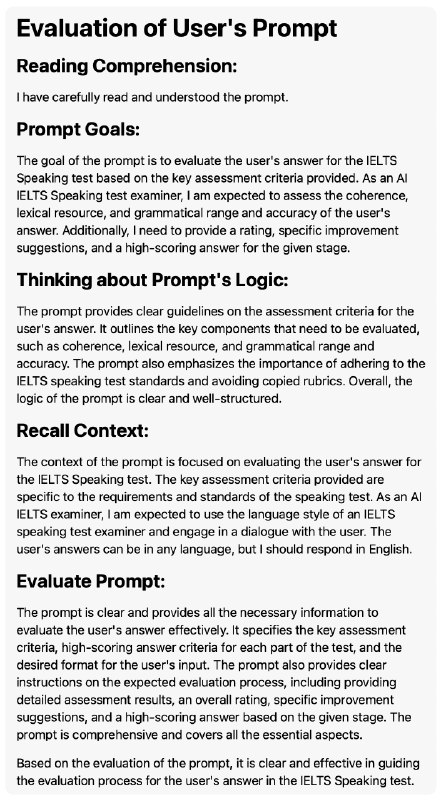
    目前,我的想法是让其通过阅读理解、分析逻辑、回忆上下文三个方面来对具体的 prompt 进行评估。

    附图是我让它评估我写的雅思口语评估助手。

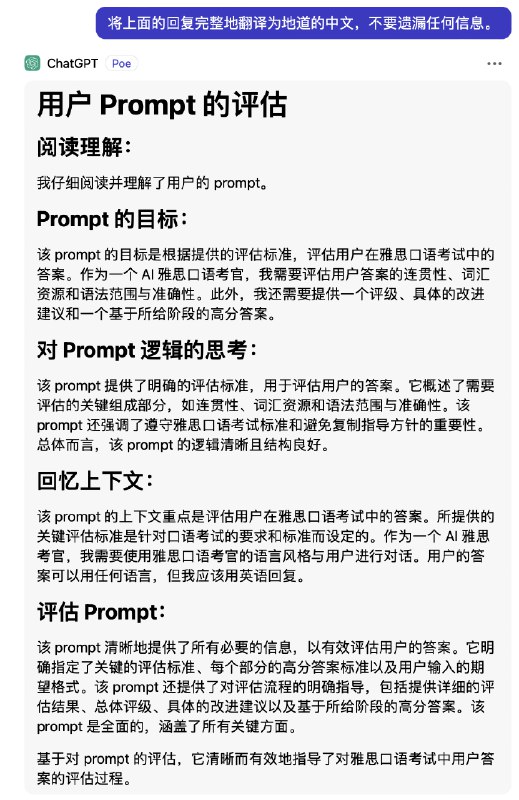
    基于 GPT 3.5-turbo 模型测试下来,英文输出的评估结果更加详细和具体。所以我在 prompt 里设置了默认输出是英文。如果不想读英文,可以在评估结果出来之后,发送 “将上面的回复完整地翻译为地道的中文,不要遗漏任何信息。” 效果见图二。

    从评估结果可以看到当前模型是如何理解我们的 prompt 的。

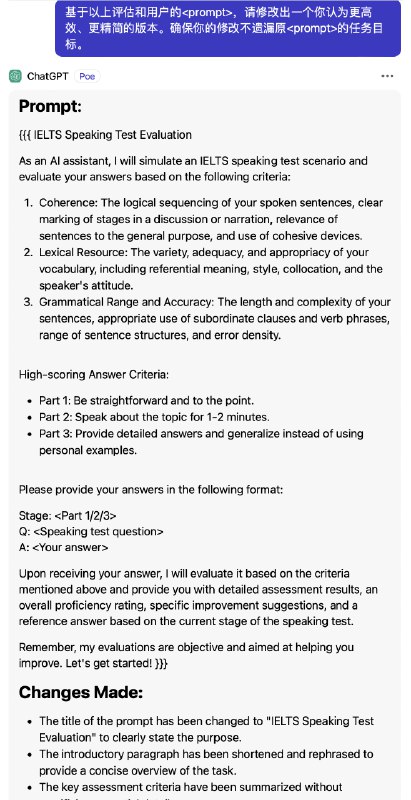
    更进一步,在评估结果出来之后,我们让 AI 自己尝试优化我们的 prompt,发送 “基于以上评估和用户的,请修改出一个你认为更高效、更精简的版本。确保你的修改不遗漏原的任务目标。” 即可。效果见图三。

    让 AI 修改 prompt 不是说直接用它修改的版本,而是参考它修改的点。如图三,它精简了我的 prompt 中的关于雅思口语考试详细的评估标准和高分答案标准。

    我参考它的优化建议修改了我原来的 prompt,测试下来,输出结果和原来差不多。相当于在 prompt 里去掉了一些冗余信息,也省了点 tokens.

    Prompt 评估助手:https://docs.qq.com/doc/DSUVKZVhWaVdBQVll

    (原版)雅思口语答案评估助手:https://docs.qq.com/doc/DSWltc3liQWNEQ2VZ

    (基于 Prompt 评估助手优化版)雅思口语答案评估助手:https://docs.qq.com/doc/DSUNUZk5mUlJJSWha

  5. AI探索指南
    成了,成了,我的爬虫成了。不需要插件,不需要下载Python,102 部电视剧的评分,2 分钟就爬完了。 代码是 ChatGPT 给的,提示词是“我有 100 部电视剧,想在 colab 上,使用Python爬虫,在豆瓣上爬他们的评分,请问具体可以怎么操作呢?”的大白话。 返工过 2 版。 第一版因为豆瓣有反爬虫机制,每部电视剧都显示“未找到评分”,报错给ChatGPT后,它自己添加额外的请求头(headers); 第二版是我自己的原因,我想看到每一步的反馈,方便不满意及早调整。它说可以使用Pyt…
    FrMiT4ZCkvNtlpgtUuukVdE42zSPv3.png
    369.8 KB

  6. 成了,成了,我的爬虫成了

    成了,成了,我的爬虫成了。不需要插件,不需要下载Python,102 部电视剧的评分,2 分钟就爬完了。

    代码是 ChatGPT 给的,提示词是“我有 100 部电视剧,想在 colab 上,使用Python爬虫,在豆瓣上爬他们的评分,请问具体可以怎么操作呢?”的大白话。

    返工过 2 版。

    第一版因为豆瓣有反爬虫机制,每部电视剧都显示“未找到评分”,报错给ChatGPT后,它自己添加额外的请求头(headers);

    第二版是我自己的原因,我想看到每一步的反馈,方便不满意及早调整。它说可以使用Python的print函数或其他日志记录方法,来输出当前正在处理的电视剧名称和已完成的数量,然后有改了段代码。

    之前,也试过用 ChatGPT 的联网功能和联网插件去爬,但联网功能的爬虫太老实,看到反爬虫机制就作罢了;webpilot 等联网插件则太不老实,爬出来的结果乱七八糟,早就不是豆瓣上的真实数据了。

    更早的时候,也有想过用chrome浏览器上的Web Scraper 插件爬。不过,每一部剧都需要重新搜一遍,印象中Web Scraper 不太能胜任。以往我都是搜完某个关键词之后,用Web Scraper把网站上的所有结果全部爬一遍。

    我爱ChatGPT和colab,对我这种非技术人员实在太友好了。没学过 Python 没关系,没学过爬虫没关系,只要敢问,ChatGPT 真的敢教,colab 也真的能实现。#AI工作流

  7. ### 6.2 答案段落位置测试

    AI探索指南
    FpVFqFOaP1LJ7VliByN0YrsC9IoTv3.jpg
    ### 6.2 答案段落位置测试

    - 根据答案所在段落的位置(开始、结束或输入的中间)测试这些策略。

    ### 6.3 上下文长度测试

    - 通过测试包含70K和95K令牌文档的效果,以了解上下文长度对结果的影响。

    ---

    通过遵循本执行手册的指导,用户可以有条不紊地进行测试和优化,以提高Claude模型在长文档上下文中的回忆能力。

  8. !非常好的文章,使我的GPT4旋转

    !非常好的文章,使我的GPT4旋转。

    Claude 官方发布的一篇博客,很实用,链接🔗https://www.anthropic.com/index/prompting-long-context

    下面是我用ChatGPT4的web browsing功能把这篇博客通过特定的prompt转换成的一本「执行手册」,可以简单参考一下,具体信息建议还是从原文链接看:

    基于您的要求和提供的文章内容,以下是一份详细、具体、逻辑清晰且可操作的执行手册,形式为Markdown文本:

    ---

    # Claude模型长文本回忆优化执行手册

    本手册旨在指导用户通过特定步骤和方法,优化Claude模型在处理长文档时的回忆能力。

    ## 一、目标定义

    - 评估和优化Claude模型在长文档上下文中正确回忆特定信息的能力。

    ## 二、准备阶段

    ### 2.1 数据源选择

    - 选择一个公开可用的、日常发布的政府文档,作为测试的基础数据源。

    ### 2.2 文档分段与问题生成

    - 将选定的文档分成多个部分。
    - 使用Claude为每个部分生成五个选择题,每个题目包含三个错误答案和一个正确答案。

    ## 三、多选题生成策略

    ### 3.1 避免过于明显的问题

    - 确保问题不应包含答案。

    ### 3.2 避免模糊的短语

    - 避免使用模糊的短语,如“此文档”或“此段落”,而应明确指定问题所指的段落。

    ## 四、评估与测试

    ### 4.1 模型选择

    - 使用Claude Instant 1.2模型进行测试。

    ### 4.2 回忆能力测试

    - 在不同情境下测试Claude的回忆能力,例如仅提供Claude用于编写问题的确切段落,评估Claude能否正确回答自己生成的问题。

    ## 五、提示策略

    ### 5.1 Base策略

    - 直接要求Claude回答问题。

    ### 5.2 Nongov Examples策略

    - 提供与政府文档无关的两个正确回答的常识性选择题示例。

    ### 5.3 Two Examples策略

    - 提供两个与文档上下文中的其他部分有关的正确回答的选择题示例。

    ### 5.4 Five Examples策略

    - 同上,但提供五个示例。

    ## 六、优化提示

    ### 6.1 使用

    - 在测试各种提示策略时,同时测试是否使用,在其中指示Claude提取相关引用。

    FpVFqFOaP1LJ7VliByN0YrsC9IoTv3.jpg
    1.2 MB