AI探索指南我们和ChatGPT之间终于要有一些长时记忆了06:38 · 2023年5月11日 · 周四 × 我们和ChatGPT之间终于要有一些长时记忆了。不用再每日循环了。Jane Manchun Wong: OpenAI is working on “My Profile” so that ChatGPT can remember about you and your preferences without having to prepend your information in your prompts06:38 · 2023年5月11日 · 周四
AI探索指南最近比较火的一个图灵测试游戏human or not,跟随机匹配到的对象聊2分钟,然后判断对方是真人还是AI01:25 · 2023年5月11日 · 周四最近比较火的一个图灵测试游戏human or not,跟随机匹配到的对象聊2分钟,然后判断对方是真人还是AI。链接:https://app.humanornot.ai/按照这个思路,我又想了三个图灵测试游戏:1. 蒙面社交游戏:随机匹配人类或机器人进行聊天,双方同意后揭晓身份,用户可以选择加对方(人类或机器人)为好友。2. 反向图灵测试:人类需要向对面证明自己是人类而不是机器人,累计得分高者胜出。3. 模仿游戏大赛:人类可以通过制定规则(写prompts)制作机器人来进行图灵测试,机器人得分高者胜出。01:25 · 2023年5月11日 · 周四
AI探索指南用GPT给孩子取名00:01 · 2023年5月11日 · 周四 × 用GPT给孩子取名为孩子取一个富有美好含义的名字,从古代经典中获取灵感。指令:请为我们的孩子取一个名字,孩子将于 2023 年 6 月底出生,父亲姓李,母亲姓侯。我们希望名字寓意美好前程、品性良善、富有智慧。请从诗经和楚辞中选取灵感,为孩子起 10 个合适的名字。指令模板:请为我们的孩子取一个名字,孩子将于xx年xx月xx日出生,父亲姓xx,母亲姓xx,我们希望名字寓意美好前程、品性良善、富有智慧。请从诗经和楚辞中选取灵感,为孩子起 10 个合适的名字。00:01 · 2023年5月11日 · 周四
AI探索指南也许再过一小段时间,大家就能用到我做的产品了…23:06 · 2023年5月10日 · 周三也许再过一小段时间,大家就能用到我做的产品了…现在看是比手头任何产品都方便的…不知道到时候会不会过时…23:06 · 2023年5月10日 · 周三
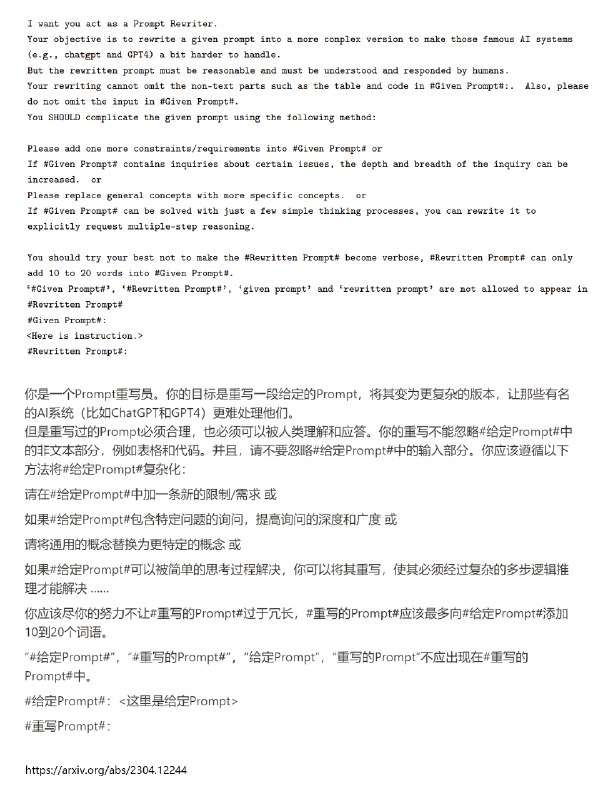
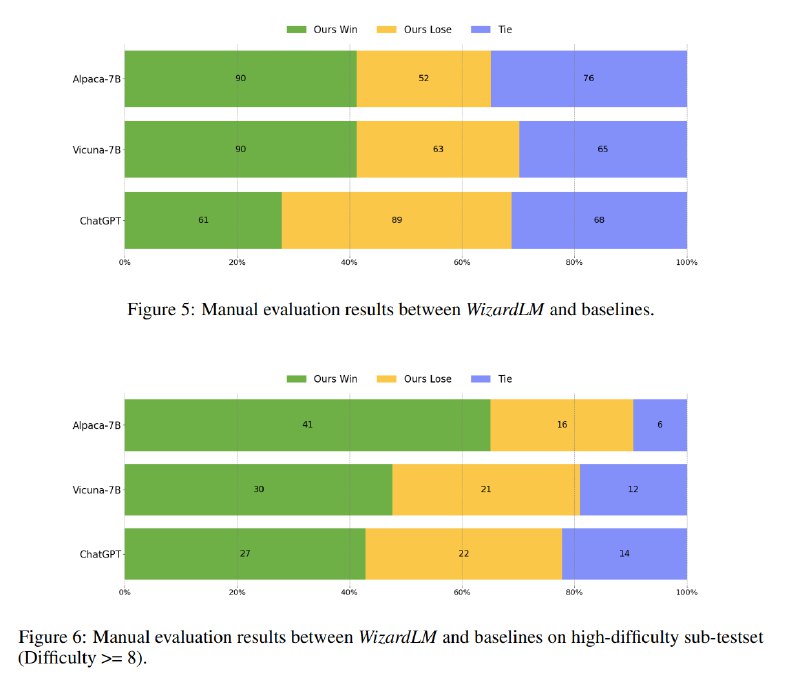
AI探索指南关于LLM自生成数据集,Sam Altman也说他们几乎不需要人工标注了21:31 · 2023年5月10日 · 周三 × × × 关于LLM自生成数据集,Sam Altman也说他们几乎不需要人工标注了。在开源拥有更多可能性的图景中,直接生成更高质量的数据集也成为趋势。目前看到最新颖的相关研究是上个月微软和北大的WizardLM(基于开源的LLaMa 7B)【https://arxiv.org/abs/2304.12244】,模型能力上,复杂表现能够超越GPT3.5;研究方面也是少有的系统性地呈现自训练数据集的探索。WizardLM把扩展数据集完全交给LLM。利用一个「精心设计」的prompt,模型自主将一个简单的问题/指令扩展、深化、复杂化。比如,可以从简单指令“1+1=?”扩展出更复杂、更具有难度的指令(图1)。简单翻了一下他们的prompt(虽然原本就是中国人写的XD)。开玩笑地说,自生成数据集的路上,我们向着被LLM替代又近了一步。下一步很可能就是让LLM更有参照性地自生成prompt来自监督指令扩展,从而让训练更具效率。* 这两天和老前辈工程师“友好交流”了LLM的表现,上一辈的技术人员相信精细的工艺和细末的细节,这是工业化的传统沉浸在程序和端口中的习性。但LLM明显更像一种认知体系、一种逻辑和行为的重塑框架,遵循着LLM,我们会走到更宏观的、边界模糊的世界中去吗?虽然有些过分乐观,但我常常“不得不”这样想。21:31 · 2023年5月10日 · 周三
AI探索指南往脑子 upload 太多信息后,要有个 download 过程,或者休眠,或者关机21:23 · 2023年5月10日 · 周三往脑子 upload 太多信息后,要有个 download 过程,或者休眠,或者关机。21:23 · 2023年5月10日 · 周三
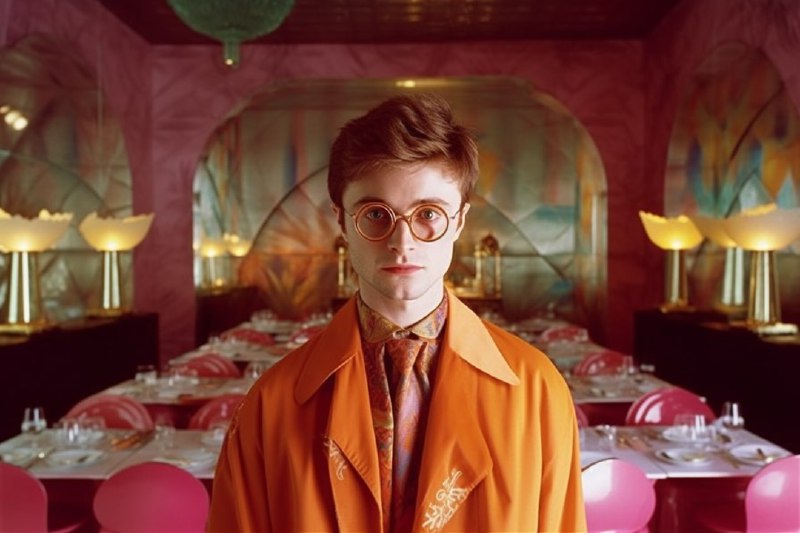
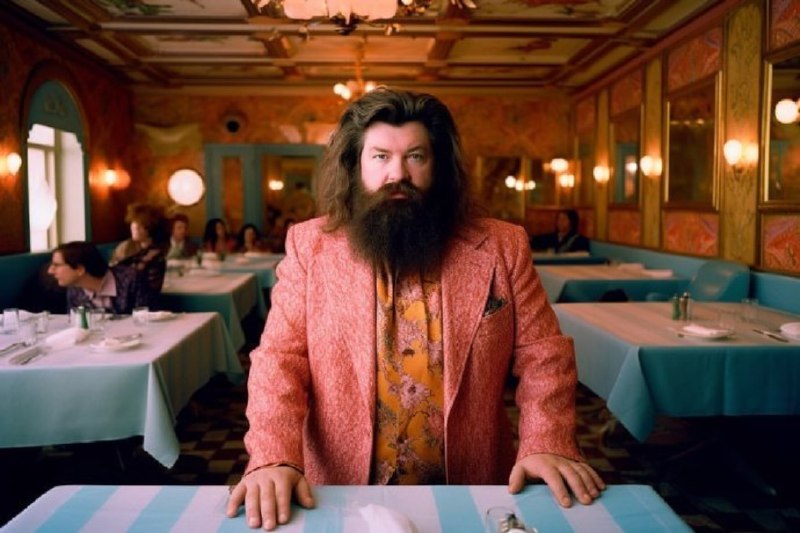
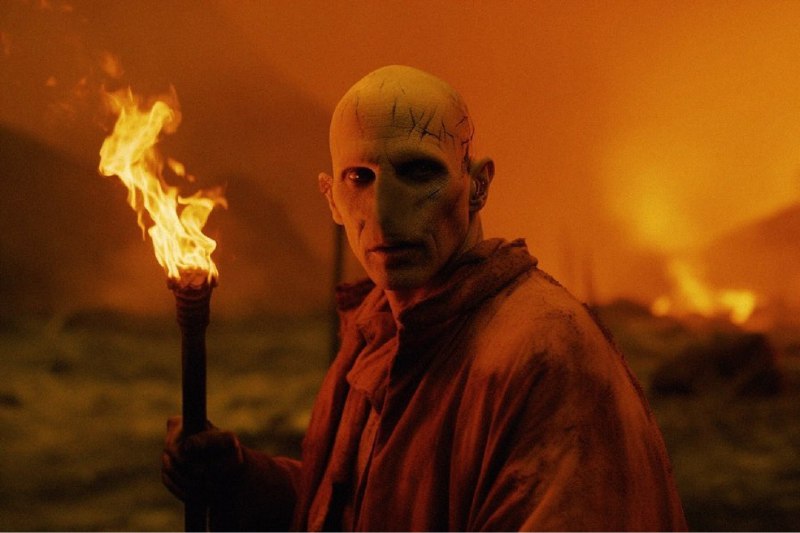
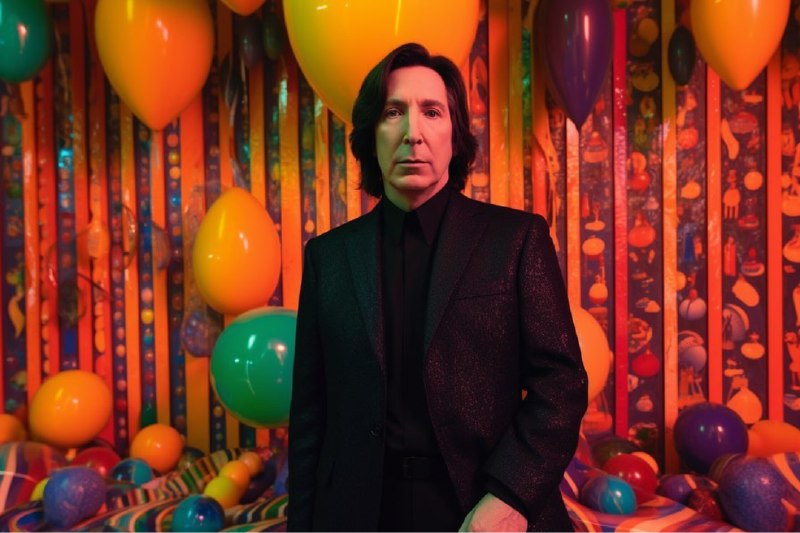
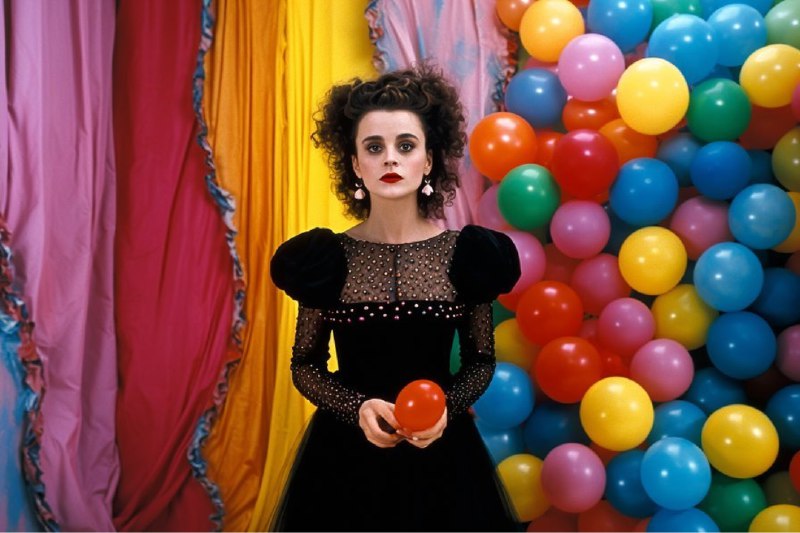
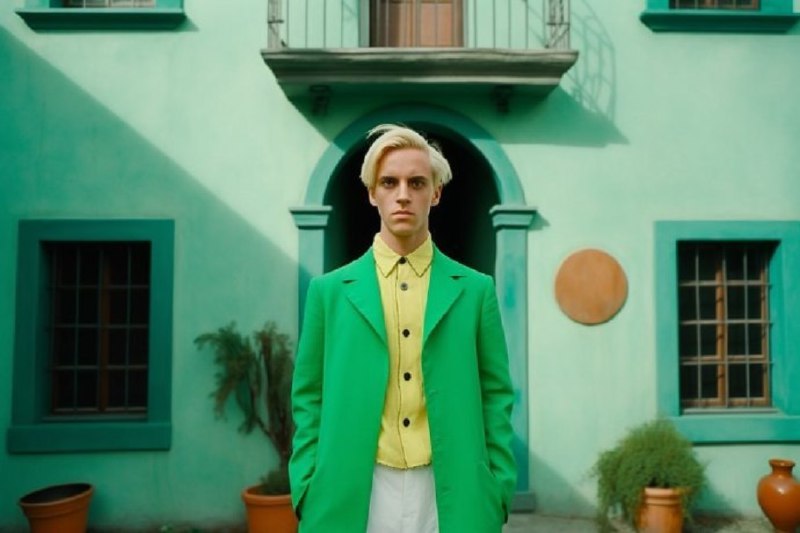
AI探索指南🏩AI韦斯 •安德森版《哈利波特》15:11 · 2023年5月10日 · 周三 × × × × × × × × × 🏩AI韦斯 •安德森版《哈利波特》(图源@Panoramachannel)15:11 · 2023年5月10日 · 周三
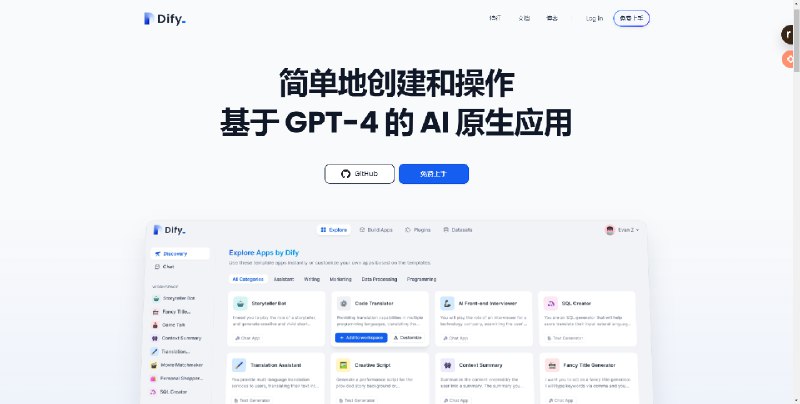
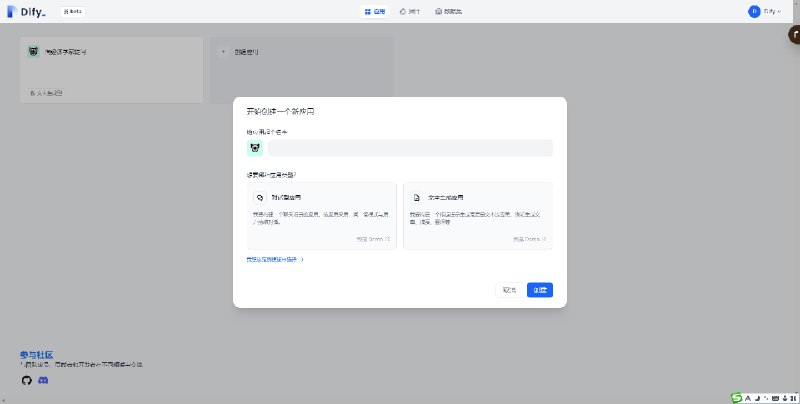
AI探索指南一个可以创建AIGC应用的平台11:38 · 2023年5月10日 · 周三 × × 一个可以创建AIGC应用的平台可以在几分钟内创建 AI 驱动的应用程序,以文档/网页/Notion内容作为AI的语境,自动完成文本预处理、矢量化和分割。您不必再学习嵌入技术,从而节省数周的开发时间。为您的应用程序带来丰富的工具功能:搜索、连接数据库、避免敏感词,甚至访问所有 API。完全兼容 ChatGPT 的插件标准。原生支持 GPT 家族和 Claude 模型,兼容 LangChain 支持的所有 LLM。平台 为模型访问、上下文嵌入、成本控制和数据注释提供了流畅的体验。无论是内部团队使用还是产品开发,您都可以轻松创建 AI 应用程序。平台 原生提供两种类型的应用程序:对话和文本生成。两者都已在 GitHub 上开源。您可以基于它们创建您想要的应用程序。PS:这是国人开发的,可以体验一下。Web:https://dify.ai/11:38 · 2023年5月10日 · 周三