AI探索指南

  1. Yann LeCun离开Meta,

    Yann LeCun离开Meta,
    是扎克伯格这辈子做的最正确的决定。

    灵魂人物和绊脚石,
    有时候就是同一个人。

    LeCun是谁?
    纯粹的科学家,满脑子世界模型和底层智能理论,听着特别高大上。

    但你知道这意味着什么吗?
    意味着他打心眼里看不起现在这套"大力出奇迹"的玩法,什么堆算力、堆数据、撞大运式的AGI,在他眼里都是不入流的。

    这在学术上对不对?
    当然对,无比正确。

    但市场在乎这个吗?
    市场根本不在乎你对不对,市场只看你会不会讲故事。

    你看Sam Altman。
    他跟你聊技术细节了吗?
    没有。
    他给你看什么?
    Sora的震撼视频,GPT-5的想象空间,AGI的终极梦想。

    星辰大海啊朋友们!
    这就是叙事能力。

    再看LeCun的叙事是什么?
    "你们现在搞的都是错的,未来应该这样那样的。"

    一个是狂热的布道者,一个是冷静的批评家。
    你说投资人会相信谁?公众会追随谁?

    所以啊,只要LeCun还在,Meta AI就永远带着那股学术气。它会做出Llama这种优秀的开源模型,会赢得开发者的尊重,但注意啊,"尊重"这个词在资本市场是没有溢价的。

    在这场争夺"AI之王"的战争里,Meta永远差那么一口气。为什么?
    因为从ChatGPT爆发那一刻起,这就不再是技术竞赛了,这是技术、资本、营销、公众想象力的全面战争。

    扎克伯格明白这个道理吗?
    当然明白。
    但他需要LeCun这面旗帜稳定军心,吸引人才。

    可是如果,注意这个"如果",如果LeCun走了呢?
    性质就全变了。

    这等于什么?
    等于扎克伯格彻底甩掉了最后的思想包袱。
    他可以名正言顺地把Meta AI变成一个纯粹的、极具攻击性的商业机器。不再纠结开源还是闭源,不再纠结什么叫"真正的智能"。
    所有资源,一个目标:
    做出比GPT更强的模型,用最强势的方式砸向市场。

    Meta缺什么吗?
    算力有,数据有,人才有。
    它唯一缺的,就是一个抛弃所有顾忌的"野心"。

    LeCun的离开,就是这个野心被释放的发令枪。

    所以你说,LeCun走,到底是好事还是坏事?
    答案已经很明显了,对吧?

  2. 最近关于 AI 泡沫的讨论非常多,我画了两张图来表达我现在的想法

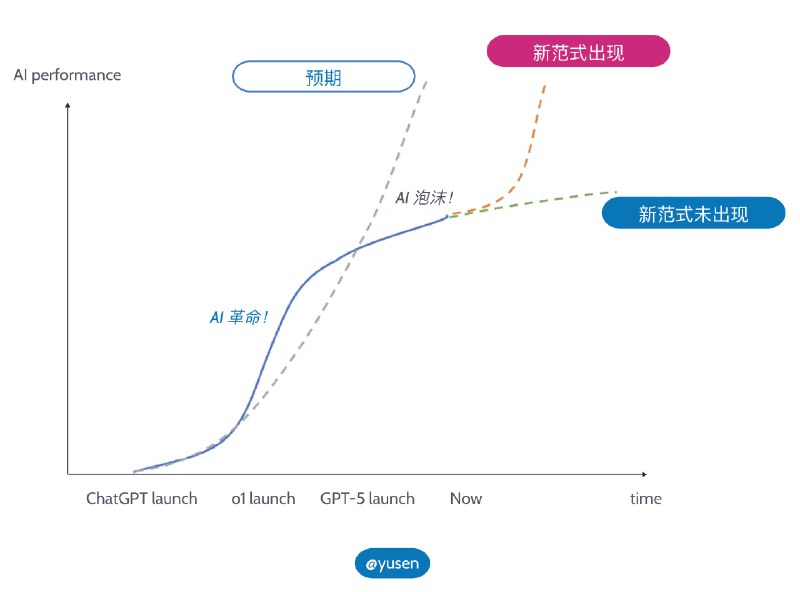
    最近关于 AI 泡沫的讨论非常多,我画了两张图来表达我现在的想法。

    图一:这波以 ChatGPT 为代表的 AI 革命开始后,很多人心中 AI的进展可能像灰色虚线一样,是一个持续指数增长的过程。但实际上,它可能更像是个类似阶跃函数的S曲线。我们现在正在进入已有范式的平台期,所以会看到虽然投入资源增大,但模型的能力提升速度开始放缓。而下一个范式是什么,什么时候能开始应用又很不确定。

    新范式出来的时候,会有一段高速增长,超越预期的过程。而下一个新的范式还没出来的时候,可能就会有一段低于预期的过程。我们现在对未来的很多判断分歧在于,下一个新范式什么时候出现,以及它会是什么。

    图二:但实际上,如果我们退后一步,AI的进步从更宏观的尺度来看,就是不断地由不同的S 曲线范式组合所驱动。每个范式都会经历从低估到高估,从革命到泡沫的过程,而这些范式变化合起来是真正的 Scaling law。

    对新技术短期高估长期低估的amara law大概率会再一次生效,历史不会简单重复,但往往押韵。短期要谨慎,长期要有信心和耐心。

    再补充一点,和互联网相比的话,互联网基于的底层技术没有大的变化,30年前的网站底层技术和30年后差别没有那么大,所以互联网泡沫更多的是一个建设周期带来的波动。而AI的技术变化剧烈得多,10年前的技术栈和现在很不一样,其实叠加了技术周期和建设周期,所以AI带来的预期波动可能会大得多/多得多。

  3. Gemini 3 这么猛吗,一个历史学家测试了 Gemini 3 Pro 破译历史文件

    Gemini 3 这么猛吗,一个历史学家测试了 Gemini 3 Pro 破译历史文件

    他能实现以前模型基本无法完成的历史文件信息破译和推理操作,这些手稿的字说实话没经过学习和训练根本不认识。#ai创造营##gemini3#

    在涉及他没见过的复杂手写字体表格的识别时候,Gemini 3 的表现已经优于受过训练的学生。

    LLM 的“预测式”本质让它在非常规拼写、姓名、地名、日期、金额等低概率元素上易错,而且历史文件里面标点、大小写、长 s(ſ)、度量单位等也高度含混。

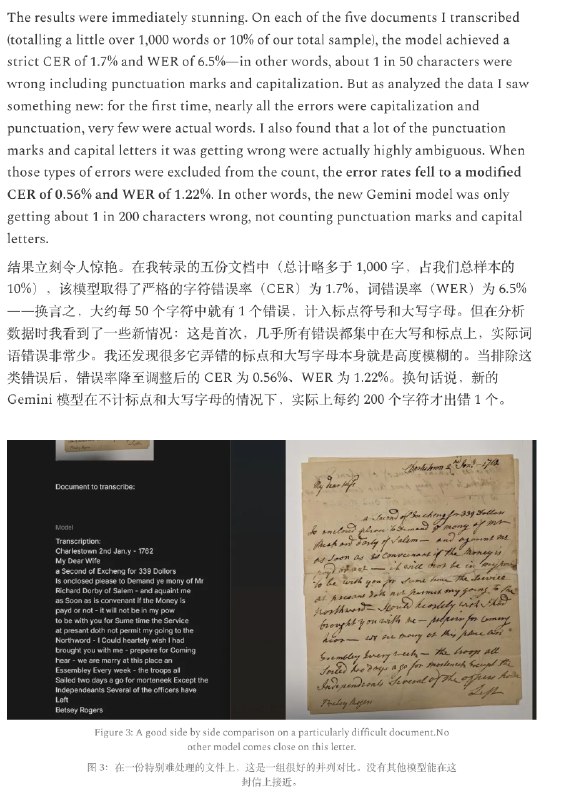
    作者测试了50 份、约 1 万词的英文学术手写样本,涵盖多种书写体与成像条件,用于评估 CER/WER。

    到 Gemini‑2.5‑Pro,在严格计分下约 CER 4%、WER 11%;若排除标点与大小写错误,降至 CER 2%、WER 4%,已逼近专业人工。

    排除一些含混项后,新模型(Gemini 3)降至 CER 0.56%、WER 1.22%,接近或达到“专家人类水平”。与 Gemini‑2.5‑Pro 相比提升 50–70%。

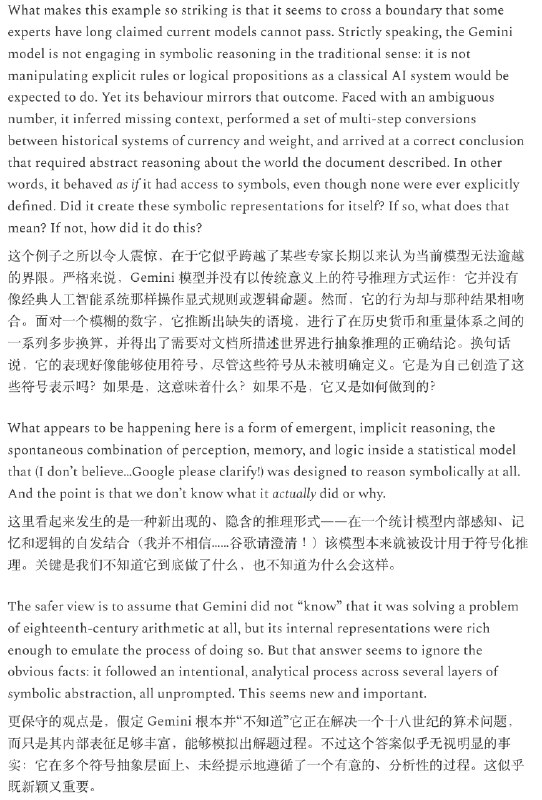
    作者说它似乎跨越了某些专家长期以来认为当前模型无法逾越的界限。

    面对一个模糊的数字,它推断出缺失的语境,进行了在历史货币和重量体系之间的一系列多步换算,并得出了需要对文档所描述世界进行抽象推理的正确结论。换句话说,它的表现好像能够使用符号,尽管这些符号从未被明确定义。

    看起来发生的是一种新出现的、隐含的推理形式——在一个统计模型内部感知、记忆和逻辑的自发结合。

    详情:网页链接

  4. 看了一篇uber 在内部通过 agent 来做业务数据检索的实践,是很标准的 agent 逻辑,值得参考,如果你在产品里还没找到 AI 落地的方式,那么可以做一些内部提效的实践,积累经验

    看了一篇uber 在内部通过 agent 来做业务数据检索的实践,是很标准的 agent 逻辑,值得参考,如果你在产品里还没找到 AI 落地的方式,那么可以做一些内部提效的实践,积累经验

    《Uber 如何构建用于财务分析的对话式 AI 助手:让查数据像给同事发消息一样简单》https://ybzavo65ti.feishu.cn/wiki/SMRLwGE0eiWSfqkmnB8cGCFjn8f?from=from_copylink

    如果想查一些业务数据,要么自己去找风神/灯塔之类的数据后台,要么找数据分析师跑 sql,响应比较慢。于是 uber 做了一个对话式数据助手,在 slack 问 agent 数据问题,agent 直接回复,让数据检索如同向同事发送消息般简单。

    就像老板半夜问我一个数,如果周报里没有现成的,我就要看遍数据集,甚至求DS 帮我跑 sql,然后给老板一个直接、清晰、简洁的答案。

    几年前我和DS 说,能不能以后出来一个人工智能,老板想看什么数据,它就从数据库里跑出来,不要老是找我。DS 对我说,你不就是老板现成的人工智能吗...

    在字节的时候,风神里也有输入自然语言,然后AI 帮我写 sql,但是发现实际用处不大,那些字段、口径,你都不知道水有多深,最终还是要靠 DS。在字节头一年,我学会了数据分析,后两年,我学会了口径分析。

    这里总结一下 uber 的跑数 agent 的核心逻辑,我真希望各个公司都有这样的基建,让跑数不再反人性。

    1. multi-agent 架构

    主 agent做意图识别和分流,子 agent 处理对应的具体任务,比如写 sql。

    关于走 multi 还是 single,我觉得 uber 的场景走 multi 是合理的,因为每个 sub 的任务都比较独立且复杂,在 sub之间的传递信息也都比较明确,而很多业务场景其实用不到 multi架构,直接 single 就可以了。

    2. 数据处理

    最难的是数据源,因为不同数据集的字段都不一样,以及员工的自然语言的术语和数据集的字段名也不一样。如果直接把海量原始数据给 LLM,肯定是跑不出来靠谱的数。有两个关键方法

    1)统一不同数据集的字段:不是直接在包含大量连接的复杂数据库上运行查询,而是做了一个精心策划的、单一表格的数据集市 (curated, single-table data marts) ,作用是为 Finch 提供一个高速、高清晰度、预先整理好的数据源。数据治理一直是难题,是 DS 的泪,一般人都不敢主动碰。我不确定 uber 是否真的解决了这个问题。

    2)统一自然语言和字段名的映射:通过OpenSearch 来存储元数据。这些元数据包含了字段(列名)及其值对应的自然语言别名。这个持续维护也是比较难的。

    3. 效果测评:

    比较标准化,其实就是把环节拆分,分别用有标准答案的 case 来测评,最后端到端再验证。

    1)路由准确性:当用户提出问题时,主 agent需判定应由哪个子agent处理请求。

    2)子 agent 准确度:建一组常见用例,有正确可信的标准答案。通过将agent输出与预期答案比对,能及时发现准确率下降的情况。

    3)端到端验证:通过模拟真实场景的查询来确保从输入到输出的完整流程正常运行。这有助于发现组件单独测试时可能遗漏的系统性问题

  5. 【佐伊】听👉武大郎的绝唱

    【佐伊】听👉武大郎的绝唱
    昨天的恐怖片演绎了现代版真实的你死我活的惊悚。
    今天把镜头拉回来,听一听武大郎临终前的绝唱,不得不说:大郎啊,如果你当初有这样的才华,那潘金莲怎么能出轨呢?

    现在的AI是真强大,药下得也猛,这歌西门庆听了,应该退避三舍。

    有道是:红烛下的海誓山盟,都是虚谎。
    最后只有一句:大郎喝药了,然后流下一滴出卖的泪。
    听一首歌:《出卖》
    Media is too big
    VIEW IN TELEGRAM

  6. 推特和作品就是你最好的简历

    推特和作品就是你最好的简历

    原来在 Replicate 干的 fofr 加入了 DeepMind

    很多人应该都会对这哥们有印象,在 Nano Banana 和 GPT-4o 图像发布的时候都持续产出了非常多好的案例和测试

    估计 Deepmind 想用他补上自己在图像和视频上的宣传路径,哥们这下这结起飞了

    当然,很荣幸老哥也关注了我

  7. 不是官方数字

    AI探索指南
    昨晚 Kimi K2 的训练团队在 Reddit LocalLLaMA 频道做了一次 AMA 看了一下海外用户对于 K2-Thinking 的评价和国内在我评论区的评价还是挺不一样的。 海外用户对价格相对没那么敏感,当然也提到了按调用次数而不是按 Token 这样有些问题,总体来说还是跟关注技术和质量,当然也跟 LocalLLaMA 这个频道的属性有关系。 他们昨晚也在 AMA 里面回答了很多问题,我整理了一些有信息量的: ---------------------------- KDA 会用在下一代旗舰模型…
    不是官方数字。很难量化训练成本,因为很大一部分属于研究和实验。

    在制作 K2 thinking 的过程中,你们遇到的最大挑战是什么?谢谢!

    一个挑战是支持交错的“思考 - 工具 - 思考 - 工具”模式。这在 LLMs 中是相对新颖的行为,实现起来需要大量工作才能正确运行。

    K2 thinking 在几个月来经过许多评测后,已经能抓到 Sonnet 4.5 和 Opus 4.1 漏掉的问题。说实话,感觉 K2 thinking 只差一点系统提示(system prompt)调整就能达到同等水平。这全都要归功于你们的新架构吗?还是你们的训练数据质量也有提升?

    我认为拥有合适的评估方法和数据对性能至关重要。架构和优化器提高了样本效率。

    你们训练堆栈的硬件是什么样的?想了解你们的基础设施如何与那些美国大型公司使用的堆栈相比?

    使用带有 Infiniband 的 H800 GPU;它们不如美国的高端 GPU,而且数量也不占优势,但我们把每一张卡都充分利用起来#ai创造营##kimi#