AI探索指南
IDC有个报告是我从去年就开始注意的:中国大模型公有云服务市场分析,这是对国内AI产业「商品化」最客观也是最真实的数据反馈。它直接反映了大模型的应用规模,而不是把IaaS、PaaS打包一起统计,可以说是Tokens经济最核心的指标。 比如去年中国整个公有云的Tokens调用量几乎是从无到有的飙升到了114.2万亿次,已经呈现出了爆发趋势,前天IDC又更新了今年上半年的报告,Tokens的调用总量达到536.7万亿次,半年的时间干了去年全年接近5倍的活儿。 这张环比数据表(图1)的信息量很大,可以看到2…
但是对于开发者来说,原生化的AI云才是刚需,去买算力部署模型,门槛天然就高,比如我们都知道,DeepSeek已经是大模型里的价格屠夫了,但要训练一套完整的DeepSeek MoE模型,至少需要320张GPU,这就不是普通开发者能说上就上的。所以MaaS这种群众路线的服务才越来越受欢迎,它相当于一家模型商店,把市面上的模型都封装到了云上,开发者不必关心技术细节,只需按量付费,直接调用模型的核心能力——文本生成、图像识别、语音转换等——为己所用。
有个对MaaS模式的体验形容特别恰当:拎包入住,丰俭由人。
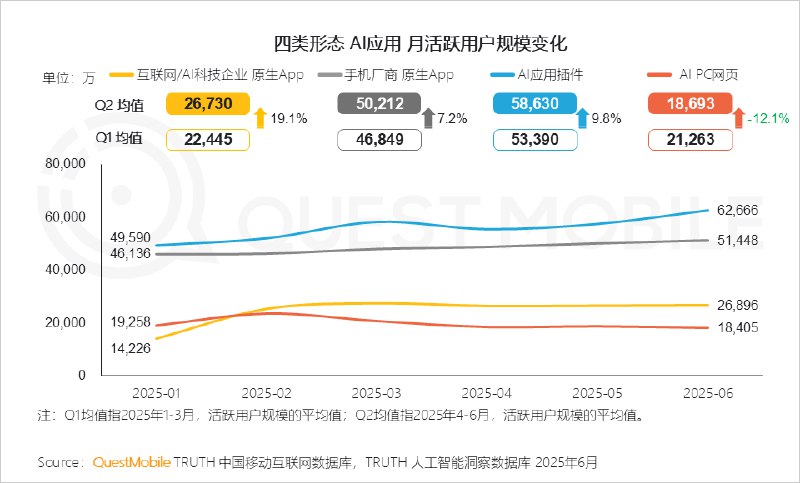
Quest Mobile在2025中国移动互联网半年大报告里也提到过一个点,在国内的AI应用侧,插件产品的规模要明显高于原生产品(图2),什么意思呢,就是大家期待的杀手级App,可能并没有那么快出现,与此同时,AI又已经变得无处不在了,以新功能的形式。
在这个渗透过程里,MaaS市场就是最大的幕后功臣,一个社交产品的开发者,如果想要新增一个AI头像的绘制功能,完全可以不用重复造轮子,专门训练一个图片模型出来,而是可以像去超市购物那样,在MaaS市场里挑一个价格和性能最适合的,然后用接口的方式加到自己的产品里,即开即用。
美国BI平台Databricks的负责人今年也说过来自业务侧的反馈:「大多数企业并不想成为AI专家,他们只是需要开箱化的AI解决方案,而且微调和管理开源模型的复杂性对他们而言依然是一个难以跨越的门槛。」
所以像是OpenAI和Anthropic在面对免费平替的开源模型时还是非常能打,而拥有企业级服务经验的Salesforce和Oracle也在老树新芽般的高速增长,模型的原始智能水平固然重要,但更值钱的地方在于它驱动产品的质量和可用性。
某种意义上,MaaS才是真正的大模型竞技场,像是火山引擎之所以占有率独一档,就是因为它能汇聚市面上最新、最领先的模型,还是用超市的比喻来理解,就是供应链的竞争力制胜,比如Google的新图片模型nano-banana刷屏之后,唯一能跟上硬刚的,就是字节的Seedream 4.0,刚刚登顶LMArena,而在火山引擎,这些顶级模型都在摆货架上「予取予求」。
而且即便有微调和训推需求,火山引擎的Infra效率也是行业领先的,像是DeepSeek-V3.1这种开源模型在火山引擎上的表现指标也非常漂亮,这些都会最终体现到开发者的体验端,形成用量越多、进步越快的正循环。
前几天看到有条推文,说OpenAI曾经明确表示GPT-4o、o1、o3、o3-mini这样说命名对用户来说太不友好了,要用GPT-5来做统一和简化,现在来看,这话OpenAI只做到了一半,确实只有GPT-5一个模型了,然而我们看到迎面走来的方阵分别是:GPT-5、GPT-5 auto、GPT-5 thinking、GPT-5 pro、GPT-5-mini、GPT-5-nano⋯⋯
滑稽.jpg
本质上,模型商品化的主要瓶颈,还是Tokens不够用,于是不得不人为设置各种档位,在让大模型变成自来水那样按需取用的生活资源这件事情上,MaaS平台的用武之地和长期价值,一定会与日俱增。
你们也可以参与预测一下,半年后IDC公布2025年全年中国大模型公有云的Tokens调用量时,会出现一个什么量级的数字?






 #PG电子 #真人百家乐 东南亚最大线上博彩平台

 点击:泰国大老板百家乐存50万出512万 查看记录


 以及多种电子钱包存取款。东南亚国家地区 不限ip U存U取(无须实名)