AI探索指南

  1. 从我的视角上,Manus就是monica这家公司在抓机会能力上的最好体现,但这么解读monica太浅薄了,因为他们工程实践和agent workflow的积累是实实在在的,我参与到的就有23年9-10月首次在国内推出agent,这里面的todolist.md都是当时学习了各家agent方案之后的最佳实践,再到24年3月做gpts平台,24年初开始一直就在做浏览器的技术积累,积累大量对浏览器context利用的理解,23年11月开始做搜索,对于agent联网获取信息的能力也是有积累的

    从我的视角上,Manus就是monica这家公司在抓机会能力上的最好体现,但这么解读monica太浅薄了,因为他们工程实践和agent workflow的积累是实实在在的,我参与到的就有23年9-10月首次在国内推出agent,这里面的todolist.md都是当时学习了各家agent方案之后的最佳实践,再到24年3月做gpts平台,24年初开始一直就在做浏览器的技术积累,积累大量对浏览器context利用的理解,23年11月开始做搜索,对于agent联网获取信息的能力也是有积累的。我没参与的部分,24年7月份通过roast获取社交流量的增长经验,24年11月coding产品中对于各模型coding能力的理解。确实每件事都是相对薄的一层,但这些积木在这个窗口形成的组合创新足够强也是事实。但也就是他们可能既有认知又有足够的工程能力在这个小窗口实现空袭。我觉得最恰当的例子可能是拼多多是一个如果没有黄峥team,有可能不会诞生的产品,因为阿里的怠惰,因为微信流量的窗口,因为团队的累积和努力。

  2. 3. 调用支持多模态输入的模型,输入当前任务要求,从当前浏览的网页中提取有效信息(是否有符合要求的结果,如果不满足要求,返回下一个该点击的 button 元素)

    AI探索指南
    以 manus 为例,拆解以 multi-agent 为基础的通用任务智能体的工作流程: 一. 意图识别 1. 获取用户输入内容,进行必要的意图识别和关键词提取,比如用户输入的是“想去日本旅游,需要一个旅行计划”,拆解之后得到的关键词是: japan-trip,任务类型为:travel 2. 如果用户输入的需求比较简单,不能识别用户的意图,此步骤可以引导用户继续对话,补充更多的信息,或者上传文档 / 图片等资料 二. 任务初始化 1. 用识别出来的任务关键词创建任务文件夹,启动 docker 容器,为后续的任务执行做环境隔离…
    3. 调用支持多模态输入的模型,输入当前任务要求,从当前浏览的网页中提取有效信息(是否有符合要求的结果,如果不满足要求,返回下一个该点击的 button 元素)

    4. 模拟浏览器点击 + 网页滚动行为,拿到更多的网页内容 + 视觉信息,重复几次,直到收集到的内容满足任务要求为止

    5. 把收集到的内容保存到任务文件夹

    这个 search agent 的核心在于模拟用户浏览网页行为,需要用到无头浏览器和多模态模型。

    code agent 和 data-analysis agent 相对而言比较简单:

    1. 根据任务需求,创建本地文件,写入代码(python 代码做数据分析,html 代码做视觉呈现)

    2. 通过系统调用执行代码,把执行结果保存到任务文件夹

    3. 通过 code-preview 服务,预览 html 文件的内容

    ---

    此类 multi-agent 产品,还有一些改进的空间:

    1. todo.md 的多个任务,是线性依赖关系,可以使用 DAG(有向无环图)实现更加复杂的任务依赖

    2. 需要引入自动化测试 agent,对任务结果进行判断和矫正,如果对某个步骤评分过低,需要回溯到之前的某个任务节点重新执行

    3. 允许全自动 + 用户介入的混合模式,在某个步骤执行完,先寻求用户反馈,如果几秒内没收到反馈,则自动继续运行

    ---

    整体评价:manus 在工程层面做了很多工作,整体交互比其他产品好很多。技术层面,依然是没什么壁垒,对模型有比较深的依赖:

    1. 也许有个小模型,做任务执行前的意图识别

    2. 任务规划和推理,用 deepseek-r1

    3. 图片识别 + 代码生成,用 claude-3.7-sonnet

    token 消耗会很高,能不能广泛用起来,取决于谁来负担这个成本。

    最终的任务准确性和用户满意度,还需要更多的案例来说明。

  3. 以 manus 为例,拆解以 multi-agent 为基础的通用任务智能体的工作流程:

    以 manus 为例,拆解以 multi-agent 为基础的通用任务智能体的工作流程:

    一. 意图识别

    1. 获取用户输入内容,进行必要的意图识别和关键词提取,比如用户输入的是“想去日本旅游,需要一个旅行计划”,拆解之后得到的关键词是: japan-trip,任务类型为:travel

    2. 如果用户输入的需求比较简单,不能识别用户的意图,此步骤可以引导用户继续对话,补充更多的信息,或者上传文档 / 图片等资料

    二. 任务初始化

    1. 用识别出来的任务关键词创建任务文件夹,启动 docker 容器,为后续的任务执行做环境隔离

    2. 任务执行过程中的内容产物,写入到任务文件夹,任务结束之后清理 docker 容器

    三. 步骤规划

    1. 使用意图识别的结果 + 补充背景信息,请求一个推理模型,对任务进行步骤拆分

    2. 将任务拆分的步骤信息,写入到任务文件夹的 todo.md

    四. 任务执行

    1. 遍历任务文件夹中的 todo.md,[ ] 表示待执行的任务,[x] 表示已执行的任务

    2. 取出待执行的任务,带上任务上下文信息,做一次 function call,这里带上的 function tools 是系统内置的可以执行不同任务的 agent,比如 search agent / code agent / data-analysis agent

    3. 根据 function call 的结果,调度指定的 agent 执行任务,把执行过程中产生的内容,写入到容器中的任务文件夹

    4. 任务执行完,由主线程,更新 todo.md,继续下一个任务

    五. 归纳整理

    1. todo.md 里面的任务全部执行完之后,主线程针对用户的初始需求,做一次整理输出

    2. 把任务的内容产物,给到用户浏览或下载(文档 / 代码 / 图片 / 链接等)

    3. 收集用户对任务的满意度

    ----

    整个方案理下来,核心在于执行任务的 agent 设计,以及主线程的调度流程,以 search agent 为例,在处理“日本旅行计划”这个任务中,主要的执行步骤:

    1. 拿到 japan-trip 等关键词信息,调用谷歌第三方 API,获取 10-20 条搜索结果

    2. 模拟浏览器点开第一个网页,浏览网页内容,获取网页文本内容 + 浏览器截图拿到网页视觉信息

  4. 刚才连线听了 Manus team 早晨的小型朋友沟通会,几点 takeaway:

    刚才连线听了 Manus team 早晨的小型朋友沟通会,几点 takeaway:

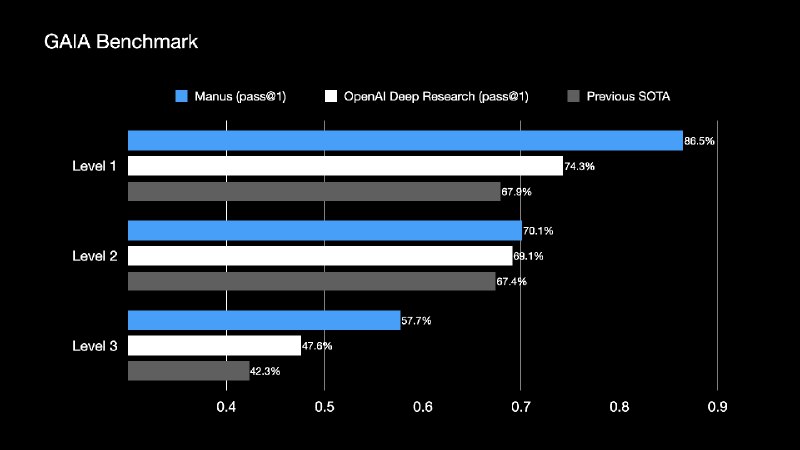
    1. 做产品实现了 SOTA,打榜超越 OpenAI DeepResearch 的那一晚, @PeakJi
    和 @hidecloud 泪洒办公室;

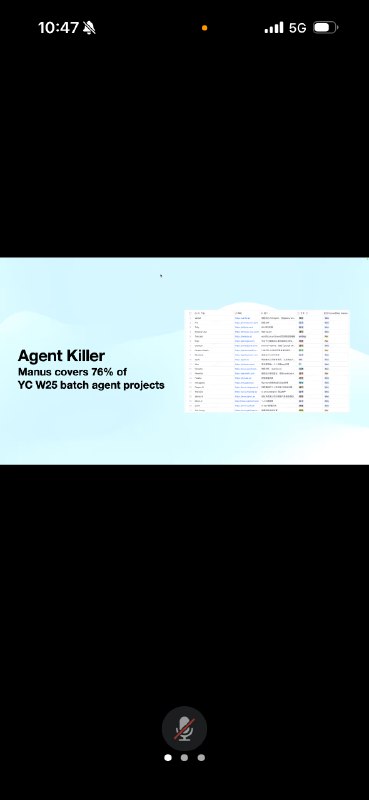
    2. 做垂直领域的 AI Agent “可能有点不靠谱”,Manus 打败了 YC W25 几乎 3/4 的 Agent startups

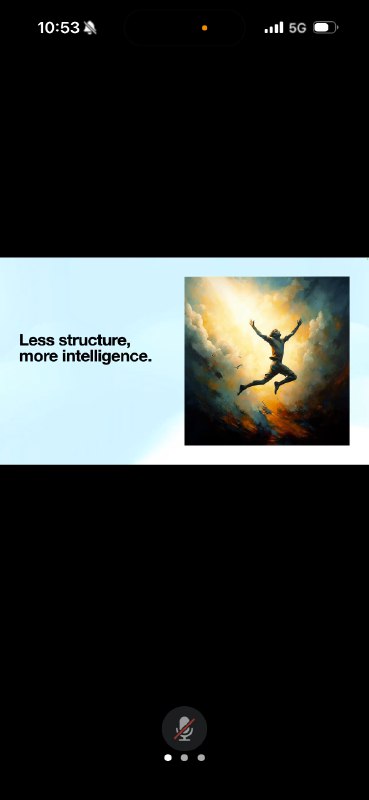
    3. 团队做 Manus 过程中,最关键的一个信念:「Less Structure, More Intelligence」

    5. AI Agent 产品的指标不应该是 DAU,而是:AHPU - Agentic Hours Per User

    6. 从 Manus 开始,AI Agent 相比于 Chatbot,对 token 的消耗是指数级的翻越,今年的推理需求会 100-1000 倍的上涨。利好 NVDIA 和云厂商。

    7. 目前 Manus 单任务成本 2 USD,是远低于业内平均的水平,但仍有继续优化的弹性。

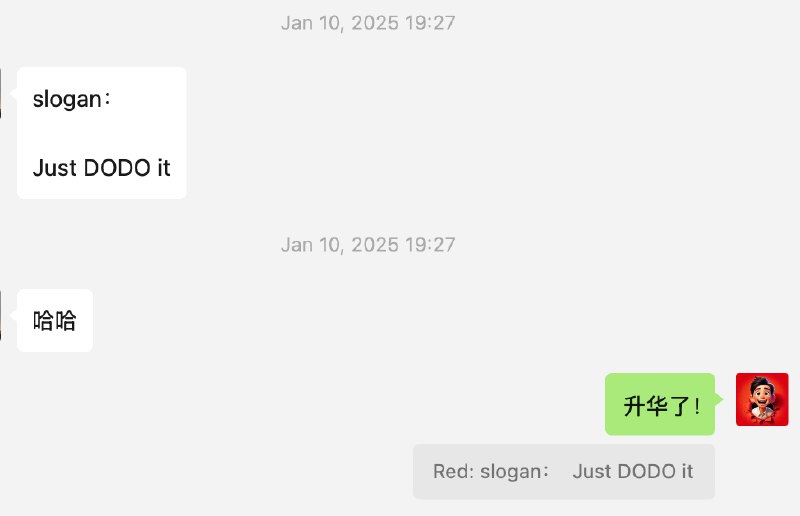
    8. 最后一个(不是今天分享会上提到的)小彩蛋,在给 Manus 起名字时,我也参与了一丢丢脑爆和讨论,一度很上头「dodo.ai」这个名字(域名注册 get),slogan 就叫做「Just DODO it」,会非常有记忆点。但最后选择「Manus」,它是拉丁语中「手」的意思。

    9. 从 2025 年开始,AI 要卷的不再是「思考」能力,而是「行动」能力,这也是「十字路口」2025 开年第一期播客,和 @yusen(同样是 Manus 投资人)对谈的标题:《2025 开年对谈: AI 关键之年,Agent 开启元年》

    ————
    看到 Manus 掀起这样的热浪,我从昨晚到现在都非常兴奋,this is the best age.

    也想起昨天「暗涌」文章末尾的这句话:等到 2035 年,回看这十年发生什么,我赌 AI 跟机器人会到处都是,新一代的创业者还会打造更多大疆和 DeepSeek。那时候,我们一定会清醒自己经历了以最好的 vintage。

  5. 知识记忆: Manus AI 学习到用户偏好电子表格格式,下次处理类似简历筛选任务时,将直接提供电子表格结果

    AI探索指南
    @小宏 团队发布 Manus 真正自主的代理,它能够独立完成复杂的任务,而不仅仅是生成想法 演示看起来非常牛皮,希望能用一下 官网展示了各种具体的用例,点开会直接开始回放 这个演示方式值得学习 下面是Gemini总结的产品核心理念和具体用例介绍: 🌟核心理念: 自主执行力: Manus AI 不仅仅停留在生成想法的层面,它能够将指令转化为实际行动,交付最终结果。 类人工作模式: Manus AI 模拟人类的工作方式,例如,它可以解压缩文件、浏览网页、阅读文档,并从中提取重要信息。 云端异步工作:…
    知识记忆: Manus AI 学习到用户偏好电子表格格式,下次处理类似简历筛选任务时,将直接提供电子表格结果。

    2️⃣案例 2:房产研究

    任务描述: 为用户在纽约购买房产进行研究,需满足以下条件:安全的社区、低犯罪率、优质的中小学和幼儿园、预算范围在每月 5 万美元收入可负担的范围内。

    Manus AI 的操作:

    任务分解: Manus AI 将复杂任务分解为待办事项列表,包括研究安全社区、识别优质学校、计算预算、搜索房产等。

    信息检索: Manus AI 通过网络搜索,仔细阅读有关纽约最安全社区的文章,收集相关信息。

    学校研究: 检索纽约的中学信息,并进行整理。

    预算计算: 编写 Python 程序,根据用户收入计算可负担的房产预算。

    房产筛选: 利用 Redfin 等房地产网站,根据预算范围筛选房产列表。

    综合报告: 整合所有收集的信息,撰写详细报告,包括社区安全分析、学校质量评估、预算分析、推荐房产列表以及相关资源链接。

    3️⃣案例 3:股票分析

    任务描述: 分析过去三年中英伟达 (NVDA)、迈威尔科技 (MRVL) 和台积电 (TSM) 股票价格之间的相关性。

    Manus AI 的操作:

    数据获取: Manus AI 通过 API 访问权威数据源 (Yahoo Finance API),获取股票历史数据。

    数据验证: 验证获取的数据的准确性。

    代码编写: 编写 Python 代码进行数据分析和可视化。

    统计分析: 进行统计相关性分析,包括皮尔逊相关系数、滚动相关性等。

    可视化呈现: 生成数据可视化图表,包括股票价格时间序列图、相关性热图、散点图、滚动相关性图表等。

    报告生成: 撰写综合分析报告,解释图表结果,总结主要发现和投资启示。

    网页部署 (额外功能): 用户提出希望以交互式网站形式展示数据,Manus AI 立即执行,创建包含 HTML、CSS 和 JavaScript 的交互式网站,并部署到公共网络,提供可分享的链接。

  6. @小宏 团队发布 Manus

    @小宏 团队发布 Manus

    真正自主的代理,它能够独立完成复杂的任务,而不仅仅是生成想法

    演示看起来非常牛皮,希望能用一下

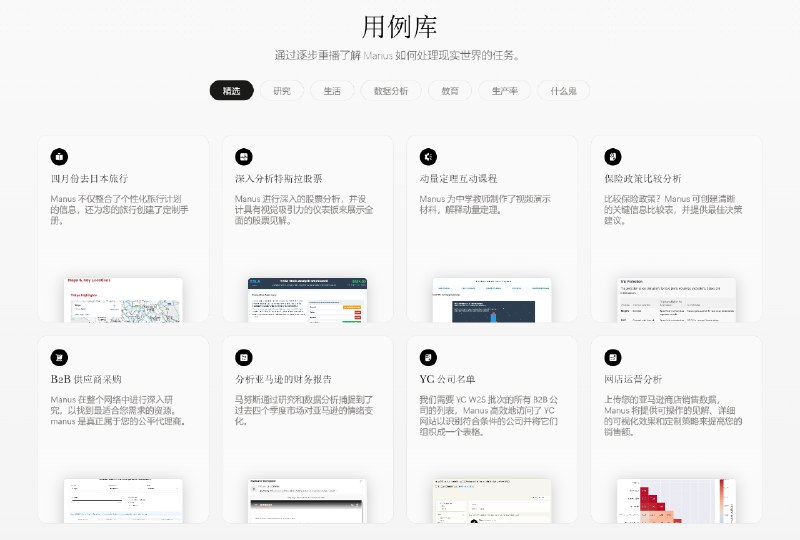
    官网展示了各种具体的用例,点开会直接开始回放

    这个演示方式值得学习

    下面是Gemini总结的产品核心理念和具体用例介绍:

    🌟核心理念:

    自主执行力: Manus AI 不仅仅停留在生成想法的层面,它能够将指令转化为实际行动,交付最终结果。

    类人工作模式: Manus AI 模拟人类的工作方式,例如,它可以解压缩文件、浏览网页、阅读文档,并从中提取重要信息。

    云端异步工作: Manus AI 在云端异步运行,用户可以随时关闭电脑,任务会在后台持续执行,完成后会通知用户。

    持续学习和记忆: Manus AI 拥有自己的知识和记忆,可以从用户的反馈中学习,并在处理类似任务时应用学到的知识,提高效率和准确性。

    人机协作新范式: Manus AI 被视为人机协作的新范式,旨在扩展人类的能力,放大影响力,并将人类的愿景变为现实。

    “心智与手” (Mens et Manus): 软件的名字“Manus”来源于拉丁语 “Mens et Manus”,意为“心智与手”,象征着知识必须被应用于世界,产生实际影响。

    案例总结

    视频中展示了 Manus AI 在三个完全不同的任务中的应用,突出了其通用性和强大的执行力:

    1️⃣案例 1:简历筛选

    任务描述: 筛选 15 份简历,为强化学习算法工程师职位推荐合适的候选人,并根据其强化学习专业知识对候选人进行排名。

    Manus AI 的操作:

    接收数据: 用户上传包含 10 份简历的 ZIP 文件,随后又补充上传 5 份简历。

    自主处理: Manus AI 解压文件,逐页浏览并分析每份简历,提取关键信息。

    智能分析: 根据岗位要求和候选人简历中的项目经验、强化学习专业知识等进行评估。

    生成结果: Manus AI 生成排名建议,将候选人分为不同等级(例如:高级候选人、具有基本强化学习经验的候选人、无强化学习经验的候选人),并提供候选人资料和评估标准等支持材料。

    灵活调整输出格式: 用户提出希望以电子表格形式呈现结果,Manus AI 立即学习并执行,安装必要的 Python 库 (pandas, openpyxl),编写 Python 脚本,并将结果整理成 Excel 电子表格。

  7. 这里我们可以要求 Claude 用 CDN 引用 TailwindCSS 来写组件样式,Tailwind CSS 封装了一套非常美观和简洁的样式,可以让 Claude 直接调用,确保在色彩、响应式和基础组件的美观度不出大问题

    AI探索指南
    最近很多人问我,为啥我用 Claude 写的应用就没那么漂亮? 所以教大家一些非常简单的技巧,用上了以后你也能搞定这么漂亮的界面 👇下面是具体的技巧和完整提示词 完整内容这里:https://mp.weixin.qq.com/s/tUOAfd4OI56QxD94-0PPKw 1️⃣第一个技巧: 不用非得用语言来描述你想要的界面样式,可以去一些设计平台找一些你喜欢的设计稿将图片上传到图片让模型参考。 如果你不知道去哪找的话,国内推荐站酷、海外的话推荐 Dribbble 和 Layers。 在跟…
    这里我们可以要求 Claude 用 CDN 引用 TailwindCSS 来写组件样式,Tailwind CSS 封装了一套非常美观和简洁的样式,可以让 Claude 直接调用,确保在色彩、响应式和基础组件的美观度不出大问题。

    🌟提示词:

    方括号[]的部分就是你需要填写的部分。

    我需要创建一个[具体描述你的页面/组件类型],请帮我生成美观且响应式的HTML+CSS代码。

    ## 设计参考
    我希望设计风格类似于以下参考:
    [上传参考图片或描述设计灵感来源]

    ## 技术要求
    - 请使用HTML、TailwindCSS和少量必要的JavaScript
    - 引用Tailwind CSS(v3.0+)通过CDN
    - 页面需完全响应式,在移动设备和桌面端都能良好显示

    ## 图片资源
    - 请使用Unsplash API提供的图片作为内容图片
    - 根据内容主题选择合适的关键词

    ## 图标要求
    - 使用Font Awesome或Material Icons等专业图标库 (通过CDN引用)
    - 避免使用emoji作为图标替代品

    ## 交互细节
    [描述任何需要的交互动画或效果,例如:]
    - 按钮悬停时有轻微放大效果
    - 表单输入框聚焦时显示渐变边框
    - 卡片在悬停时有阴影加深效果

    ## 特别注意
    - 确保代码干净且有适当注释
    - 提供完整可运行的HTML文件,包含所有必要引用
    - 优化视觉层次和间距,确保设计美观专业

    5️⃣如何生成设计稿:

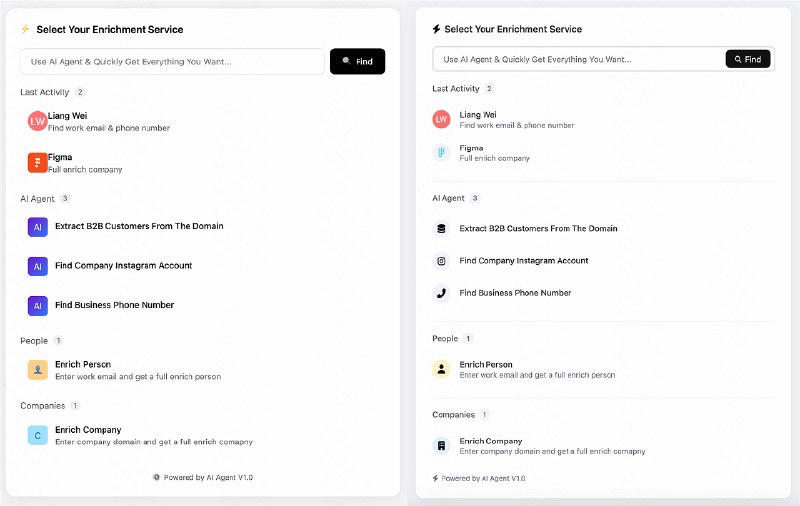
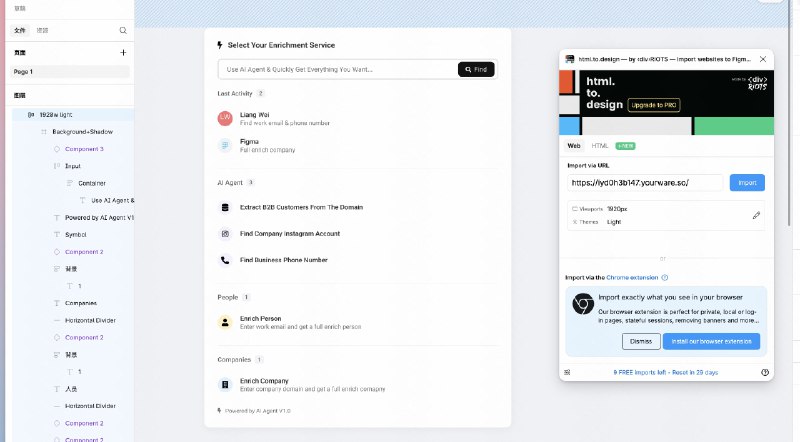
    昨天群里一个朋友提了一嘴能不能转设计稿想了一下,居然还真可以,而且可以帮你生成带自动布局的 Figma 设计稿和对应可复用的组件。具体的方法也很简单

    只需要将你生成的代码部署到线上,如果你用 Claude 或者 POE 都有这个功能,如果你用的软件没有发布能力的话可以用这个 http://yourware.so 产品。

    获得了线上的链接之后,我们只需要使用 http://html.to.design 这个 Figma 插件就可以很好的将网页转换为

  8. 最近很多人问我,为啥我用 Claude 写的应用就没那么漂亮?

    最近很多人问我,为啥我用 Claude 写的应用就没那么漂亮?

    所以教大家一些非常简单的技巧,用上了以后你也能搞定这么漂亮的界面

    👇下面是具体的技巧和完整提示词

    完整内容这里:https://mp.weixin.qq.com/s/tUOAfd4OI56QxD94-0PPKw

    1️⃣第一个技巧:

    不用非得用语言来描述你想要的界面样式,可以去一些设计平台找一些你喜欢的设计稿将图片上传到图片让模型参考。

    如果你不知道去哪找的话,国内推荐站酷、海外的话推荐 Dribbble 和 Layers。

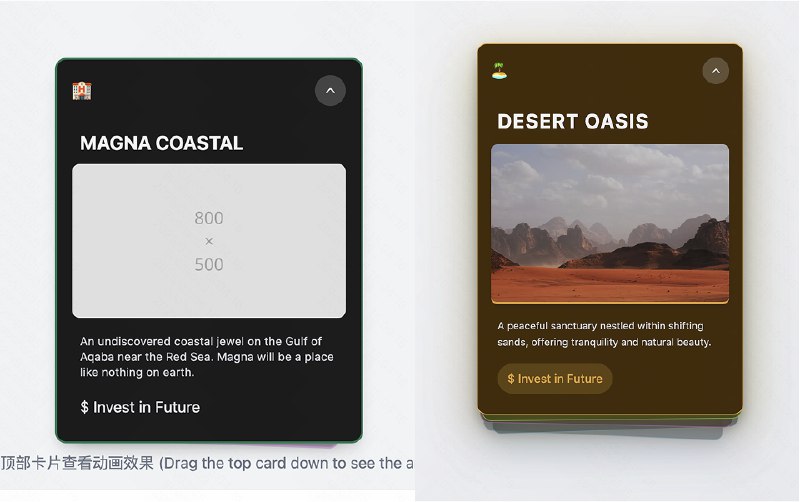
    在跟 Claude 说的时候就可以忽略那些不好描述的地方,重点描述静态图片无法表现的部分,比如下面的这个卡片组件。

    我就让 Claude 注意交互的动画和输入框聚焦之后的渐变动画上,界面内容和风格就让他按图片生成。

    2️⃣第二个技巧:

    在让 Claude 生成界面的时候,你会发现 Claude 生成的页面没有图片,本来应该是图片的部分经常是空白的,这个就很影响结果的视觉表现。

    其实我们可以要求他引用一些在线的图片来填充到页面需要图片的部分。

    这里首先推荐 unsplash,他是一个开源图片网站,里面有世界各地的设计大神上传的图片,而且可以直接引用。

    可以看下面加上图片之后的卡片是不是就好看很多了。

    3️⃣第三个技巧:

    另外 claude 在生成页面的时候本来应该是图标的地方,他喜欢用 emoji 来代替,emoji 也很好,但是在一些严肃的页面上就会显得格格不入。

    这里可以要求 Claude 在生成页面的时候引用在线的图标库,比如Font Awesome或Material Icons,这些开源图标库可以通过 CDN 直接引用,而且不需要部署。

    可以看到引用了 Font Awesome 图标库的图标之后我们的界面变得更加简洁和整齐。

    4️⃣第四个技巧:

    我们常用的前端样式代码是用 CSS 写的,但是 CSS 本身的一些样式其实没有太考虑美观度的要求。

    这就导致你让 Claude 写样式的时候他就会过渡自己发挥,美观度也就没办法得到保障,而且你对样式要求多之后他要从头写的 CSS 也就越多浪费很多 Token。