AI探索指南
- KREA 发布了他们图像放大功能的 2.0 版本,从演示来看似乎跟 Magnific AI 不相上下了。#ai画图#
可以免费试用,但是需要排队,时长有点离谱,不过整体来看还是比Magnific AI便宜。
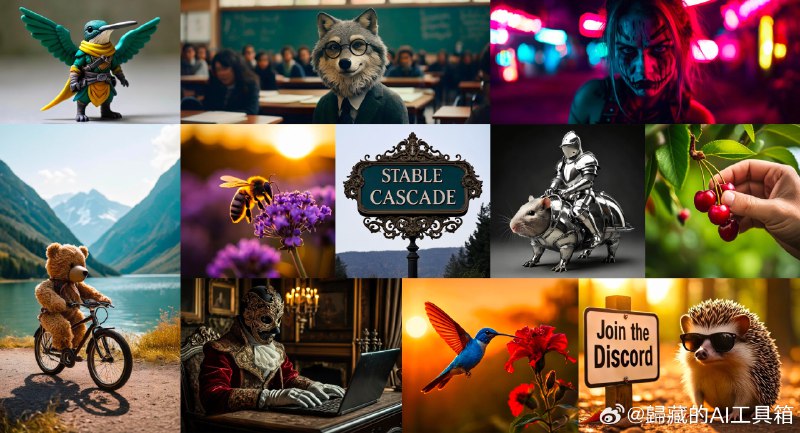
这里尝试:网页链接歸藏的AI工具箱的微博视频 - Stability AI产量很高啊,推出了一个新的 AI 图像生成模型Stable Cascade,还会发布对应的微调、ControlNet 和 LoRA 训练的脚本。#ai画图#
这个模型基于Würstchen架构,可以显著降低模型训练的算力成本,比 SD2.1 的算力成本降低了 10 倍左右。另外推理速度会比现有的 SD 模型快一倍左右。
更多功能:
除了标准的文本到图像生成之外,Stable Cascade 还可以执行图像变化和图像到图像生成。
会跟随模型一起发布的 Controlnet:
局部重绘:输入与文本提示附带的蒙版配对的图像。该模型根据提供的文本提示填充图像的遮罩部分。
Canny Edge:通过跟踪输入到模型的现有图像的边缘来生成新图像。该测试也可以从草图进行扩展。
2x超分辨率:也可用于C阶段生成的潜在空间。
了解更多:网页链接 - 试了一下Leiapix 这个可以提取图片深度信息,然后生成运镜视频的产品。#ai视频#
效果还挺好的,自定义选项也很丰富,一些简单的场景运镜视频不用视频生成工具用这个也挺好。
直接上传图片然后再右侧调整选项就行。
这里尝试:网页链接歸藏的AI工具箱的微博视频 - 配音演员新出路?
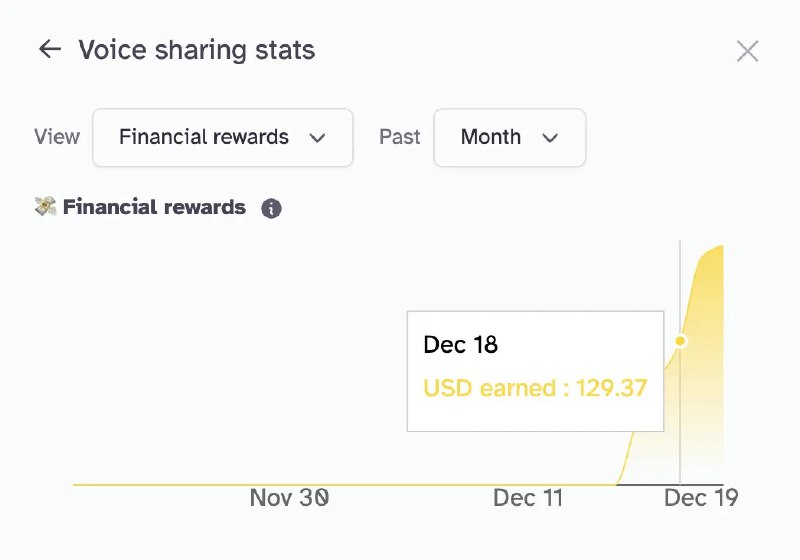
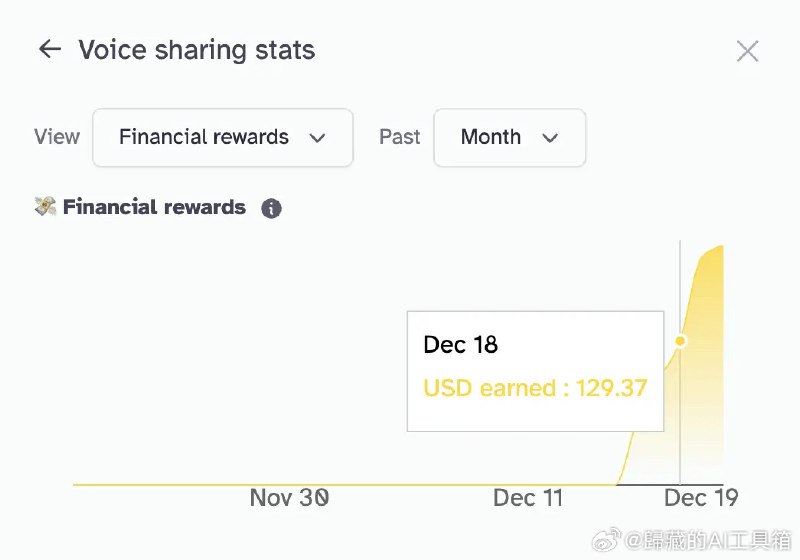
ElevenLabs 现在可以在语音库中分享自己的声音模型,并获得收益。
只需要 30 分钟的音频用于训练。工作原理如下:
前往 VoiceLab 并上传 30 分钟以上的音频
命名并描述你的声音
设置价格和使用参数
添加付款详细信息
了解更多:elevenlabs.io/voice-actors - 配音演员新出路?
ElevenLabs 现在可以在语音库中分享自己的声音模型,并获得收益。
只需要 30 分钟的音频用于训练。工作原理如下:
前往 VoiceLab 并上传 30 分钟以上的音频
命名并描述你的声音
设置价格和使用参数
添加付款详细信息
了解更多:elevenlabs.io/voice-actors
- 一个只会放屁的笨蛋机器人,在日本卖疯了
“与弱机器人一起生活的人们可以创造一个宽容的社会。”“自己做不到的事,让别人帮忙不也挺好,如果不能相互依赖,我们会越来越孤独,也越来越傲慢。”“强者或许让人倾慕,而建立信任、拉近距离,往往都从暴露弱点开始。”