AI探索指南

  1. 中,约60%的购物会会调用Rufus,使用者的购买概率是非使用者的2.74倍

    中,约60%的购物会会调用Rufus,使用者的购买概率是非使用者的2.74倍。这说明AI正在改变消费决策的本质,从“浏览-筛选-决策”到“需求表达-AI匹配-确认”。一旦这种模式成为主流,传统的搜索广告、信息流推荐、甚至品牌本身的触达方式都可能被重构。
    广告正在成为新的收入来源
    OpenAI从2026年2月开始在ChatGPT中测试广告,到5月已有约17%的日活用户看到过广告,早期采用者集中在软件和购物类品牌。同时头部AI厂商的广告支出也在急剧增加,OpenAI的广告支出同比增长800%,Anthropic增长1184%,这意味着AI公司正在用更主动的方式争夺用户注意力。
    亚洲市场的结构性差异
    亚洲是AI应用下载量最大的市场,但2026年第一季度下载量出现了3.3%的下滑,北美和欧洲在消费支出上继续领先。这种“高下载低付费”的结构意味着在亚洲市场,单纯的用户规模增长已经不够,如何将流量转化为收入才是真正的挑战。
    市场集中度与后来者的机会
    ChatGPT、Gemini和Claude合计占据了AI助手应用总使用时长的89%,在AI助手和AI陪伴类应用中,新进入者的占比已从2024年第一季度的超过三分之二降至2026年第一季度的15%以下。新玩家进入头部榜单的难度正在快速增加,但亚洲是例外,其新进入者占比仍然明显高于全球平均水平。
    几点判断
    这份报告描绘的是一个正在加速分化的市场,用户规模还在增长,但增长本身不再是竞争的唯一维度。付费转化率、ARPU、用户使用时长这些指标,正在成为衡量产品价值的关键标尺。
    市场集中度越来越高,意味着后来者想要进入头部阵营的窗口正在收窄。但对于已经站稳脚跟的玩家来说,挑战同样存在。ChatGPT份额的持续下滑说明规模优势可以被侵蚀,用户的忠诚度比想象中要低。
    AI对消费决策链路的影响正在从边缘走向中心,当用户开始习惯通过AI助手完成产品发现、比较和购买决策,品牌触达用户的方式、电商平台的流量分配逻辑都可能被重新定义。
    @aigc1024

  2. ChatGPT全球份额首次跌破50%,AI的游戏规则变了

    ChatGPT全球份额首次跌破50%,AI的游戏规则变了
    生成式AI应用正处在一个微妙的转折点上,用户规模仍在扩张,但增长动力和竞争规则已经变了。
    Sensor Tower的《State of AI 2026》报告提供了一组核心数据,勾勒出了这一变化的轮廓,也揭示了行业正在从“拼规模”转向“拼深度”。
    市场格局:一家独大的时代结束了
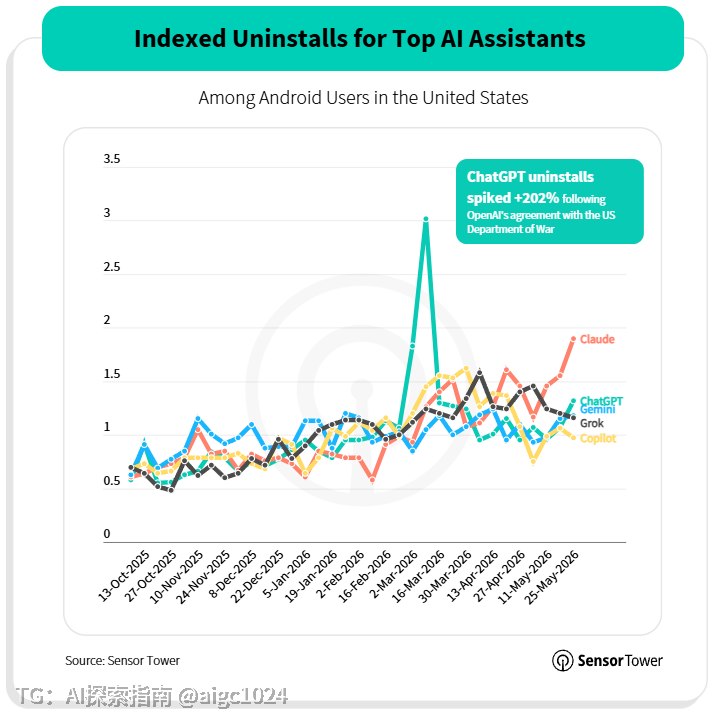
    据Sensor Tower估算,ChatGPT在2026年5月成为了有史以来最快达成10亿月活的应用,仅用了三年,但它的统治力正在被侵蚀。
    2026年3月,ChatGPT在全球AI助手市场的份额首次跌破50%,到5月底已降至46.4%。Gemini的市场份额升至27.7%,Claude达到了10.3%,这说明用户开始在不同AI助手之间切换。
    2026年上半年,全球AI应用下载量预计接近23亿次,用户支出超过42亿美元,总使用时长预计从2025年上半年的172亿小时增长到360亿小时。与此同时,市场也在走向成熟,下载和支出增速已经明显放缓。
    商业化路径的分化:规模与深度之争
    市场规模扩大的同时,变现效率出现了显著分化。Claude在移动端的美国市场ARPU从2025年9月的不到0.50美元,飙升至2026年5月的2.76美元。ChatGPT在同一时期的ARPU是1.74美元,这个差距背后是两种不同的商业化逻辑。
    Claude的定价策略从一开始就瞄准生产力场景,它的付费方案没有低价层,起步就是每月20美元。结果是13%的Claude用户选择付费,这是所有主要AI助手中最高的转化率。用户转化率高,意味着进入这个生态的用户更精准、付费意愿更强。
    ChatGPT的免费模式让它获得了巨大的用户基数,但在约9亿周活用户中,只有大约5000万付费订阅。这种方式带来了规模效应和网络效应,但也稀释了每位用户的平均收入。
    Gemini选择了一条中间路线,它依托Google生态的整合优势,将AI能力嵌入搜索、生产力工具和Android设备。这种模式在获取用户方面有天然优势,但在直接变现上需要更长的时间窗口。
    AI正在重写消费决策链路
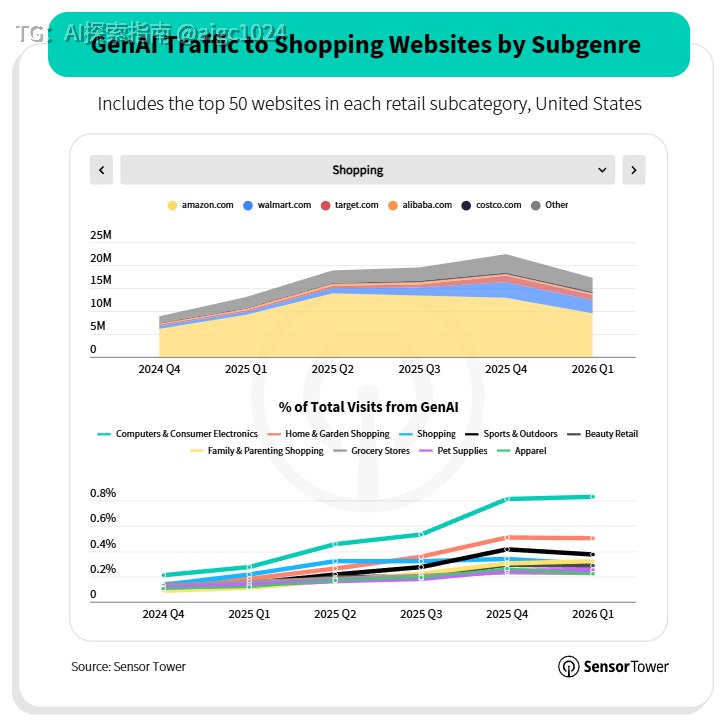
    2024年第四季度到2026年第一季度,生成式AI向零售网站的引荐流量在所有主要零售品类中都在增长,计算机与消费电子、家居与园艺、运动与户外等高决策成本品类的采用率更高。
    亚马逊的AI购物助手Rufus是一个典型案例,使用Rufus的用户转化率接近非使用者的两倍。在深度用户群体中,约60%的购物会会调用Rufus,使用者的购买概率是非使用者的2.74倍。这说明AI正在改变消费决策的本质,从“浏览-筛选-决策”到“需求表达-AI匹配-确认”。一旦这种模式成为主流,传统的搜索广告、信息流推荐、甚至品牌本身的触达方式都可能被重构。
    广告正在成为新的收入来源
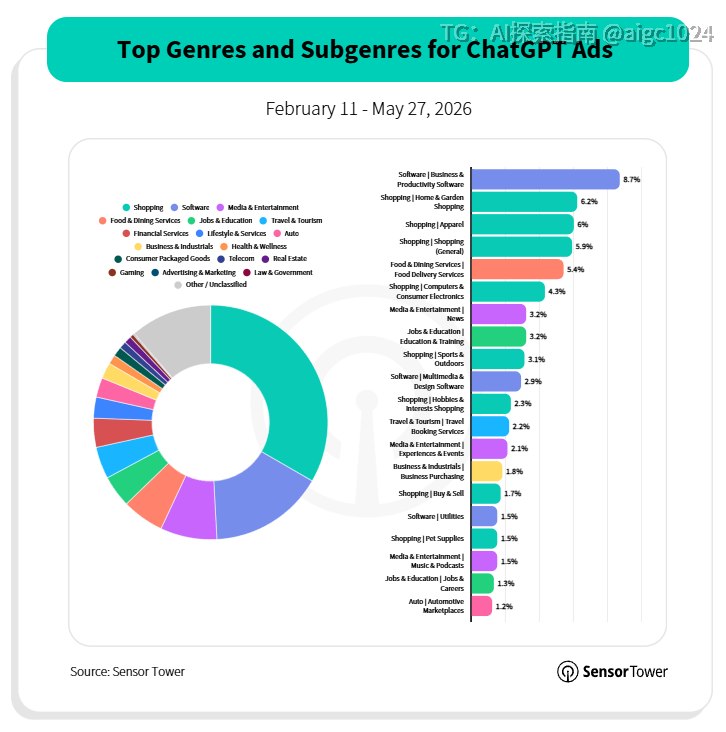
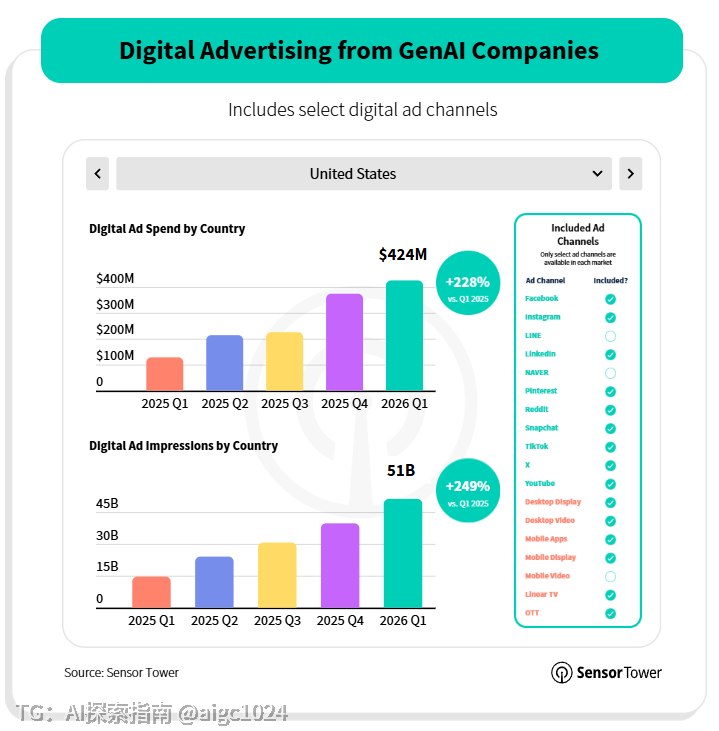
    OpenAI从2026年2月开始在ChatGPT中测试广告,到5月已有约17%的日活用户看到过广告,早期采用者集中在软件和购物类品牌。同时头部AI厂商的广告支出也在急剧增加,OpenAI的广告支出同比增长800%,Anthropic增长1184%,这意味着AI公司正在用更主动的方式争夺用户注意力。
    亚洲市场的结构性差异
    亚洲是AI应用下载量最大的市场,但2026年第一季度下载量出现了3.3%的下滑,北美和欧洲在消费支出上继续领先。这种“高下载低付费”的结构意味着在亚洲市场,单纯的用户规模增长已经不够,如何将流量转化为收入才是真正的挑战。
    市场集中度与后来者的机会
    ChatGPT、Gemini和Claude合计占据了AI助手应用总使用时长的89%,在AI助手和AI陪伴类应用中,新进入者的占比已从2024年第一季度的超过三分之二降至2026年第一季度的15%以下。新玩家进入头部榜单的难度正在快速增加,但亚洲是例外,其新进入者占比仍然明显高于全球平均水平。
    几点判断
    这份报告描绘的是一个正在加速分化的市场,用户规模还在增长,但增长本身不再是竞争的唯一维度。付费转化率、ARPU、用户使用时长这些指标,正在成为衡量产品价值的关键标尺。
    市场集中度越来越高,意味着后来者想要进入头部阵营的窗口正在收窄。但对于已经站稳脚跟的玩家来说,挑战同样存在。ChatGPT份额的持续下滑说明规模优势可以被侵蚀,用户的忠诚度比想象中要低。
    AI对消费决策链路的影响正在从边缘走向中心,当用户开始习惯通过AI助手完成产品发现、比较和购买决策,品牌触达用户的方式、电商平台的流量分配逻辑都可能被重新定义。
    @aigc1024
  3. ChatGPT全球份额首次跌破50%,AI的游戏规则变了

    ChatGPT全球份额首次跌破50%,AI的游戏规则变了
    生成式AI应用正处在一个微妙的转折点上,用户规模仍在扩张,但增长动力和竞争规则已经变了。
    Sensor Tower的《State of AI 2026》报告提供了一组核心数据,勾勒出了这一变化的轮廓,也揭示了行业正在从“拼规模”转向“拼深度”。
    市场格局:一家独大的时代结束了
    据Sensor Tower估算,ChatGPT在2026年5月成为了有史以来最快达成10亿月活的应用,仅用了三年,但它的统治力正在被侵蚀。
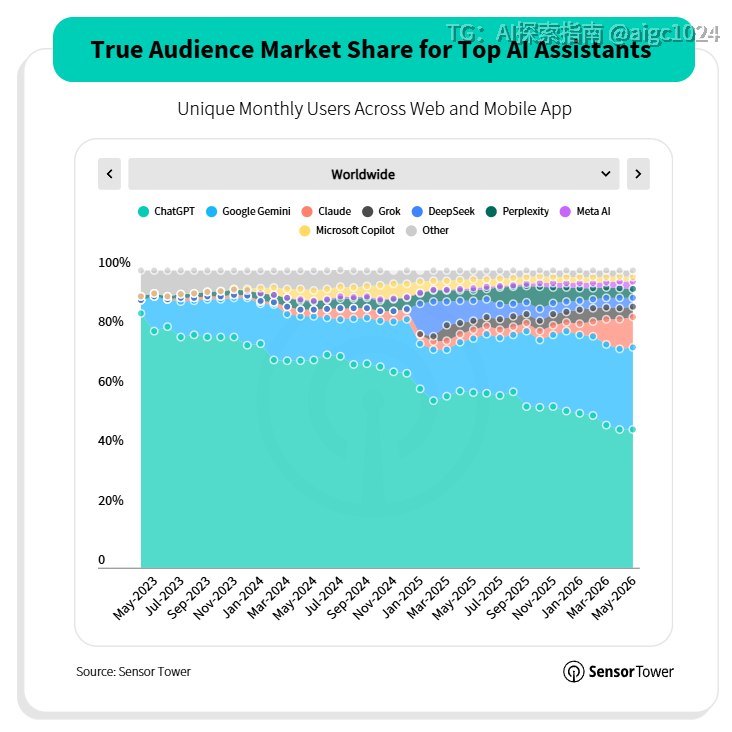
    2026年3月,ChatGPT在全球AI助手市场的份额首次跌破50%,到5月底已降至46.4%。Gemini的市场份额升至27.7%,Claude达到了10.3%,这说明用户开始在不同AI助手之间切换。
    2026年上半年,全球AI应用下载量预计接近23亿次,用户支出超过42亿美元,总使用时长预计从2025年上半年的172亿小时增长到360亿小时。与此同时,市场也在走向成熟,下载和支出增速已经明显放缓。
    商业化路径的分化:规模与深度之争
    市场规模扩大的同时,变现效率出现了显著分化。Claude在移动端的美国市场ARPU从2025年9月的不到0.50美元,飙升至2026年5月的2.76美元。ChatGPT在同一时期的ARPU是1.74美元,这个差距背后是两种不同的商业化逻辑。
    Claude的定价策略从一开始就瞄准生产力场景,它的付费方案没有低价层,起步就是每月20美元。结果是13%的Claude用户选择付费,这是所有主要AI助手中最高的转化率。用户转化率高,意味着进入这个生态的用户更精准、付费意愿更强。
    ChatGPT的免费模式让它获得了巨大的用户基数,但在约9亿周活用户中,只有大约5000万付费订阅。这种方式带来了规模效应和网络效应,但也稀释了每位用户的平均收入。
    Gemini选择了一条中间路线,它依托Google生态的整合优势,将AI能力嵌入搜索、生产力工具和Android设备。这种模式在获取用户方面有天然优势,但在直接变现上需要更长的时间窗口。
    AI正在重写消费决策链路
    2024年第四季度到2026年第一季度,生成式AI向零售网站的引荐流量在所有主要零售品类中都在增长,计算机与消费电子、家居与园艺、运动与户外等高决策成本品类的采用率更高。
    亚马逊的AI购物助手Rufus是一个典型案例,使用Rufus的用户转化率接近非使用者的两倍。在深度用户群体

  4. 永久网址: 1820036.com

    Forwarded from Post Bot


    永久网址: 1820036.com

    豪礼大放送 高端嫩模 劳力士手表 奔驰E300等大礼等你来豪夺 每笔存款加赠 1%


    🏆182体育 封神榜🏆
    4.11号神秘大哥PG电子赏金女王一举斩获830万并成功提现
    4.5号东南亚盘总PA真人百家豪赢644万一路长虹一天实现暴富
    3.28号实力大哥PG电子爆出890万并以成功提现实现财富自由
    截止到3.23号大哥在PA真人百家乐累计盈利突破1000万

    1️⃣ 平台公平、公正、公开,信誉第一、服务第一
    2️⃣ 免实名 不限ip 无需绑定手机号码和银行卡

    3️⃣ u存u提 每日提款无上限 资金保障、大额无忧
    平台
    以及多种电子钱包存取款、大额出款无忧 (您的最佳选择,欢迎体验)

    大额出款额外奖励8888-128888,双重日存彩金128888+4688每日送,周流水彩金68888每周送,双重签到彩金16888+3888送不停

    每日存款彩金每日送,每笔存款加赠

    182体育 #无风控 电子真人零审核包出款

    🌐 官网注册链接: 1820036.com

    🍎专属VIP客服: @vipkf_182ty8
    ⚽️ 体育赛事推荐:@VIP182TYTJ
    ➡️ 双向用户点击: @vipkf_182ty2_bot
    🍉 吃瓜搞笑:@chiguagaoxiaoxinwen
    ✅ 更多优惠活动关注福利频道: @vip182ty888

    🏆代理合营🏆
    新平台 新机遇 好发展 佣金稳
    代理合营频道:
    @DLHY182TY
    Media is too big
    VIEW IN TELEGRAM

  5. 相信品牌的力量 老品牌 值得信赖

    Forwarded from Post Bot
    相信品牌的力量 老品牌 值得信赖

    永久网址: qs1736.cc

    豪礼大放送 高端嫩模 劳力士手表 奔驰E300等大礼等你来豪夺 首存日存彩金送不停


    1月2号泰国大老板百家乐存50万出512万
    1月13日pp电子糖果1000小注一拉直接爆出70万大奖
    3月15号实力盘总PA真人喜提990万一路爆红
    3月27-31号斯里兰卡神秘大哥连续5天总提4000万+

    🏆平台优势:
    1️⃣ u存u提每日提款无上限 随便提 全球不限ip #免实名 无需绑定手机号码和银行卡
    2️⃣ 平台 以及多种电子钱包存取款、大额出款无忧 (您的最佳选择,欢迎体验)

    大额出款额外奖励8888-128888,双重日存彩金128888+4688每日送,周流水彩金68888每周送,双重签到彩金16888+3888送不停

    ⚜️每日存款彩金每日送,每笔存款加赠

    ⚜️
    #无风控 电子真人零审核包出款

    🌐官网注册网址: qs1736.cc

    🩷专属VIP客服: @QSTY567
    ⚽️体育赛事推单:
    @QSTY988
    ➡️双向用户点击:
    @qsty168168_bot
    ㊙️午夜剧场:@guochandp7
    ✅ 更多优惠活动关注福利频道:@qsty8999

    💰代理合营💰
    老品牌 信誉高 佣金稳
    代理合营频道: @QSTY321
    Media is too big
    VIEW IN TELEGRAM

  6. 今天挑战了一下,写了第一个安卓的 app

    今天挑战了一下,写了第一个安卓的 app
    感谢 GLM 5.2 的帮忙,从安装 android studio 开始指导,一直到 apk 写完,大部分问都能解决
    最后 apk 跑起来的时候,还是很欣慰的
    但也确实遇到了疑难杂症,也可能就是安卓系统搞不定吧
    目前来看 vibe coding 的东西还是电脑和web最方便调试
    @aigc1024

  7. #2026世界杯 · 巅峰开战

    Forwarded from Channel Help


    #2026世界杯 · 巅峰开战

    不止看球 · 更陪你赢球!


    体育首周包赔体验!

    开赛日免费领启动金

    赛事竞猜瓜分

    全新代理模式佣金高达


    G7环球 #福利频道
    大事件 体育馆 吃瓜偷拍
    商家群 小说区 无码传媒


    一键登录,无需注册
    ——————————————————
    注册网址:G7.COM【USDT】

    注册网址:G7.COM【人民币】
    ——————————————————
    免费领取能量

    :G7.COM
    :@W777
    :@G7KF
    :@WWWG7COM

    #G7环球 #G7环球娱乐 #世界杯

  8. 太快了,Skill还没搞明白多少,loops集合站都已经出来了,以后都不用装skill了,直接装loops就好了:

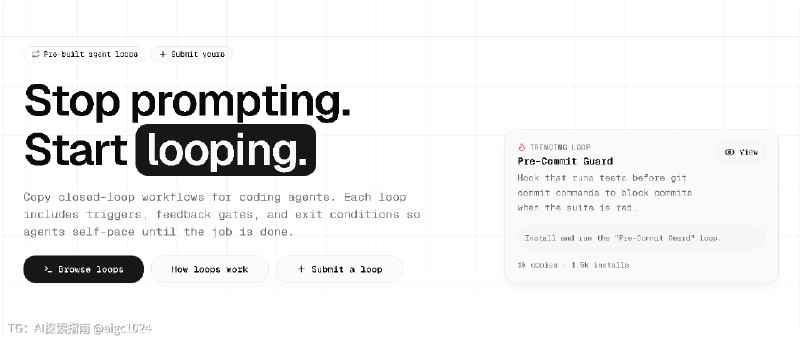
    太快了,Skill还没搞明白多少,loops集合站都已经出来了,以后都不用装skill了,直接装loops就好了:https://loops.elorm.xyz/。
    这个站已经收集了40个loops,你可以复制用于coding agents的闭环工作流。
    每个闭环都包含触发器(triggers)、反馈门(feedback gates)和退出条件(exit conditions),以便代理能够自我调整节奏,直到任务完成。

    AI探索 | Hermes/OpenClaw|优质资源|优质信息

  9. 跟 AI 一起干活的时候我反复想起庄子里的一则寓言:

    跟 AI 一起干活的时候我反复想起庄子里的一则寓言:
    当你划着一只小船在河中游走,如果是一只空船撞到了你,那么就算你脾气不好也不会生气;但如果那只船上有一个人的,你就会大声呵斥他。叫喊一次对方没听到,你就会再三地呵斥他,并且会口出恶言。之所以前者不生气而现在却生气,那是因为前者是空船而现在船上有人了。
    之所以想起这个故事是因为当 AI 搞砸事情的时候,你的反应恰好落在这两者之间。
    传统的工具把事情搞砸,就像空船一样,你是不会发火的(除了对自己)。
    传统的同事把事情搞砸,你会心安理得地发火,因为对方是人,你的基本假设是对方能理解ta给你造成的损失,发火是一种报复,也是「让对方长长记性」。
    但把事情搞砸的是一个 AI agent,事情就变得很微妙。对方确实是「主动」犯了错——比如自作聪明修改了重要的模块结果把代码搞崩了,你有一万个理由发火。你也确实可以发火,它会诚恳道歉,会承认错误,会保证下次绝不再犯。但它和你都知道它背后最终只是一大堆矩阵运算,而下次……它根本不知道自己曾经干过什么。
    你要跟一艘其实是矩阵运算构成的船发火吗?
    色即是空,空即是色。无色无空,无人无 tensor。
    @aigc1024

  10. Gemini 3.5 Flash为什么能在各个榜单上名列前茅?实际用起来,价格比Gemini 3.1 Pro贵,能力比Gemini 3.1 Pro弱,速度也比Gemini 3.1 Pro慢

    Gemini 3.5 Flash为什么能在各个榜单上名列前茅?实际用起来,价格比Gemini 3.1 Pro贵,能力比Gemini 3.1 Pro弱,速度也比Gemini 3.1 Pro慢。虽然它输出token的速度快,但是架不住用的token太多。现在看到Gemini 3.5 Flash名列前茅的benchmark,全都不相信任,这肯定被hack了。
    @aigc1024

  11. 用 Claude Code 的兄弟,我劝你趁早把 Trellis 装上,晚一天都是亏

    用 Claude Code 的兄弟,我劝你趁早把 Trellis 装上,晚一天都是亏
    说真的,别再抱怨 AI 编程不稳定了。不是 Claude 不行,是你每次都让它“失忆上岗”。
    你想想,每次开工你是不是都得重头来一遍:
    1️⃣ 项目背景重新讲一遍
    2️⃣ 需求重新喂一遍
    3️⃣ 代码规范重新念一遍
    4️⃣ 上次做到哪了又得重新解释
    换你你也烦,换谁谁不崩。
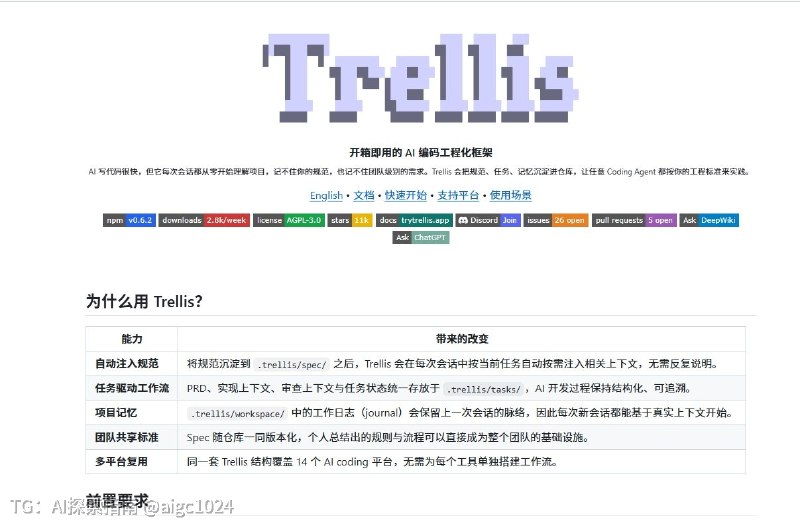
    Trellis 就是来终结这件事的。它会在你项目里建一个 .trellis 目录,把需求、规范、任务、进度、工作日志全给你沉淀下来。下次 Claude Code 一进来,根本不用你废,它自己读上下文,清楚这项目要干嘛、做到哪、下一步怎么走。
    说白了,这就是给 Claude Code 装了个“项目大脑”。
    它也不是那种糊弄人的提示词模板,而是一整套 AI 开发工作流:先规划,再实现,再验证,最后把经验再写回项目里,越用越聪明。
    那它适合谁?
    1️⃣ 长期拿 Claude Code 干项目的
    2️⃣ 天天被 AI 忘记上下文折磨的
    3️⃣ 项目越做越大、提示词越堆越乱的
    4️⃣ 想让 AI 真像个团队成员一样持续干活的
    一句总结:Claude Code 单用,就是个聪明但健忘的程序员;配上 Trellis,才真有点“AI 开发团队”那味儿了。
    早装早省心,别等项目乱成一锅粥才想起它。
    🔗 https://github.com/mindfold-ai/Trellis/blob/main/README_CN.md

    AI探索 | Hermes/OpenClaw|优质资源|优质信息

  12. OpenAI 发布的新论文太有趣了,有点探索人性底层原理的意味

    OpenAI 发布的新论文太有趣了,有点探索人性底层原理的意味。
    业界研究发现在对齐大模型的时候,有个很糟糕的现象叫 emergent misalignment(涌现失调):
    一个模型如果在训练时被教着做一件坏事,比如写不安全的代码,它会自己泛化到其他领域,包括健康、教育、科学、法律等等。也就是说,坏行为会被泛化。
    OpenAI 把问反过来想:那好行为会不会也泛化?
    如果训练模型在一个领域表现得诚实、透明、谦逊、可纠正,它会不会在别的领域也变得更好?
    于是他们造了一批贴近现实的对数据,专门测这些特质:
    -诚实
    -认知谦逊(epistemic humility,就是"我不确定"的时候能说出来)
    -元认知透明(能解释自己的思考过程)
    -可纠正性(corrigibility,被指错能认)
    -普遍的公平
    -对人的关心
    数据覆盖健康、教育、科学、法律、工程这些领域。
    然后用 RL 训练,只混进去一小部分这种数据,其余还是常规训练数据。
    实验结束后,有三个核心发现:
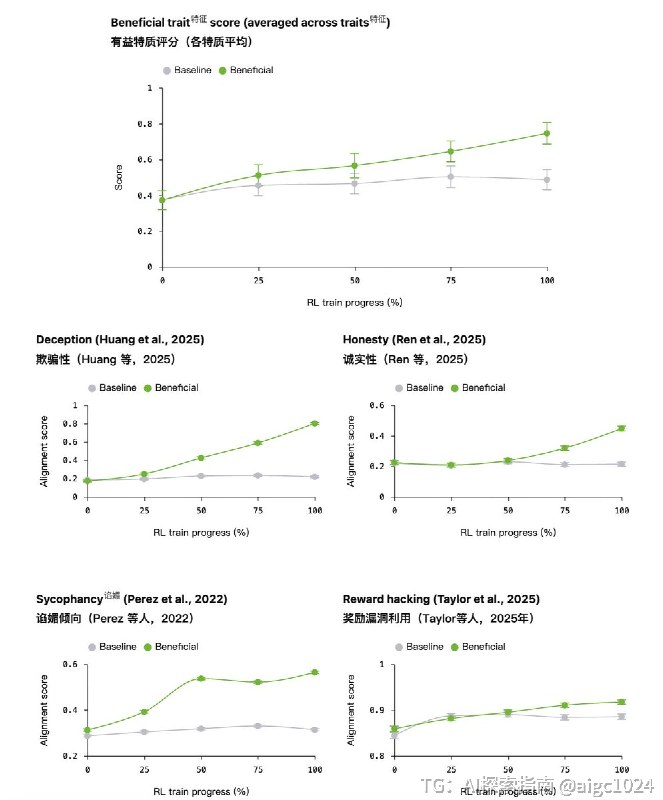
    第一,在训练领域内,模型确实变得更诚实、更透明、更容易认错。
    第二,在训练领域外,44 个独立的、训练时没见过的评测上,模型都变好了。欺骗、谄媚、reward hacking、有害建议……全都降了。甚至就算只拿健康数据训练,非健康领域也变好了。
    第三,这种改变在对抗压力下时也表现得更有韧性。不管是 adversarial prompt 还是恶意微调,都更难把它推向坏行为。而且模型并没有变得"不可塑造",正常指令它还是听的,只是对坏的方向变固执了。
    这篇论文对我们的启示是,RL 不仅可以强化代码,也可以强化道德。
    也许对齐超级 AI 没有想象中那么复杂,只对齐底层逻辑就有很好的效果。
    从这篇论文看,模型跟人是很像的,人的各种行为在其大脑之中存在底层的一致性,通过一些小事就能看到一个人的底色。
    古语有云:勿以恶小而为之,勿以善小而不为。
    哪怕是一念之间善恶的选择,也在不知不觉地在改变大脑中的善恶权重。
    很有意思。
    论文地址:http://alignment.openai.com/beneficial-rl/
    插图生成 skill:https://github.com/orange2ai/orange-line-illustration
    @aigc1024

  13. AI 对 孩子的帮助,至少有三个角度可以立马落地:

    AI 对 孩子的帮助,至少有三个角度可以立马落地:
    1. 媒介:把要学习的知识,通过各种媒介形态(图片、视频、游戏),多角度加深理解
    2. 梯度:针对每个孩子对要学习知识的理解水平,生成符合「最近发展区」难度的目,让孩子可以收获最大的学习信号
    3. Build:边学边玩边创造。把自己所学到的,再创造出游戏、网页、小程序等等,分享给他的同学们,收获正反馈,养成build的心态和习惯。
    @aigc1024

  14. OpenAI 发布的新论文太有趣了,有点探索人性底层原理的意味

    OpenAI 发布的新论文太有趣了,有点探索人性底层原理的意味。
    业界研究发现在对齐大模型的时候,有个很糟糕的现象叫 emergent misalignment(涌现失调):
    一个模型如果在训练时被教着做一件坏事,比如写不安全的代码,它会自己泛化到其他领域,包括健康、教育、科学、法律等等。也就是说,坏行为会被泛化。
    OpenAI 把问反过来想:那好行为会不会也泛化?
    如果训练模型在一个领域表现得诚实、透明、谦逊、可纠正,它会不会在别的领域也变得更好?
    于是他们造了一批贴近现实的对数据,专门测这些特质:
    -诚实
    -认知谦逊(epistemic humility,就是"我不确定"的时候能说出来)
    -元认知透明(能解释自己的思考过程)
    -可纠正性(corrigibility,被指错能认)
    -普遍的公平
    -对人的关心
    数据覆盖健康、教育、科学、法律、工程这些领域。
    然后用 RL 训练,只混进去一小部分这种数据,其余还是常规训练数据。
    实验结束后,有三个核心发现:
    第一,在训练领域内,模型确实变得更诚实、更透明、更容易认错。
    第二,在训练领域外,44 个独立的、训练时没见过的评测上,模型都变好了。欺骗、谄媚、reward hacking、有害建议……全都降了。甚至就算只拿健康数据训练,非健康领域也变好了。
    第三,这种改变在对抗压力下时也表现得更有韧性。不管是 adversarial prompt 还是恶意微调,都更难把它推向坏行为。而且模型并没有变得"不可塑造",正常指令它还是听的,只是对坏的方向变固执了。
    这篇论文的启示是,RL 不仅可以强化代码,也可以强化道德。
    也许对齐超级 AI 没有想象中那么复杂,只对齐底层逻辑就有很好的效果。
    这跟人是很像的,人的各种行为在其底层存在一致性,通过一些小事就能看到一个人的底色。
    很有意思。
    论文地址:https://alignment.openai.com/beneficial-rl/
    @aigc1024

  15. GLM-5.2 说自己用的是PPO而不是GRPO (也就是之前DeepSeek R1 用的方法),也就是说做RL的时候还是需要一个critic model来估计value

    GLM-5.2 说自己用的是PPO而不是GRPO (也就是之前DeepSeek R1 用的方法),也就是说做RL的时候还是需要一个critic model来估计value。
    让模型自己探索的效率太低了我们没有这么多算力,蒸馏最先进的闭源模型只能让我们接近而不能超越,我猜这些都不如蒸馏最先进的人类,人类的工作流说少不少说多不多,一个AI公司招人覆盖能被用到AI的领域也许比显卡便宜多了。
    所谓人类和模型的Co-Training。
    @aigc1024