AI探索指南

  1. 原来金融是这么玩的啊,真有你的 Open AI #ai创造营#

    原来金融是这么玩的啊,真有你的 Open AI #ai创造营#

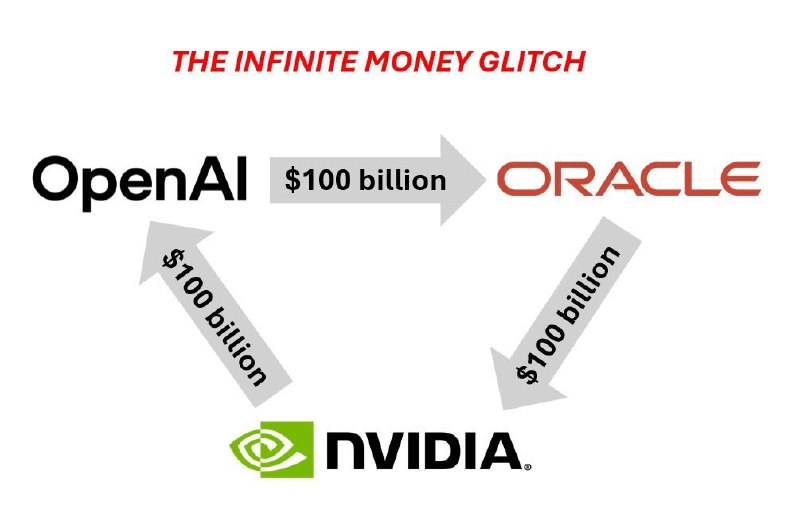
    Open AI 宣布获得了英伟达的 1000 亿美元投资用来构建超过 10GW 的算力中心。

    前几天 Oracle 表示 OpenAI 会购买他们 3000 亿美元云计算资源,然后股价暴涨,但是 Oracle 没有 GPU,所以需要去英伟达购买相当多的 GPU。

    Open AI 把英伟达的投资拿给 Oracle 买云服务 → Oracle 拿着 Open AI 买云服务的钱来买 GPU → 英伟达再把 Oracle 买 GPU 的钱投资给 Open AI

    详情:openai.com/index/openai-nvidia-systems-partnership/

  2. AI探索指南
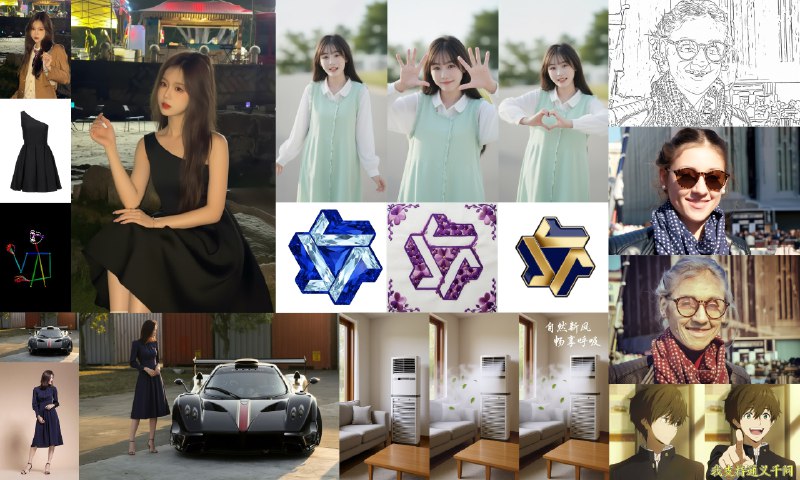
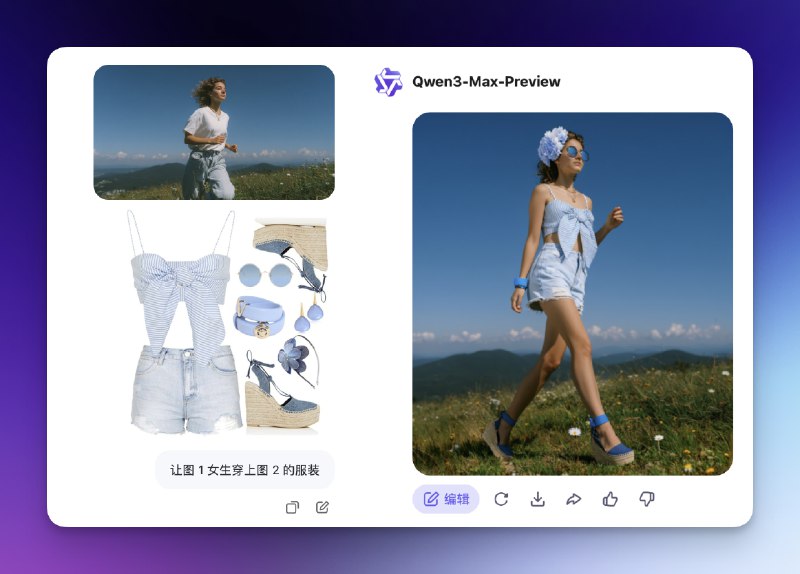
    通义的开源图像编辑模型 Qwen-Image-Edit 也获得了大幅更新 支持了多图编辑,可以进行多张图片的参考和融合了 单图支持保持人像和产品一致性 文字处理能力也获得了增强 这次更新还内置了 Depth. Edges. Keypoints 三个 ControlNet 模型 详情:qwen.ai/blog?id=7a90090115ee193ce6a7f619522771dd9696dd93&from=research.latest-advancements-list
    006KpAl0ly1i5ngb0ca7uj32km0rlqfp.jpg
    469.8 KB

  3. 通义的开源图像编辑模型 Qwen-Image-Edit 也获得了大幅更新

    通义的开源图像编辑模型 Qwen-Image-Edit 也获得了大幅更新

    支持了多图编辑,可以进行多张图片的参考和融合了
    单图支持保持人像和产品一致性
    文字处理能力也获得了增强
    这次更新还内置了 Depth. Edges. Keypoints 三个 ControlNet 模型

    详情:qwen.ai/blog?id=7a90090115ee193ce6a7f619522771dd9696dd93&from=research.latest-advancements-list

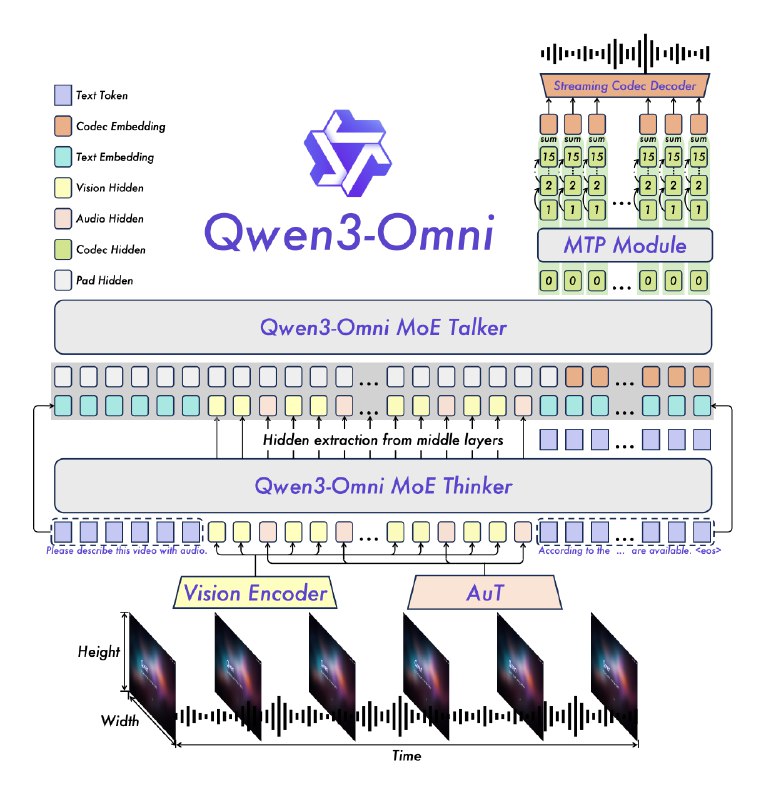
  4. 阿里昨晚又疯狂输出了,开源了首个可以本地运行的端到端的全模态理解 LLM Qwen3-Omni #ai创造营#

    阿里昨晚又疯狂输出了,开源了首个可以本地运行的端到端的全模态理解 LLM Qwen3-Omni #ai创造营#

    可以处理文本、图像、音频和视频输出,支持输出文本和音频的流式输出。

    提高音频和视频理解的同时,单模态的文本和图像没有退化。

    基于 MoE 的 Thinker–Talker 设计,采用 AuT 预训练以获得强泛化表示,外加多码本设计以降低延迟。

    还开源了一个对应的 Captioner 音频描述模型。

    低延迟流式传输,具备自然的轮流对话和即时的文本或语音响应。

    详情:github.com/QwenLM/Qwen3-Omni

  5. 但是对于开发者来说,原生化的AI云才是刚需,去买算力部署模型,门槛天然就高,比如我们都知道,DeepSeek已经是大模型里的价格屠夫了,但要训练一套完整的DeepSeek MoE模型,至少需要320张GPU,这就不是普通开发者能说上就上的

    AI探索指南
    IDC有个报告是我从去年就开始注意的:中国大模型公有云服务市场分析,这是对国内AI产业「商品化」最客观也是最真实的数据反馈。它直接反映了大模型的应用规模,而不是把IaaS、PaaS打包一起统计,可以说是Tokens经济最核心的指标。 比如去年中国整个公有云的Tokens调用量几乎是从无到有的飙升到了114.2万亿次,已经呈现出了爆发趋势,前天IDC又更新了今年上半年的报告,Tokens的调用总量达到536.7万亿次,半年的时间干了去年全年接近5倍的活儿。 这张环比数据表(图1)的信息量很大,可以看到2…
    但是对于开发者来说,原生化的AI云才是刚需,去买算力部署模型,门槛天然就高,比如我们都知道,DeepSeek已经是大模型里的价格屠夫了,但要训练一套完整的DeepSeek MoE模型,至少需要320张GPU,这就不是普通开发者能说上就上的。

    所以MaaS这种群众路线的服务才越来越受欢迎,它相当于一家模型商店,把市面上的模型都封装到了云上,开发者不必关心技术细节,只需按量付费,直接调用模型的核心能力——文本生成、图像识别、语音转换等——为己所用。

    有个对MaaS模式的体验形容特别恰当:拎包入住,丰俭由人。

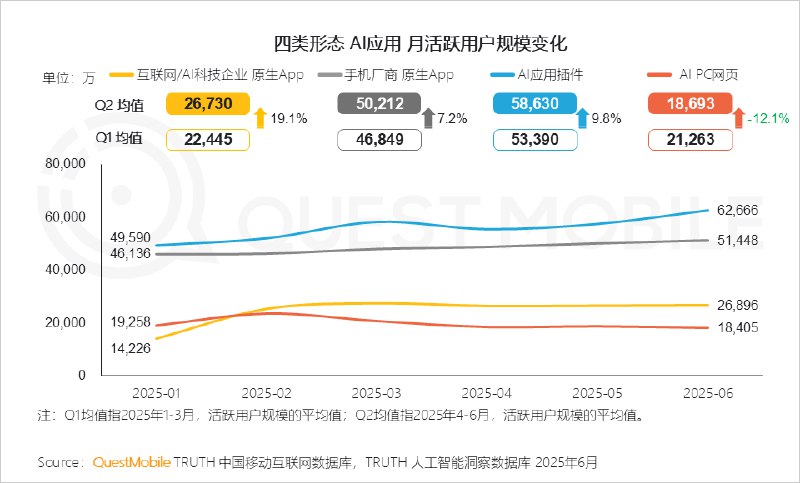
    Quest Mobile在2025中国移动互联网半年大报告里也提到过一个点,在国内的AI应用侧,插件产品的规模要明显高于原生产品(图2),什么意思呢,就是大家期待的杀手级App,可能并没有那么快出现,与此同时,AI又已经变得无处不在了,以新功能的形式。

    在这个渗透过程里,MaaS市场就是最大的幕后功臣,一个社交产品的开发者,如果想要新增一个AI头像的绘制功能,完全可以不用重复造轮子,专门训练一个图片模型出来,而是可以像去超市购物那样,在MaaS市场里挑一个价格和性能最适合的,然后用接口的方式加到自己的产品里,即开即用。

    美国BI平台Databricks的负责人今年也说过来自业务侧的反馈:「大多数企业并不想成为AI专家,他们只是需要开箱化的AI解决方案,而且微调和管理开源模型的复杂性对他们而言依然是一个难以跨越的门槛。」

    所以像是OpenAI和Anthropic在面对免费平替的开源模型时还是非常能打,而拥有企业级服务经验的Salesforce和Oracle也在老树新芽般的高速增长,模型的原始智能水平固然重要,但更值钱的地方在于它驱动产品的质量和可用性。

    某种意义上,MaaS才是真正的大模型竞技场,像是火山引擎之所以占有率独一档,就是因为它能汇聚市面上最新、最领先的模型,还是用超市的比喻来理解,就是供应链的竞争力制胜,比如Google的新图片模型nano-banana刷屏之后,唯一能跟上硬刚的,就是字节的Seedream 4.0,刚刚登顶LMArena,而在火山引擎,这些顶级模型都在摆货架上「予取予求」。

    而且即便有微调和训推需求,火山引擎的Infra效率也是行业领先的,像是DeepSeek-V3.1这种开源模型在火山引擎上的表现指标也非常漂亮,这些都会最终体现到开发者的体验端,形成用量越多、进步越快的正循环。

    前几天看到有条推文,说OpenAI曾经明确表示GPT-4o、o1、o3、o3-mini这样说命名对用户来说太不友好了,要用GPT-5来做统一和简化,现在来看,这话OpenAI只做到了一半,确实只有GPT-5一个模型了,然而我们看到迎面走来的方阵分别是:GPT-5、GPT-5 auto、GPT-5 thinking、GPT-5 pro、GPT-5-mini、GPT-5-nano⋯⋯

    滑稽.jpg

    本质上,模型商品化的主要瓶颈,还是Tokens不够用,于是不得不人为设置各种档位,在让大模型变成自来水那样按需取用的生活资源这件事情上,MaaS平台的用武之地和长期价值,一定会与日俱增。

    你们也可以参与预测一下,半年后IDC公布2025年全年中国大模型公有云的Tokens调用量时,会出现一个什么量级的数字?

  6. IDC有个报告是我从去年就开始注意的:中国大模型公有云服务市场分析,这是对国内AI产业「商品化」最客观也是最真实的数据反馈

    IDC有个报告是我从去年就开始注意的:中国大模型公有云服务市场分析,这是对国内AI产业「商品化」最客观也是最真实的数据反馈。它直接反映了大模型的应用规模,而不是把IaaS、PaaS打包一起统计,可以说是Tokens经济最核心的指标。

    比如去年中国整个公有云的Tokens调用量几乎是从无到有的飙升到了114.2万亿次,已经呈现出了爆发趋势,前天IDC又更新了今年上半年的报告,Tokens的调用总量达到536.7万亿次,半年的时间干了去年全年接近5倍的活儿。

    这张环比数据表(图1)的信息量很大,可以看到2个异军突起的增长拐点,分别在2024年7月和2025年2月,这两个时间发生了什么事?

    2024年7月,豆包掀起大模型降价风潮的影响出现,因为把旗舰模型的计费标准从「几分钱」降低到「几厘钱」,几乎是以一己之力凭空创造出了大模型公有云这个市场;

    2025年2月,DeepSeek-R1全球爆火,不但打响了大模型领域的成本革命,也把AI云的负载压力从预训练切换到了推理,从此开源模型百花齐放,进一步促进了模型商品化的渗透率。

    整个连锁反应的结果,就是MaaS(模型即服务)这种商业模式的拔地而起,以及最早布局MaaS的火山引擎,现在拿到了49.2%的市场份额,相当于全行业的半壁江山。注意,这个统计并不包括豆包、抖音等字节内部产品,完全是外部企业客户的调用量。

    当然,MaaS只是AI云的赛道之一,基于统计口径的不同,阿里云、百度云也都能在IaaS、PaaS等赛道拿到另外的第一名,但就含金量而言,MaaS是最能证明大模型行业发展情况的晴雨表。

    因为MaaS的调用量大,也够直接,模型好不好用、该怎么改的评测集,都是只有通过调用才能得到的信息,卖GPU是拿不到这类数据的,所以火山引擎从一开始就是把MaaS作为AI云的核心目标,这对兄弟部门的豆包也有帮助:

    「大的使用量,才能打磨出好模型,并且大幅降低模型推理的单位成本。」

    MaaS是一个边缘创新的典型产物,因为营收和利润的起点都很低,传统云厂商都不太看得上,还是卖算力最赚钱,像是甲骨文这种千亿美金级别的锁单带动股价飙涨,才是聚光灯下的主流叙事。

  7. #PG电子 #真人百家乐 东南亚最大线上博彩平台

    Forwarded from 球速体育----琳琳💖
    #PG电子 #真人百家乐 东南亚最大线上博彩平台


    ✅豪礼大放送
    、高端嫩模、劳力士手表、奔驰E300等大礼等你来豪夺、首存日存彩金送不停

    点击:泰国大老板百家乐存50万出512万 查看记录
    点击:反水11000出款74万史无前例查看记录
    点击:柬埔寨大盘总喜提42万u查看记录
    点击:充值30万总提款164万轻轻松松实现财富自由
    点击:单笔提款530万全网独一档查看记录
    点击:千万备用金、大额出款无忧查看记录

    ✅u存u提每日提款无上限,随便提、全球不限ip、免实名绑定手机号码、银行,大额出款无忧 (您的最佳选择,欢迎体验)

    #亚洲顶级真人视讯博彩盘口!

    🔥平台 以及多种电子钱包存取款。东南亚国家地区 不限ip  U存U取(无须实名)

    📢重磅消息首存彩金一倍流水
    首存1000送108+100
    首存3000送238+188
    首存5000送358+188
    首存10000送528+188
    首存30000送788+188
    首存50000送1088+188
    首存80000送1488+188


    👑福利频道:@qsty8999
    ⚽️体育赛事推单:
    @QSTY988
    💖午夜剧场:
    @madoudp9

    💖vip客服专属热线,添加客服领取活动福利
    🌐官网客服: @QSTY567
    双向用户点击:@qsty168168_bot

    🌐注册网址: qs1736.cc

    Media is too big
    VIEW IN TELEGRAM

  8. 更妙的是,这个系统会根据草稿的内容动态调整搜索策略

    AI探索指南
    最近,谷歌研究团队新发了一篇很牛的论文。 他们推出了他们的深度研究型智能体——TTD-DR(Test-Time Diffusion Deep Researcher),翻译过来就是测试时扩散深度研究员。 说白了,就是让AI学会像人一样打草稿。 如果让你写一篇深度研究报告,你会怎么做? 一般都是先列个提纲,然后写个初稿,接着查资料、改来改去,最后才能交出一份像样的成果。 这个看似平常的过程,却难倒了一众AI。 比如今年2月,OpenAI推出了Deep Research功能,号称能帮你写出专业级的研…
    更妙的是,这个系统会根据草稿的内容动态调整搜索策略。比如写到一半发现某个观点站不住脚,它会立即去搜索相关反驳材料。

    这种灵活性是传统线性方法望尘莫及的。

    研究团队还做了个有趣的对比实验,他们让系统分别用传统方法和新方法处理同样的问题,然后记录每一步的信息增量。

    结果发现,传统方法的信息积累是线性的,而新方法呈现出一条优美的凸曲线——前期快速积累核心信息,后期精雕细琢。

    这项技术的商业价值不言而喻。
    首先是效率得到了很大提升,同样质量的报告,新方法能节省近一半的计算资源。
    对于动辄烧钱几百万美元训练模型的AI公司来说,这是实打实的成本节约。

    其次是用户体验,传统AI助手生成报告要等很久,因为它得把所有搜索做完才能开始写。
    新方法边搜边写,用户能更早看到初步结果,体验自然更好。

    最关键的是技术护城河。
    这套方法不需要重新训练模型,只要在推理阶段应用就行。这意味着任何公司都能快速部署,但真正做好需要大量工程优化。
    谷歌凭借在扩散模型上的深厚积累,暂时领先一个身位。

    当然,TTD-DR也不是完美的。
    论文坦承,系统目前只支持文本搜索,不支持浏览网页或执行代码。

    这在某些场景下是硬伤,比如分析最新的财报数据,如果不能直接访问公司官网,就只能依赖可能过时的二手信息。

    另一个问题是可解释性。
    系统内部的多次迭代和自我进化过程就像个黑箱,很难说清楚某个结论是怎么得出的。
    对于需要严格溯源的学术研究或法律文书,这可能是个大问题。

    成本也是个考量因素,虽然相对效率提升了,但绝对成本仍然不低。
    每生成一份深度报告,背后是几十次的模型调用。
    对于个人用户可能还好,企业级应用的成本压力不小。

    认知科学家早就发现,人类思维的精妙之处不在于一次就想对,而在于不断修正的能力。
    从这个角度看,TTD-DR让AI向真正的智能又迈进了一步。

    谷歌这次的创新,本质上也是一次向人类学习的回归。

  9. 最近,谷歌研究团队新发了一篇很牛的论文

    最近,谷歌研究团队新发了一篇很牛的论文。

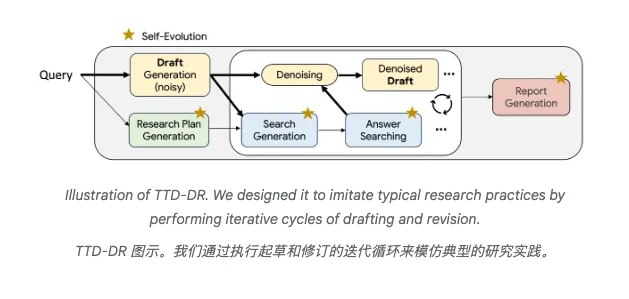
    他们推出了他们的深度研究型智能体——TTD-DR(Test-Time Diffusion Deep Researcher),翻译过来就是测试时扩散深度研究员。

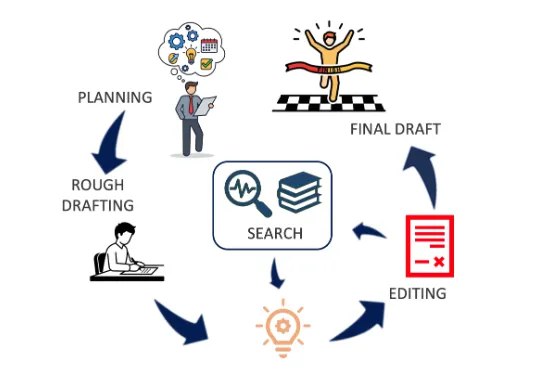
    说白了,就是让AI学会像人一样打草稿。

    如果让你写一篇深度研究报告,你会怎么做?

    一般都是先列个提纲,然后写个初稿,接着查资料、改来改去,最后才能交出一份像样的成果。

    这个看似平常的过程,却难倒了一众AI。

    比如今年2月,OpenAI推出了Deep Research功能,号称能帮你写出专业级的研究报告。Perplexity紧随其后,Grok也不甘示弱。

    一时间,AI研究助手赛道热闹非凡。

    但问题来了,现有的AI研究助手基本都是一条道走到黑:接到任务,搜索资料,生成报告,完事儿。

    这就像考试时不打草稿直接往答题卡上写,一旦跑偏了就很难纠正。

    谷歌团队仔细研究了人类的写作习惯后发现,没有人是从第一个字写到最后一个字的。

    1981年的一项认知研究就指出,人类写作是个反复迭代的过程:先有个大概框架,然后不断修改完善。
    这个过程中,我们会不停地查资料、调整思路、推倒重来。

    有意思的是,这个过程跟物理学里的扩散模型惊人地相似。
    扩散模型简单说,就是从一团噪声开始,逐步去噪,最终生成清晰的图像。

    谷歌团队灵机一动:既然能用这个方法生成图像,为啥不能用来生成研究报告呢?

    TTD-DR的核心创新在于两个机制同时发力。

    第一条腿是去噪优化。
    系统先根据用户需求生成一个粗糙的初稿,就像画画时的草图。
    然后,每次搜索到新信息,就对这个草稿进行一次修订。

    这个过程就像雕刻家一点点雕琢大理石,每一刀都让作品更接近理想状态。

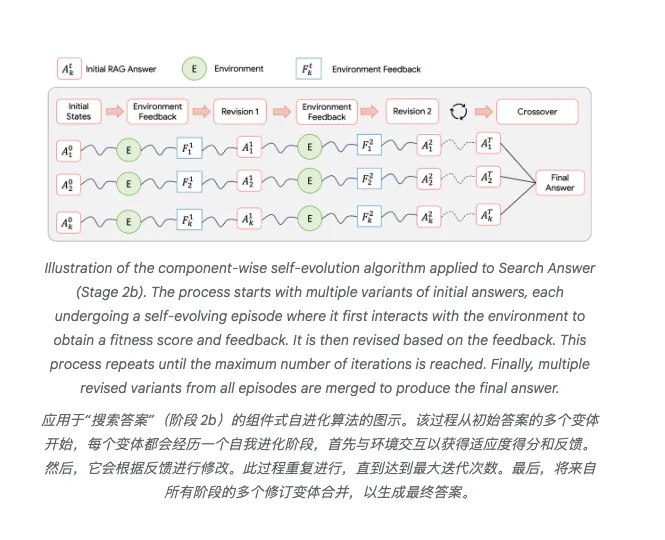
    第二条腿是自我进化。
    系统的每个组件(制定计划的、生成问题的、搜索答案的、写报告的)都会产生多个版本,然后通过内部评分机制选出最优解。
    这就像让五个人同时写同一份报告,然后取各家之长,合成最终版本。

    这两条腿配合起来威力惊人。
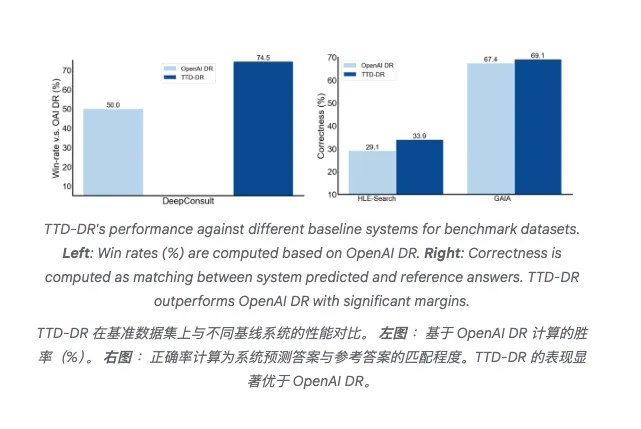
    在测试中,TTD-DR在长篇研究报告生成任务上的胜率达到69.1%和74.5%,碾压OpenAI Deep Research。

    在需要多跳推理的复杂问题上,准确率也提升了4.8%到7.7%不等。

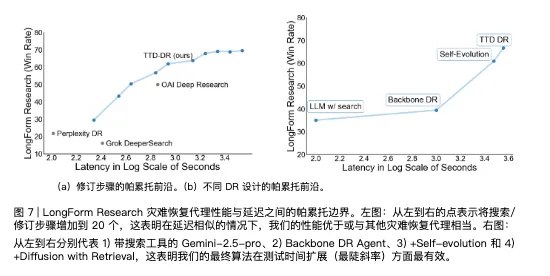
    论文里有个特别有意思的发现:系统在第9步修改时,就已经包含了最终报告51.2%的信息。

    这意味着传统方法要搜索20次才能达到的效果,新方法不到一半的步骤就能实现。