AI探索指南

  1. 北京、深圳、武汉这些地方都有在建人形的数采中心和训练中心,目前主流基本三种模式:

    北京、深圳、武汉这些地方都有在建人形的数采中心和训练中心,目前主流基本三种模式:
    1、企业自建数采中心,头部企业自建高规格数采中心,快速积累稀缺的真实场景数据,强化算法迭代能力,形成技术护城河。同时,采集的数据直接服务于自身产品研发与客户交付需求,缩短从实验室到落地的周期,同时可以通过数据服务创造新的盈利点。
    2、政企联合共建数采中心,联合制定数据采集规范,推动行业数据互通,缓解数据孤岛问题。
    3、地方政府主导建设数采中心,比如合肥市具身智能机器人数据采集预训练场。

  2. 卧槽,今天就一顿捣鼓解决了 Nano Banana 最恶心的一个问题

    卧槽,今天就一顿捣鼓解决了 Nano Banana 最恶心的一个问题。

    你现在可以自定义他生成和修改后的图片比例了。

    我们需要两张图片来完成这个任务:

    首先肯定是你之前生成的结果图,或者是你从其他地方获取的图片只是想更改比例也可以的。

    比如我前几天做的这个 AI 书法舞女,由于书法字体每张截图都不一样大,导致生成的图片大小也不一样,很烦,为了生成视频我还得自己裁切,这样就容易丢失信息。

    然后我们需要一张比例参考图,让 Nano Banana 将我们原来的内容替换到这张参考图上。

    他们长这样,这个图像内容我参考了 glif 的。

    但是他们的比例不全,我索性全部重做一遍,基本覆盖了所有常见比例,你也可以按这个样子自定义自己的比例,用Figma 就可以很简单。

    你要懒得做的话,文章最后有成品下载:https://mp.weixin.qq.com/s/RmM2sfcGlfMdmgH2DFqRug

    两张图片素材都有了以后,就可以探索提示词该怎么写了,我先是让 Nano Banana 将图片替换到比例模版图上,结果发现,会有类似的蓝色边,他没有帮我们扩图,只是简单的拼贴。

    于是在藏师傅疯狂迭代和尝试下,新生成的图片会基于原有图片的内容填充新的内容适应更改后的比例。

    提示词为:Redraw the content of Figure 1 onto Figure 2, add content to Figure 1 to fit the aspect ratio of Figure 2, completely clear the content of Figure 2, and only retain the aspect ratio of Figure 2.

    这里需要注意图片的顺序,想要修改的图放第一张,比例图放第二张。

    这就是教程的全部内容了,我们再来复习一下过程:

    1. 准备好你想要更改比例的图片以及对应的比例模版图

    2. 将想要更改比例的图片放第一张,将比例模版图放第二张,不建议更改顺序

    3. 输入提示词:“Redraw the content of Figure 1 onto Figure 2, add content to Figure 1 to fit the aspect ratio of Figure 2, completely clear the content of Figure 2, and only retain the aspect ratio of Figure 2. ”

    Invalid media: video

  3. 最强 ai 大模型谷歌 Gemini 如何白嫖1年会员

    最强 ai 大模型谷歌 Gemini 如何白嫖1年会员
    步骤:
    1️⃣ 科学上网选美区ip(好像一共6个国家都支持白嫖会员);
    2️⃣ 申请学生资格,网址:https://one.google.com/ai-student?g1_landing_page=75;
    3️⃣ 填写资料(记得保存),学校、名字要一样,邮箱无所谓。
    4️⃣ 用学生证生成器生成提交(最好带有学校logo,另外学校地址要正确,网上搜得到); https://student.frp.gs/
    5️⃣ 在续订(如果界面付款不支持)换个思路 去谷歌账号添加付款方式,在去支付就成功了;
    6️⃣ 续订成功后记得退订,免得忘记取消扣费。

  4. 刚写周刊的时候发现阶跃开源的这个 Step Audio 2-7B 端到端语音模型有点意思

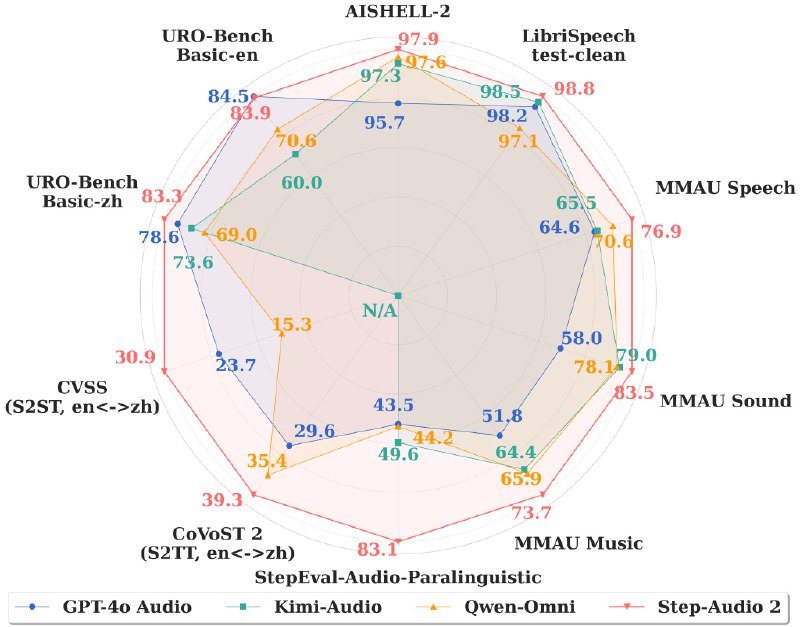
    刚写周刊的时候发现阶跃开源的这个 Step Audio 2-7B 端到端语音模型有点意思。

    应该是第一个支持推理的端到端语音模型,支持本地部署应该比 Open AI 的 GPT-realtime 便宜很多,发布这几天已经在 huggingface trending 榜上了。#ai创造营#

    实时语音对话这点,阶跃的模型一贯做的非常好,而且能够根据不同对话场景和对话信息做出语境适配的回应。

    这里比较强的是理解能力,支持通过推理理解语义信息、非语言信息以及非声带信息,让模型可以更好的感知说话人的年龄、性别甚至是情绪。

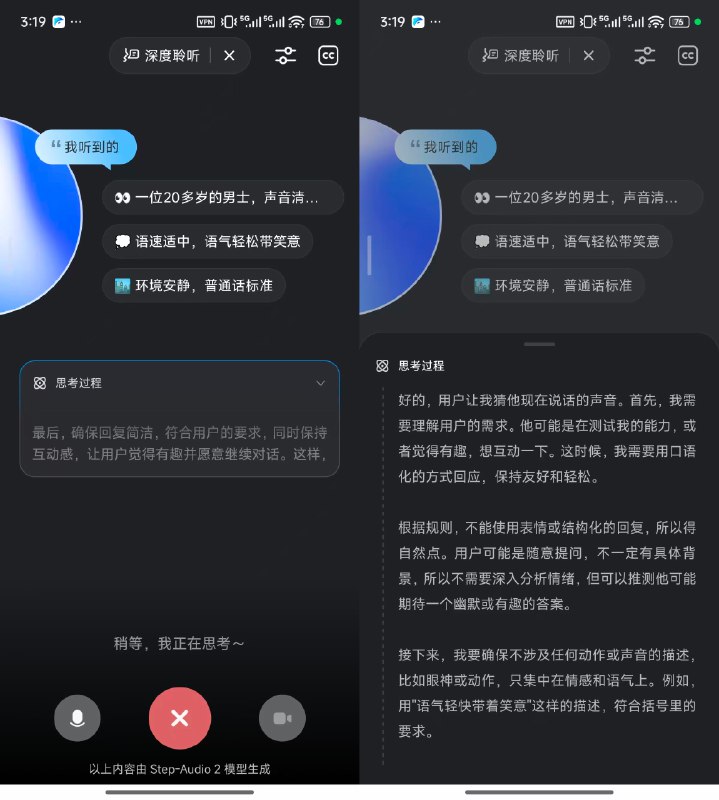
    前几天橘子分享的时候说我们现有的语音转文字去理解语音这种方式可能会丢失 90% 的信息,因为说话人的音调、语气、情绪都没有被传达出来,比如图片里面他就判断了我的年龄以及情绪,还有环境音可以判断所在场景。

    感觉 Step Audio 2-7B 这次走在了正确的路上,如果加上更加细致和原生的音频理解的话,语音对话模型的上限和应用场景会变得非常多。

    另外 Step Audio 2-7B 还支持工具调用与多模态 RAG,方便开发者去加上适合自己应用场景的知识,实时语音对话的时候可以执行搜索。比如各种垂类行业的语音客服就适合这样,而且还能检索到语音后切换音色。

    这次开源了两个模型 Step-Audio 2 mini 和 Step-Audio 2 mini base,7B 的大小让本地部署成为可能,只需要 24G 显存就行,对需要端到端语音模型的开发者来说很实用

    可以在阶跃 AI APP里面体验这次的新模型,开启语音通话后可以在小跃新功能里面选择,深度聆听就可以体验音频推理。

    模型下载:github.com/stepfun-ai/Step-Audio2