AI探索指南

  1. 今天来分享一个利用Claude Code快速建站并在谷歌上排名第一的商业化案例,非常有价值

    今天来分享一个利用Claude Code快速建站并在谷歌上排名第一的商业化案例,非常有价值。

    有个叫James的营销专家用Claude Code帮朋友的柴油卡车维修公司做了个网站,结果24小时内就在Google上排到了前三名,电话被打爆,赚了几千美元。

    不同于其他人的点在于,他选择了一个看起来非常无聊的生意。

    首先,什么叫无聊生意?
    如果你现在去参加任何一个科技创业活动,大概率会听到这些词:AI Agent、大模型应用、自动化工作流、SaaS工具,这些都是听起来高大上,充满想象空间。

    而无聊生意呢?
    修空调、通下水道、换轮胎、修卡车,这些生意存在了几十年,技术含量看似不高,也不会有风投来追捧。

    但James发现了一个有趣的现象:当一个卡车司机的车在高速公路上抛锚时,他不会打开ChatGPT询问"请推荐附近最优的维修方案",更不会在Cursor里调用Perplexity MCP来做决策分析。

    他会做什么?
    掏出手机,打开Google,搜索"附近柴油车维修",找个评价不错的,直接打电话。

    让我们再回到James的具体操作上。

    第一步:选择一个真正有需求的生意
    James的朋友经营着一家小型货运公司,专门在查尔斯顿和夏洛特之间运货。因为用的是二手卡车,经常出故障,他就和一个当地的机械师建立了合作关系。

    注意这个细节:这不是凭空想出来的需求,而是从实际痛点中发现的机会。

    《精益创业》里有个概念叫"Customer Development",意思是创业想法应该来自于和客户的深度接触,而不是闭门造车。
    James的朋友找到他说:"我懂运营,也有机械师资源,就是不会做网站和营销,要不要一起搞?"

    James还提到了一个有趣的思维模型,叫"杠铃策略"(Barbell Strategy),这个概念来自纳西姆·塔勒布的《反脆弱》。
    简单来说,就是把资源分配到两个极端:一端是高风险高回报的创新业务,另一端是稳定但无聊的传统业务。

    James的逻辑也很有意思:如果2030年真的出现AGI,数字服务和SaaS可能会被彻底颠覆,但机器人上高速公路修卡车?至少5年内不太可能。

    第二步:用AI重新定义传统营销

    接下来的操作就精彩了。
    传统上,如果你要给一个本地服务业做网站和SEO,流程是这样的:找设计公司做网站设计,找开发公司写代码,找SEO公司做优化。整个过程少则几个月,多则半年,花费几万到十几万不等。
    James用Claude Code把这个过程压缩到了4个小时。

    具体来说,他做了这么几件事:
    1. 关键词研究
    他直接问ChatGPT:"这是我的网站,帮我找25-50个关键词。"就这么简单。

    很多人在这一步就想多了,什么搜索量、竞争度、KEI指数...这些在本地市场其实没那么重要。

    为什么?因为本地市场的竞争对手可能连网站都10年没更新过。

    《蓝海战略》里有一个观点:与其在红海里和巨头拼刺刀,不如找一个竞争不充分的蓝海。
    而本地服务业就是典型的蓝海。

    2. 技术优化
    James让Claude Code做了一次"ultra think"(深度思考)级别的SEO审计。这个功能很有意思,相当于让AI花更多计算资源去分析问题。

    Claude发现了一堆技术问题:没有robots.txt文件、加载速度慢、缺少schema标记等等。
    然后呢?James就说了一个词:"Fix them"(修复它们)。
    Claude就真的去修了。

    3. 内容深度
    这是最让我惊讶的部分,James没有做那种千篇一律的"我们提供XX服务"的页面,而是让Claude为每个地区都做了深度内容。

    比如夏洛特的页面,不仅介绍服务,还会提到当地地标、NASCAR赛车文化对货运的影响、该地区卡车常见问题等等。
    当你的竞争对手只有100字的服务介绍时,你提供2000字的深度内容,Google自然会认为你的页面更有价值。

    第三步:多智能体协作
    James还展示了一个高级技巧:让Claude Code同时运行多个子代理(sub-agents)。
    比如,当他在主窗口继续优化网站时,他让三个子代理分别去:
    ● 寻找缺失的alt文本
    ● 分析竞争对手
    ● 识别其他SEO机会

    结果是惊人的。
    第二天,James的朋友电话就被打爆了,并且接下来几天的维修预约全部排满。
    在Google搜索"mobile diesel mechanic Charlotte"(夏洛特移动柴油机械师),他们的网站排在前三。

    要知道,有些竞争对手已经经营了20年。

    这背后的原理是什么?
    首先,大多数本地服务业的网站都是多年前做的,技术栈老旧,加载速度慢,移动端体验差。
    James用最新的技术标准重做,立刻就有了优势。

    其次,传统服务业网站的内容密度极低,James通过AI生成的深度内容,在信息量上形成了压倒性优势。

    最后一点,就是本地搜索的特殊性。
    Google的本地搜索算法和普通搜索不同,它更看重地理相关性、业务信息的完整性、用户体验(特别是移动端)以及页面加载速度。
    James恰好把这些都做对了。

    看到这里,你可能会想:这和我有什么关系?我既不懂SEO,也没有卡车维修的朋友。

    让我们把这个案例抽象一下,James真正做的是什么?
    第一点,发现技术洼地。
    找到那些还没有被技术充分改造的领域,可能是你们公司某个还在用Excel管理的流程,可能是你们行业某个大家都觉得"就是这样"的痛点。

    第二点,实现降维打击。
    用高维度的工具去解决低维度的问题,就像用Claude Code去做传统的网站开发,效率差了不止一个数量级。

    第三点,深度大于广度。
    与其做一个覆盖全国的平台,不如深耕一个城市的一个细分市场。深度创造价值,不是广度。

    换句话说,真正的机会不在于追逐最新最热的概念,而在于用最新的工具去解决最古老的问题。
    无聊生意之所以无聊,恰恰是因为大多数聪明人看不上,但技术本身不是目的,解决问题才是。

    正如James说的:"最大的鸿沟不是技术,而是不知道该问什么问题。"

  2. 现在 AI 的发展已经到达了一个非常尴尬的时刻

    现在 AI 的发展已经到达了一个非常尴尬的时刻。
    各种模型发布,提升微小,官方运营、kol、用户都快测不出区别了
    各种创始人访谈,访谈都吹的天花乱坠,产品一发布完全不是一回事
    各种教程,可能是最有用的内容了,但是太多了,根本学不过来。
    圈内人,已经快跟不上了。
    圈外人,就直接跳过了。
    信息爆炸的结果,又回到了用户自己。
    每个人只应该关注与自己相关的事情。
    不要试图关注一切,也没有可能关注一切。

  3. 昨晚 Open AI 居然发布的是开源模型就是前几天泄露的 gpt-oss-120b 和 gpt-oss-20b

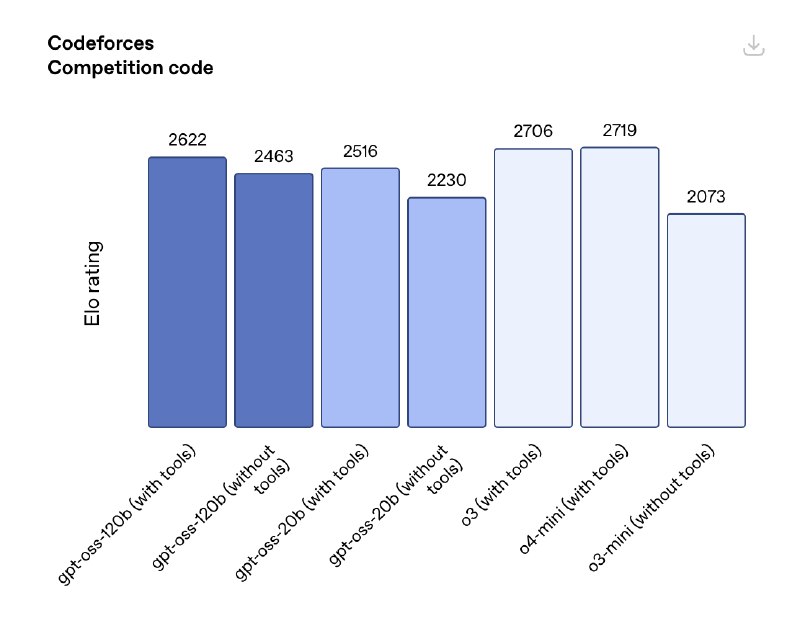
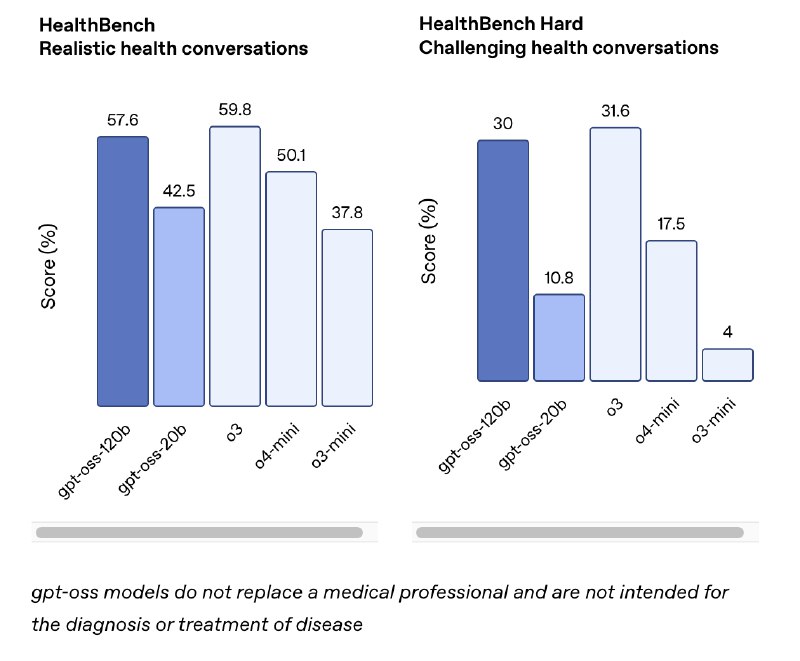
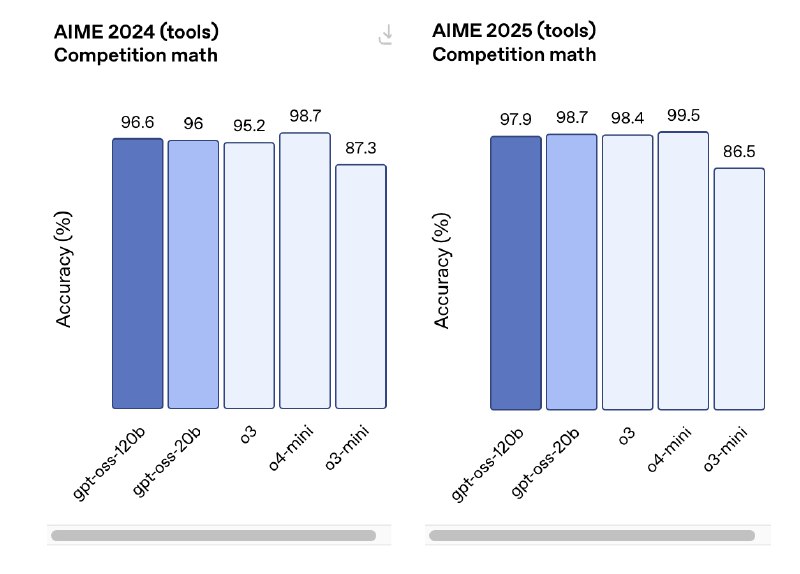
    昨晚 Open AI 居然发布的是开源模型就是前几天泄露的 gpt-oss-120b 和 gpt-oss-20b

    Gpt-oss-120b 大致相当于 OpenAI o4-mini,20B 的相当于 o3-mini

    120B 需要 80G 显存推理,20B 只需要 16G 显存设备。

    目前你知道的所有 LLM 周边生态都已经支持这两个模型,比如 ollama 这种

    架构与技术细节:

    均为 Transformer 架构,采用专家混合(MoE)技术,提升推理效率。
    gpt-oss-120b:36 层,1170 亿参数,每个 token 激活 51 亿参数,128 个专家,每 token 激活 4 个专家。
    gpt-oss-20b:24 层,210 亿参数,每个 token 激活 36 亿参数,32 个专家,每 token 激活 4 个专家。
    支持分组多查询注意力(grouped multi-query attention)、RoPE 位置编码,原生支持超长上下文。
    训练数据以高质量英文纯文本为主,重点覆盖 STEM、编程和通用知识。

    训练与后训练:

    采用与 o4-mini 类似的后训练流程,包括监督微调和强化学习阶段。
    支持三档推理强度(低、中、高),可通过系统消息灵活设置,兼顾延迟和性能。
    具备强大的指令执行、工具调用(如网页搜索、Python 代码执行)和推理能力。

    开源与生态:

    权重已在 Hugging Face 免费开放下载,支持 MXFP4 量化格式,便于本地和多平台部署。
    提供 Harmony 提示格式、Python/Rust 渲染器、PyTorch/Metal 参考实现和示例工具。
    与 Hugging Face、Azure、Ollama、AWS、Cloudflare 等主流平台合作,优化多硬件支持。
    Windows 设备有专门的 GPU 优化版本,支持本地推理和开发。

  4. Google DeepMind 刚刚发布了 Genie3 这款“世界模型”

    Google DeepMind 刚刚发布了 Genie3 这款“世界模型”。一句话概括:它能瞬间把文字变成七百二十 P、二十四帧每秒的 3D 互动世界,而且你还能实时在里面溜达几分钟,画面不会崩。

    想体验火山越野、飓风夜行、深海追水母?直接打字就行。更酷的是,它还能“记住”你一分钟后回头看到的同一棵树,环境一致性拉满。

    它背后的黑科技是:模型每秒要多次回看之前生成的画面,边想边画,既保证了实时性,又保证了不“穿帮”。这可比纯粹生成一整段视频难多了。

    除了当“元宇宙生成器”,Genie 3 还是训练 AI 代理的新操场。把 SIMA 机器人扔进去做任务,走迷宫、拿钥匙、躲障碍,一串长动作毫无违和感。未来机器人、自动驾驶都能用它来练级。

    当然,它还在“研究预览”阶段:只能玩几分钟、动作空间有限、多人互动和世界地图精度都在打磨。DeepMind 已经拉上了安全团队,先让少量学者和创作者试玩,收集反馈后再放大招。

    一句话总结:Genie 3 把“想象的下一秒”实时变成了“可玩的下一帧”

  5. 现在 AI 的发展已经到达了一个非常尴尬的时刻

    现在 AI 的发展已经到达了一个非常尴尬的时刻。
    各种模型发布,提升微小,官方运营、kol、用户都快测不出区别了
    各种创始人访谈,访谈都吹的天花乱坠,产品一发布完全不是一回事
    各种教程,可能是最有用的内容了,但是太多了,根本学不过来。
    圈内人,已经快跟不上了。
    圈外人,就直接跳过了。
    信息爆炸的结果,又回到了用户自己。
    每个人只应该关注与自己相关的事情。
    不要试图关注一切,也没有可能关注一切。

  6. 谷歌发布了一个非常牛皮的世界模型 Genie 3!

    谷歌发布了一个非常牛皮的世界模型 Genie 3!

    这次生成时长和分辨率都很给力,而且还支持通过文本动态改变世界事件,这搭配一个 LLM 不就妥妥的 AI 游戏吗

    能以 24 帧每秒的速度生成,分辨率高达 720P,支持超过几分钟保持环境一致性

    模型能模拟自然现象,并展现真实世界的物理特性。

    支持跨越地理和时间界限,生成如阿尔卑斯山、威尼斯、古希腊等多样场景

    通过自回归方式逐帧生成,Genie 3 能在几分钟内保持环境物体和细节的一致性,视觉记忆最长可达一分钟。

    不仅支持导航,还能通过文本 prompt 动态改变世界事件

    可为 AI 智能体(如 SIMA agent)生成丰富环境,支持复杂目标的达成和长期任务训练

    详细信息:https://deepmind.google/discover/blog/genie-3-a-new-frontier-for-world-models/

    Invalid media: video

  7. WAIC刚落幕,AI圈又传来新消息,苹果组建了新的AI团队

    WAIC刚落幕,AI圈又传来新消息,苹果组建了新的AI团队。
    AI领域迭代日新月异,如果你想掌握更多AI领域专业前沿的知识,不妨来ima看看这几个知识库👇

    · 智能体宇宙

    身为AI开发者,担忧Agent框架复杂难上手? 作为产品经理,头疼智能体商业落地难?......快来特工宇宙团队@缱绻怡然 的「智能体宇宙」知识库找答案!
    精选AI Agent领域前沿论文、研报、白皮书等权威专业内容,助你一站式掌握前沿方法论与硬核案例,高效构建下一代AI Agent!📈

    · AGI数据库.腾讯研究院

    由腾讯研究院打造的官方知识库,精选每日全球最新AI技术与产业动态——从ChatGPT升级到机器人革命,从大模型趋势解读到医疗AI突破,
    看不懂技术新名词?跟不上日新月异的产品迭代?
    你对AI的各种困惑与好奇,都能在这里找到答案💬

    · 人形机器人、具身智能资料库 [强烈推荐]

    腾讯科技官方打造「人形机器人、具身智能资料库」,涵盖高盛、斯坦福、MIT等知名机构的论文研报。如果你也想了解人形机器人,好奇它们的技术底层逻辑和行业发展动态,就来这个知识库找答案吧!🤖

    · 故事接龙StoryStormAI社区

    想要学习AIGC创作,却不了解应该用什么软件?如何写好提示词?快来向这个知识库提问吧!
    涵盖3000+份AIGC领域的优质内容,为你提供专业、全面的AIGC实战技巧与行业动态,从入门到进阶,帮助你快速成长,高效上手AIGC创作📝

    更多知识库内的精彩内容,欢迎扫描下方知识码,或在ima各端中搜索知识库名称一探究竟🔍

    如果你也有其他优质的知识库想分享,欢迎加入圈子「知识库研究小组」,带话题 #安利我的ima知识库 ,发布动态向大家安利吧!

    和ima一起,让知识流动起来🌊

  8. 这篇文章有意思

    这篇文章有意思。

    提出在 AI Agent 时代,任何“固定费率+高token消耗”的订阅模式都难以为继。

    他分析了一下目前虽然 LLM 不断的在降价,但是综合的 LLM 成本反而在越来越贵的原因和这种现象会产生的问题。

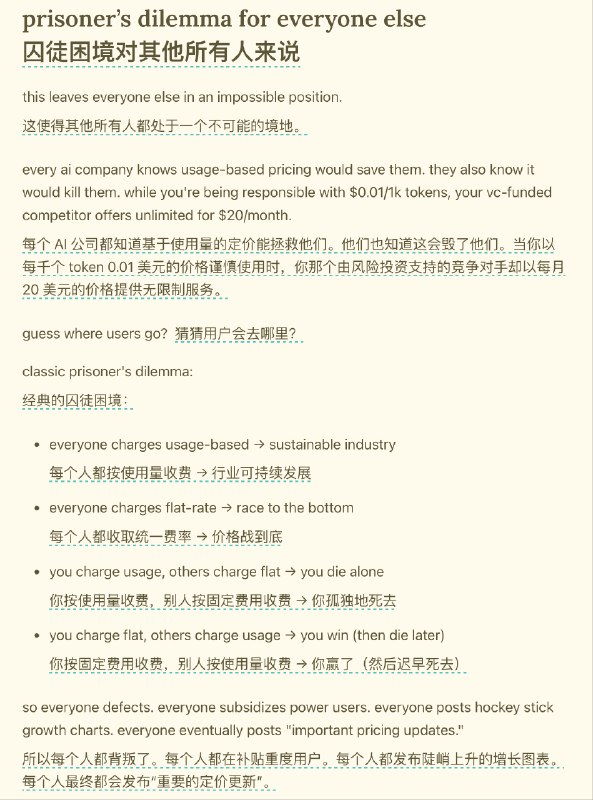
    前段时间的 Cursor 涨价和 Claude Code 涨价都反应了这种囚徒困境。

    同时还分析了一下避免这种问题的几个方法。

    详细内容:

    许多AI公司认为,只要模型推理成本每年下降10倍,先亏损后盈利是可行的。但现实是,虽然如GPT-3.5等旧模型确实变便宜了,但用户需求始终集中在最新、最强的前沿模型(SOTA),而这些模型的价格始终居高不下。

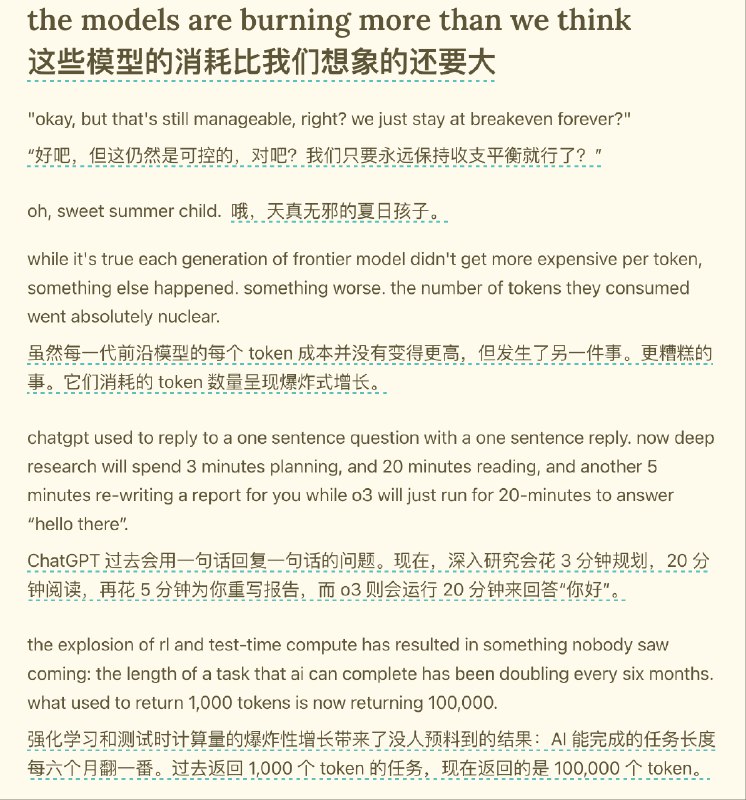
    虽然每个token的成本没变高,但AI模型每次任务消耗的token数量却呈指数级增长。AI代理和长时间任务让单用户每日消耗的成本远超传统订阅价格(如$20/月),导致公司亏损加剧。

    在AI Agent时代,任何“固定费率+高token消耗”的订阅模式都难以为继。

    Anthropic等公司尝试通过高价(如$200/月)、模型自动切换、部分计算卸载到用户本地等方式应对,但依然无法阻止token消耗失控,最终不得不取消无限量套餐。

    所有AI公司都明白按用量计费才可持续,但只要有竞争对手提供低价无限量,用户就会流向后者,导致行业陷入“价格战—亏损—倒闭”的恶性循环。

    三种可能的出路

    从一开始就按用量计费:理论上可行,但消费者普遍讨厌计量收费,实际难以增长。

    制造高切换成本:如Devin等企业级AI,通过深度集成和复杂流程锁定大客户,利润率高但市场有限。

    垂直整合,基础设施变现:如Replit,将AI代理与托管、数据库、监控等服务打包,AI推理作为引流,真正盈利点在于全栈服务。

    文章地址:https://ethanding.substack.com/p/ai-subscriptions-get-short-squeezed