AI探索指南

  1. 搜狗翻译 - 支持中、英、法、日等50多种语言之间的互译功能

    搜狗翻译 - 支持中、英、法、日等50多种语言之间的互译功能
    搜狗翻译 支持中、英、法、日等50多种语言之间的互译功能

    链接:
    https://fanyi.sogou.com/text

    #Ai工具推荐

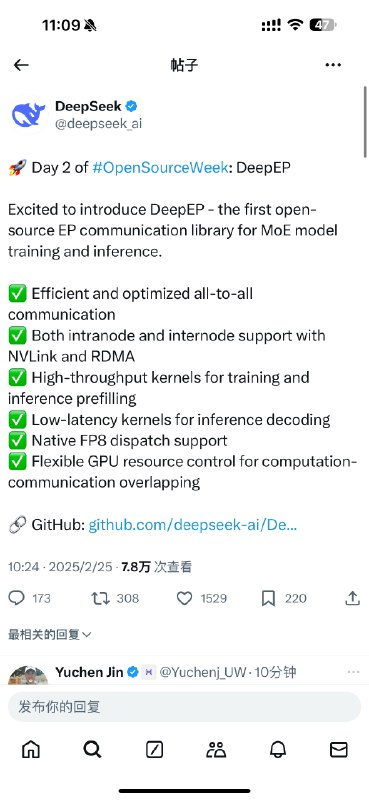
  2. 我奶奶都看得懂的解读,关于Deepseek刚开源的DeepEP

    我奶奶都看得懂的解读,关于Deepseek刚开源的DeepEP

    1. DeepEP 是干嘛用的?
    想象一下,你要训练一个超级大的“AI大脑”(比如 GPT 这种大模型)
    这个里面有很多“小专家”(Experts),每个专家处理不同的任务
    当数据传给这些专家时,需要把数据发给它们(分发),处理完后再把结果汇总(合并)
    这个过程需要大量的通信,就像在各个办公室之间送文件一样
    但传统的方法效率很低,经常会出现以下问题⬇️
    1️⃣ 快递太慢:数据在 GPU 和网络之间来回传,浪费时间
    2️⃣ 堵车:太多数据同时传输,导致网络瘫痪
    3️⃣ 算力浪费:GPU 在等数据的时候干着急,没法工作
    DeepEP 就像是一个超级高效的“物流公司”,专门优化这种通信过程,让数据传得更快、更不堵车,还能让 GPU 一边算一边等数据,不浪费时间

    2. 它有哪些厉害的功能?
    1️⃣ 超快“分拣中心”
    FP8/BF16 支持:用更少的数据位数(比如 FP8 是半精度浮点数)传输,省带宽、省时间,还能保持结果基本准确
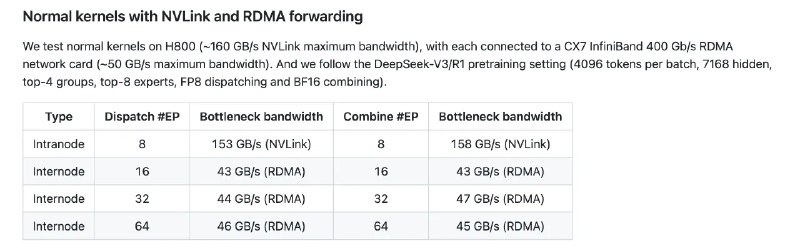
    硬件直连:专门为Hopper GPU 设计,直接利用显卡内部的超高速通道(NVLink)和网卡(RDMA)传输数据,就像给快递车装上了火箭引擎🚀
    2️⃣ 智能“交通调度”
    虚拟车道隔离:给不同的任务(比如训练和推理)分配独立的网络通道,避免互相干扰(就像高铁和公交车走不同的轨道)
    自适应路由:自动避开网络拥堵路段,但可能会稍微增加一点延迟(适合对延迟要求不高的场景)
    3️⃣ 边算边传(不堵车)
    零 SM 占用通信:在传输数据时,GPU 的计算单元(SM)可以继续工作,不用停下来等数据(就像你边做饭边接电话,互不打扰)
    双微批重叠:把一个小批次的数据分成两次传输,中间插着计算任务,充分利用时间差

    4. 性能有多牛?(举个栗子🌰
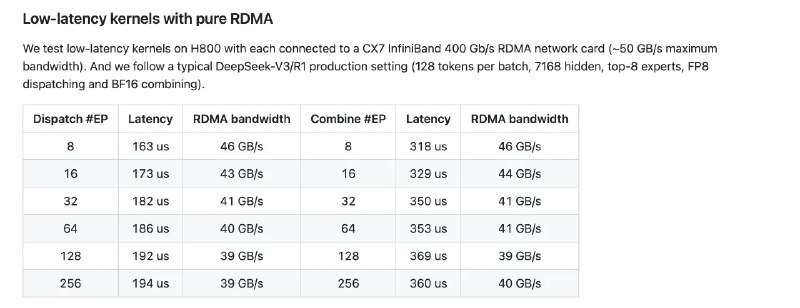
    假设你要给 64 个专家(EP)分发数据:
    🚲普通方法:传输速度46GB/s,延迟300us(像骑电动车送货)
    ✈️用DeepEP:传输速度46 GB/s,但延迟下降到了160us(相当于坐超音速飞机送货)

    而且,它还能根据你的硬件环境(比如用多少 GPU、多大的网卡)自动调优,就像有个AI调度员帮你安排最优路线

    这波还是在Nv上的优化,dpsk你不会真的在拉nv市值吧hhhhh
    然后第五天来个大的🤣🤣🤣

  3. 凌晨2点半,Claude发3.7 Sonnet,凌晨5点半,阿里发了推理模型QwQ-Max的预览版,早上10点DeepSeek开源了一个DeepEP代码库,然后晚上10点20,阿里的视频模型万相2.1,也来了

    凌晨2点半,Claude发3.7 Sonnet,凌晨5点半,阿里发了推理模型QwQ-Max的预览版,早上10点DeepSeek开源了一个DeepEP代码库,然后晚上10点20,阿里的视频模型万相2.1,也来了。

    还有必须提一下的文字生成,万相是全世界第一个能直出中文字的,现在能在AI视频里,直接生成中文的AI视频模型太少了。

    低配置的模型真的小,1.3B的模型,只需要8个G的显存就能跑了,也就是说,本地的4060都能跑得动了。如果你有4090,跑一条5秒钟的480P视频的时间大概只要4分钟。

    万相2.1开源链接在此:Huggingface的:https://huggingface.co/Wan-AI

    GitHub的:https://github.com/Wan-Video/Wan2.1 Wan-AI (Wan-AI)

  4. 何小鹏再发全员信:告别 PPT,用 AI 整顿无效会议

    何小鹏再发全员信:告别 PPT,用 AI 整顿无效会议

    把 PPT 换成云文档,用 AI 做会议纪要,曾经在飞书经历过这种体验,然而无效会议,更多了。

    这可能也是一种杰文斯悖论:会议变得更方便时,会议的总量会更多,而不是减少。

    当会议总量变多时,无效会议也会更多。

    会议是否有效,更大程度上取决于不开会。不开会的时间越多,越有机会在会前做深度思考和准备。会前准备,是会议是否有效的关键因子。用 PPT,只要在形式上有基本要求(比如统一模板,不卷形式),这和用文档,就是一样的。真卷形式的人,文档也能给你卷出花来。而且文档很容易又长又臭,非常难读。

    会中,要有主持人,并推荐采用罗伯特议事法。发言、争议等,有原则约束,出现无效沟通时,主持人可打断,发现会议无法继续时,可叫停,后续再开。罗伯特议事法,比飞阅会,有效太多。飞阅会也很容易陷于形式。

    会后,真心不推荐所谓的 AI 总结。远不如主持人花上半个小时,认真做总结。牺牲主持人半个小时,让所有与会者能得到一份靠谱的会议总结,比节省主持人半个小时,但牺牲所有与会者去看不靠谱的 AI 总结,明显传统方式更高效。

    最好的会议,是少开会。

    少开会意味着,组织设计合理,日常工作过程中,很多沟通就自然发生了。

    少开会意味着,每次开会都很重要,会前充分准备,会中有序组织,会后认真总结。现阶段,往往不用 AI,对所有人是最高效的。

    展望未来,真正期待的 AI 会议提效,是每个人都有一个 AI 分身。需要沟通时,AI 分身先彼此通过开会等方式去沟通。沟通完了,还有需要进一步沟通或决策的,肉身再去开会。

  5. 聊到AI时代的组织,我们定义了PPD指标—PM to Prompt Distance,也就是产品经理如果要改 prompt 需要经过几个人之手

    聊到AI时代的组织,我们定义了PPD指标—PM to Prompt Distance,也就是产品经理如果要改 prompt 需要经过几个人之手。PPD 大于 2,这个组织多半做不好AI产品;PPD等于2,及格线但很危险;只有PPD为1和0,这样的团队才有战斗力。

  6. 宇树又发了一个G1机器人的视频,这次是练功夫,说实话这次动作的自然度、平衡性的把握更厉害,估计又要有人说这个AI生成的了

    宇树又发了一个G1机器人的视频,这次是练功夫,说实话这次动作的自然度、平衡性的把握更厉害,估计又要有人说这个AI生成的了。
    必须夸一下,人形机器人已经烂大街了,功夫才有特色。