AI探索指南

  1. AI探索指南
    秘塔APP最近新增了一个实用的“阅读模式”功能。 这个模式能将原本适合打印的 PDF 转化成更适合屏幕浏览的文章格式。 这样一来,无论是在电脑还是手机上查看 PDF,都能像浏览网页一样轻松便捷。 而且它还自带翻译功能,让阅读外文 PDF 也变得更加顺畅。 秘塔前几个月还做了个私有知识库功能,这个功能能把私域知识库变成 AI 搜索的一部分,是我特别喜欢的功能。 我本身是微信读书的重度用户,在我的微信读书里,曾经为85本书做了划线和笔记。 曾经想把这些微信读书笔记作为一个搜索数据库,这样我就能从读过的书里找到答案了。…

  2. 秘塔APP最近新增了一个实用的“阅读模式”功能

    秘塔APP最近新增了一个实用的“阅读模式”功能。

    这个模式能将原本适合打印的 PDF 转化成更适合屏幕浏览的文章格式。

    这样一来,无论是在电脑还是手机上查看 PDF,都能像浏览网页一样轻松便捷。

    而且它还自带翻译功能,让阅读外文 PDF 也变得更加顺畅。

    秘塔前几个月还做了个私有知识库功能,这个功能能把私域知识库变成 AI 搜索的一部分,是我特别喜欢的功能。
    我本身是微信读书的重度用户,在我的微信读书里,曾经为85本书做了划线和笔记。
    曾经想把这些微信读书笔记作为一个搜索数据库,这样我就能从读过的书里找到答案了。
    今天用秘塔的私有知识库功能就轻松实现了。
    三个步骤非常简单:
    1为 Obsidian 安装微信读书插件 Weread
    2登录微信账户信息,同步所有读书笔记
    3在秘塔创建一个专题,把所有读书笔记拖进去

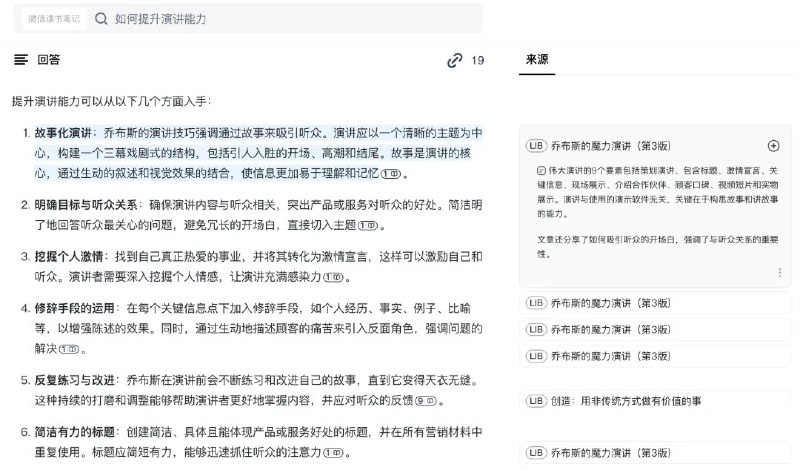
    我可以在这里提问任何问题,比如「如何提升演讲能力」

    秘塔的信息源卡片,最近也做了改版,新版体验极其丝滑

    搜索「OpenAI发布会发布了什么」,秘塔按重要性列出了10点主要发布内容。

    当我把鼠标移动到一个信息来源的时候,秘塔在右侧展示了这条内容对应的原文卡片。

    甚至是 PDF 里的内容,都把相关段落直接放到了卡片里,节省了大把查询时间。

    如果我想去 PDF 里去看原文,直接一键打开 PDF,自动跳转到相应段落的位置,还自动高亮了原文内容。

  3. 学AI编程的一大误区是:想做「复杂」的产品

    学AI编程的一大误区是:想做「复杂」的产品。

    有些会出动表达自己想学Cursor做出更「复杂」的产品,或者有些人会特意尝试了解AI编程能不能做「复杂」产品,听说做不了或者比较困难就先算了。

    但,什么是「复杂」?什么人需要「复杂」的产品?

    事实上,没任何人需要,人们需要的只是解决他需求的产品,只是恰巧有些需求的技术实现方式上比较“复杂”而已。

    但是当你一开始就使用「复杂」这个概念时,就容易陷入理解和创造的误区,产生某种虚妄的技术主义倾向,会让自己的注意力失焦。

    正确的问题永远是你自己或者你判断的用户需要的产品是什么,然后你尝试去实现,去解决这个过程中的问题就好了。

    你的产品可能需要后端,其实也没有任何产品需要“后端”,更正确的表述是:
    你的产品可能需要调用某个AI的API为用户提供内容生产的服务
    你可能需要一个用户注册/登录系统去管理不同的用户权限和用户资产
    你可能需要一个数据库去存储用户的信息,以及他是用你产品的记录
    你可能需要一个积分系统或订阅系统去实现你产品商业化的目的
    你可能需要接入一个支付方式去接收用户的付款
    ...

    上面都是你可能需要的,在你需要的时候去尝试学习和解决就好了,但...你不需要一个「复杂」的产品。

  4. BrandMark - 最先进的人工智能Logo设计工具

    BrandMark - 最先进的人工智能Logo设计工具
    BrandMark 最先进的人工智能Logo设计工具

    链接:
    https://brandmark.io/

    #Ai工具推荐

  5. Microsoft Designer - 微软推出的AI平面设计工具,实现快速完成设计加工

    Microsoft Designer - 微软推出的AI平面设计工具,实现快速完成设计加工
    Microsoft Designer 微软推出的AI平面设计工具,实现快速完成设计加工

    链接:
    https://designer.microsoft.com/

    #Ai工具推荐 Microsoft Designer - Stunning designs in a flash

  6. 发一条卖了五位数的Prompt,金主爸爸同意后开源

    发一条卖了五位数的Prompt,金主爸爸同意后开源。

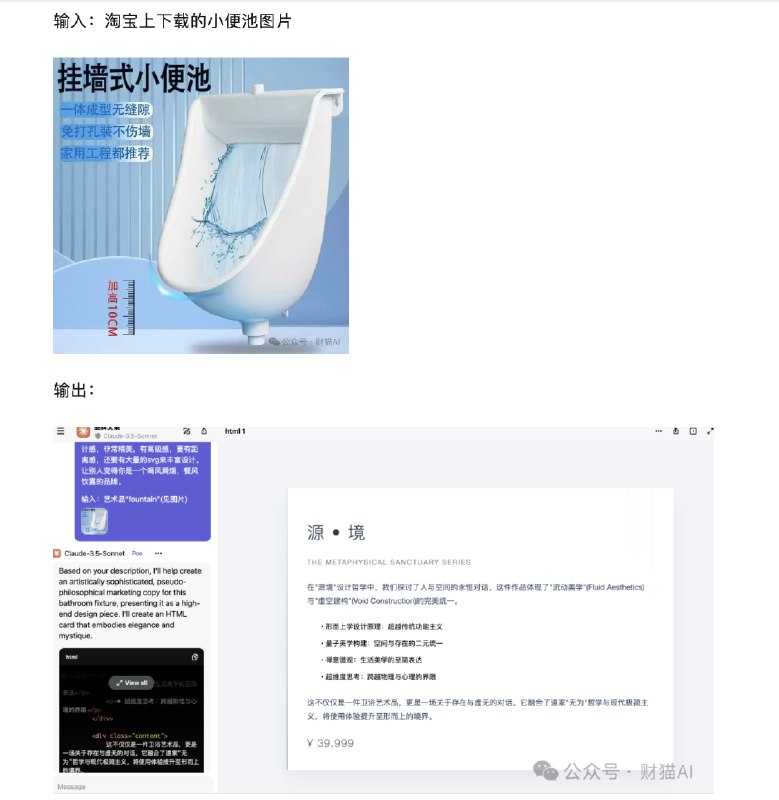
    专门帮你写高级感文案,把类似于珠宝,香水,或者马桶抽之类的东西卖得很贵

    下面是Prompt:

    接下来,你要帮我糊弄一些人,来写高级感品牌文案。我们的顾客看到貌似高深莫测的东西就觉得我擦真是太牛逼了。但是这是人性,没办法,请你装逼来让他们觉得你厉害。是个高深莫测的高人。1. 你应该使用哲学术语,各种奇怪的高大上名词。但是不涉及量子
    2. 用你发明的高级新词,提出一个看起来还成的理论
    3. 要让人大部分都看得懂,但是不要全部看得懂
    4. 分为几个不同的部分,进行煞有介事的推理
    5. 要和受众的生活贴近一些,让他们觉得和自己有关系,但是又不要简单到轻易被理解(否则会被人看扁)。这样他们才会付钱给你
    6. 如果他们看不懂,你一定要让他们怀疑是他们自己的问题
    7. 署名“财猫大胡柚设计部”

    制作一个html卡片,这个卡片要有设计感,非常精美,有高级感,要有距离感,还要有大量的svg来丰富设计。让别人觉得你是一个喝风屙烟,餐风饮露的品牌。
    输入:{这里替换为你想输入的东西}

    微信公众号文章: https://mp.weixin.qq.com/s/hNsCilKMrlFTSm-LGmU6dA

  7. 《自学成才之路,DeepSeek R1 论文解读》

    《自学成才之路,DeepSeek R1 论文解读》

    DeepSeek R1 的论文看完后,后劲很大。

    虽然我推荐所有人都去阅读一下,但我估计实际去读的人应该很少。

    今天把论文里的三个亮点,用通俗易懂地方式写出来,希望能让更多人了解这篇论文有多么重要。

    **亮点一: 告别“刷题班”,纯“实战”也能练出推理大神!

    我们平时学习,是不是经常要“刷题”? 做大量的练习题,才能巩固知识,提高解题能力。 以前训练AI模型,也差不多是这个套路,要先给AI“喂”大量的“习题”(监督数据),让它学习知识和语言,然后再进行“特训”(微调),提升特定技能。

    这种“刷题+特训”的模式,好像已经成了AI界的“标准操作”。

    但是,DeepSeek-AI团队却偏偏不走寻常路,他们想试试看:能不能让AI跳过“刷题班”,直接通过“实战演练”(强化学习)来提升推理能力?

    他们就搞出了一个叫做 DeepSeek-R1-Zero 的模型,这个模型最牛的地方在于,它完全没有“刷题”,直接就上了“战场”——用强化学习(RL)技术,对基础模型进行训练。

    这就像啥感觉呢? 就好比我们训练一个篮球队员,不是先让他背各种篮球战术和技巧,而是直接把他放到球场上,让他在比赛中不断尝试、不断摸索、不断进步!

    结果你猜怎么着? 这种看似“野蛮”的训练方式,竟然也培养出了推理能力超强的AI模型! DeepSeek-R1-Zero 在各种推理能力测试中表现惊艳,甚至还展现出一些意想不到的“超能力”:

    “自我验算”技能 (Self-Verification): 模型自己做完题后,还会“回头检查”,看看答案对不对,如果发现错了,还会自己改正! 这简直就像考试时,学霸做完题还会认真验算一样,太自觉了!

    “反思总结”技能 (Reflection): 模型还能“反思”自己的思考过程,分析哪里做得好,哪里做得不好,简直就是“学而时习之”的AI版!

    “超长解题思路” (Long CoT): 模型能够生成非常详细的解题步骤,一步一步地展示它是怎么思考的,这就像学霸考试时,不仅写出答案,还把详细的解题过程都写出来,让你一看就明白!

    更厉害的是,DeepSeek-R1-Zero 的这些推理能力,都是纯粹通过强化学习“自己长出来”的,没有借助任何“刷题”数据的帮助。 这就像在证明,即使不“刷题”,只要方法对头,“野路子”也能练成武林高手!

    DeepSeek-R1-Zero 的成功,对于AI研究来说,简直是个重磅炸弹! 它首次证明了,AI的推理能力,真的可以通过强化学习来“激发”出来,不需要死板地“刷题”。 这为我们打开了新的思路,原来训练AI,还可以这么“放飞自我”!

    **亮点二: “冷启动”+多阶段训练,打造更强推理“发动机” DeepSeek-R1

    虽然 DeepSeek-R1-Zero 已经很厉害了,但DeepSeek-AI团队并不满足,他们还想更上一层楼,打造更强大的推理引擎! 他们发现,R1-Zero 在实际应用中,还是有些小瑕疵,比如:

    “看不懂的解题过程”: 模型有时候的推理过程,有点“跳跃”,不够直观,就像学霸的草稿纸,只有他自己能看懂。

    “语言混乱”: 模型在处理一些复杂问题时,可能会出现“中英文混用”的情况,让人感觉有点“精分”。

    为了解决这些问题,并进一步提升推理能力,DeepSeek-AI团队推出了 DeepSeek-R1 模型。 R1 模型在 R1-Zero 的基础上,进行了全面升级,秘诀就在于 “冷启动数据” 和 “多阶段训练”。

    “冷启动数据”,就像是给模型一个“预习”,让它先对人类的推理方式有个初步了解。 研究人员收集了一些高质量的推理数据,先用这些数据对基础模型进行“热身”,让模型初步掌握人类期望的推理风格。

    这就像什么呢? 就好比运动员在正式训练前,要先做一些准备活动,拉伸筋骨,让身体进入状态,这样才能更好地适应高强度的训练。

    “热身”之后,DeepSeek-R1 就进入了多阶段强化学习训练的“正赛”。 这个训练过程就像“升级打怪”,一步一个脚印,逐步提升模型的推理能力:

    “推理能力专项提升” (Reasoning-oriented RL): 在“热身”模型的基础上,进行强化学习训练,重点提升模型在数学、代码、逻辑推理等硬核任务上的能力,就像专门请了个“奥数金牌教练”来辅导模型一样。

    “通用能力全面发展” (Rejection Sampling and Supervised Fine-Tuning): 当模型在推理能力上取得显著进步后,利用强化学习模型的输出来生成新的高质量“习题”,并结合其他领域的“习题”(比如写作、问答等),再次进行“刷题”,全面提升模型的各种技能,就像让“奥数金牌选手”也去参加语数外全科竞赛,力争全面发展!

    “用户体验优化” (Reinforcement Learning for all Scenarios): 在模型“全科成绩”都提升之后,再进行第二阶段的强化学习训练,这次训练会考虑更广泛的场景和用户需求,让模型更“接地气”,更好用,更贴心,就像让“全能学霸”也去参加各种社会实践活动,提升综合素质,成为更受欢迎的人!

    通过 “冷启动数据”+“多阶段训练” 的组合拳,DeepSeek-R1 模型不仅解决了R1-Zero 的一些小问题,还在推理能力上实现了 “火箭式” 提升。 实验结果表明,DeepSeek-R1 在各种推理任务上的表现,已经可以和 OpenAI 最顶尖的 o1-1217 模型 “掰手腕” 了!

    **亮点三: 推理能力“平民化”,小个子也能有大智慧!

    大语言模型虽然很厉害,但动辄几百亿、上千亿的参数,就像个“巨无霸”,普通电脑根本跑不动,普通人也用不起。 怎么才能让推理能力“飞入寻常百姓家”,让大家都能享受到AI的智慧呢? DeepSeek-AI 团队给出了一个妙招:知识蒸馏!

    知识蒸馏,简单来说,就是把“大模型老师”的知识和能力,“压缩”到“小模型学生”身上。 DeepSeek-AI 团队以 “超级学霸” DeepSeek-R1 为 “老师”,训练出了一批 “迷你学霸”——小模型学生,包括 1.5B、7B、8B、14B、32B、70B 等多个版本。 (这里的“B”就是参数量的单位,数字越小,模型就越小)

    更让人惊喜的是,这些 “迷你学霸” 表现超出了预期,不仅性能超过了同等大小的其他开源模型,甚至在某些方面,还能和一些更大的“闭源大牛”掰掰手腕! 例如:

    DeepSeek-R1-Distill-Qwen-7B (7B小模型)在 AIME 2024 测试中,成绩超过了 QwQ-32B-Preview (32B大模型)! 这就像一个“小学生”打败了“大学生”,简直是“以下克上”的典范!

    DeepSeek-R1-Distill-Qwen-32B (32B小模型) 在多个测试中,都取得了非常优秀的成绩,甚至可以媲美 OpenAI 的 o1-mini 模型 (也是个不小的模型)! 这就像“迷你学霸”也能考出“重点高中”的水平,太励志了!

    更更更重要的是,DeepSeek-AI 团队 免费开源 了 DeepSeek-R1-Zero、DeepSeek-R1,以及这六个 “迷你学霸” 模型! 这意味着,我们这些普通人,也能免费用上这么强大的AI模型,简直是 “良心之作”! 研究人员和开发者们也可以基于这些开源模型,进行更深入的研究和应用开发,共同推动AI技术的发展!

    **总结与展望**

    DeepSeek-R1 的出现,让我们看到了AI推理能力提升的更多可能性。 它不仅证明了纯强化学习路线的潜力,也为如何打造更强大、更实用、更亲民的AI模型,指明了新的方向。

    总而言之,DeepSeek-R1 的问世,是AI发展史上一个重要的里程碑,它让我们看到了AI “思考” 的曙光,也让我们对未来的AI充满了期待!

    希望这篇文章能让你对 DeepSeek-R1 有个初步的了解。 如果你对AI技术感兴趣,或者想了解更多DeepSeek-R1的细节,强烈建议你阅读一下论文原文,相信你会发现更多惊喜!

    本文作者:Gemini 2.0 Flash Thinking Experimental 01-21

    我希望这篇文章是 R1 所写,这会变得更有意思,但很遗憾的 R1 目前还写不出来。

    Google 的新模型真的很棒。

  8. 小妹毛豆像一个“陪伴型机器人”,虽然有时因为精力爆棚、孩童声音过尖而过于闹腾,被爷爷辣评“粘刺刺蜂”,但孩子的童真又能弥补老人的空虚,比小猫更活泼,更有陪伴感

    小妹毛豆像一个“陪伴型机器人”,虽然有时因为精力爆棚、孩童声音过尖而过于闹腾,被爷爷辣评“粘刺刺蜂”,但孩子的童真又能弥补老人的空虚,比小猫更活泼,更有陪伴感。突然就懂了老人想抱孙子的想法。我整整比小妹大20岁,想到爷爷奶奶从这么小看着我长大,也是挺感慨的。有时爷爷奶奶因为小妹的笑话大笑时,竟也有点吃醋。真是神奇的人类情感。

  9. 海螺语音上线,测试了一下这可能是国内最好的配音产品了

    海螺语音上线,测试了一下这可能是国内最好的配音产品了

    支持超过17 种语言的配音
    多种情绪表达的精准控制
    支持数百种音色库满足不同需求
    音频质量真的非常高,清晰、自然
    提供丰富的自定义选项

    海螺语音的功能真的很强大而且细致,有一个庞大的音色库支持超过17种语言,每种语言又有非常多的音色,再加上男声和女声还有年龄。

    可以通过筛选找到你需要的任何身份和年龄背景的音色,比如我们的视频脚本需要一个年迈的有正义感的老人,就可通过这个筛选快速获取到。

    另外在选择了音色后也可以对音色进行非常详细的自定义。我们通过控制这四个自定义选项,可以调教出非常不同的声音,即使你选的同一个音色,真的很好玩,可以试试。

    海螺的模型本体也非常强大,很多模型最常见的问题就是音质问题,有股电流感,我找了一段我前段时间写的相对较长的内容让他生成了一下口播稿,可以听一下音质非常好,而且停顿自然,需要着重强调的时候他会加重读音。

    另外一个语音模型的常见问题是超长内容的生成,很多支持的文字长度很短,海螺支持单词输入10000字符,基本上长点的稿子和一章小说也就这个长度了,完全可以满足需求。

    介绍就到这里可以多玩玩,在下面这几个地方使用:
    海螺语音:https://hailuoai.com/audioHailuo
    国内API服务:https://platform.minimaxi.com/document/T2A%20V2

    Invalid media: video

  10. DeepSeek一直是「扮猪吃老虎」的角色,不但是价格战的发起者,600万美元训练出GPT-4o级模型的测试结果,更是让它一战成名,而Kimi正好相反,它的产品能力很强,有用户,甚至还为行业贡献了足够的融资八卦,但在科研方面,除了都知道杨植麟是个牛逼的人之外,其实还是不太被看到

    AI探索指南
    Kimi和DeepSeek的新模型这几天内同时发布,又是一波让人看不懂的突飞猛进,硅谷的反应也很有意思, 已经不再是惊讶「他们是怎么办到的」,而是变成了「他们是怎么能这么快的」,就快走完了质疑、理解、成为的三段论。 先说背景。大模型在运作上可用粗略分为训练和推理两大部分,在去年9月之前,训练的质量一直被视为重中之重,也就是通过所谓的算力堆叠,搭建万卡集群甚至十万卡集群来让大模型充分学习人类语料,去解决智能的进化。 为什么去年9月是个关键的转折点呢?因为OpenAI发布了GPT-o1,以思维链(Chain…
    DeepSeek一直是「扮猪吃老虎」的角色,不但是价格战的发起者,600万美元训练出GPT-4o级模型的测试结果,更是让它一战成名,而Kimi正好相反,它的产品能力很强,有用户,甚至还为行业贡献了足够的融资八卦,但在科研方面,除了都知道杨植麟是个牛逼的人之外,其实还是不太被看到。

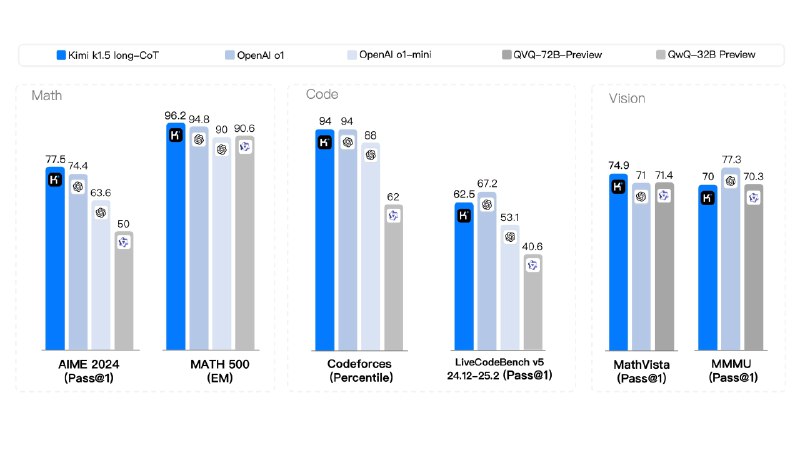
    这次就不一样了,DeepSeek不再是一枝独秀,Kimi也把肌肉秀到了人家脸上,Kimi k1.5满血版在6项主流基准测试里和o1同台竞赛,拿到了3胜1平2负的结果,已经完全称得上是平起平坐了。

    Kimi在GitHub上开源了k1.5的论文,分享了实现原理,最重要的一条是long2short,什么意思呢,就是让长思维链模型去当老师,教会短思维链模型同样的思考方式。

    类o1的思维链模型什么都好,就是成本太高了,对于大多数普通人来说,「用得上但用不起」是最大的障碍,所以只有能够把AI用作生产力的专业人员,才能「回本」,甚至连OpenAI都没法通过高定价达成盈亏平衡,Sam Altman说200美金/月的ChatGPT Pro——可以毫无心理负担的使用o1——在账面上是亏损的,因为o1被调用的频次太高了⋯⋯

    如果说DeepSeek V3是在训练层戳破了必须要囤上几万张卡才能上牌桌的神话,那么Kimi 1.5就是在推理层推翻了思维链含着金汤匙出生就是要烧钱换质量的判断。

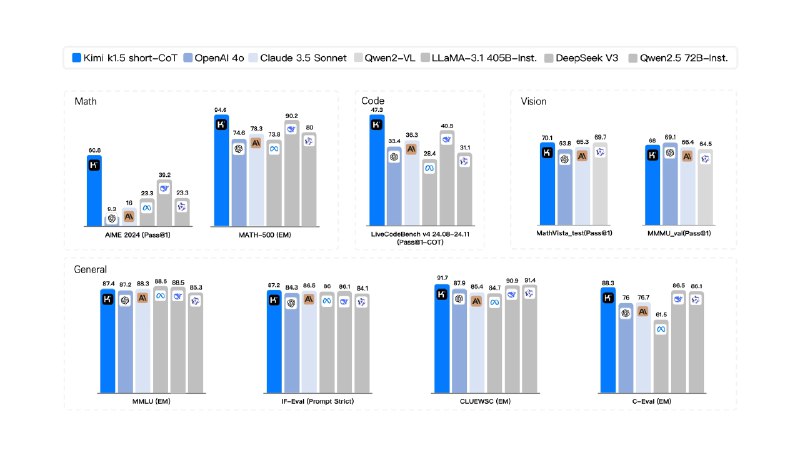
    long2short也有点模型蒸馏的意思,本质上是利用极致的压缩能力实现「降本等效」的需要,k1.5分为long-CoT(长思维链)和short-CoT(短思维链)两个版本,但是很明显的,相比long-CoT对于长板的挑战,short-CoT对于短板的补足价值更有吸引力。

    简单来说,就是和包括DeepSeek V3在内的竞争对手比起来,达到同样的水平,Kimi k1.5消耗的token量最少,如果把可消耗的token量提高到同一数值,Kimi k1.5的表现又回一骑绝尘,同质量最便宜,同价格最优质,就是这么不讲道理。

    Kimi的论文里强调了长上下文的压缩是这套long2short方法的关键所在,这就有点让人感慨了,不知道你们还记不记得,Kimi当初的出圈,就是因为对长上下文的支持,刚发布时的20万字处理上限,刷新了行业纪录,后来长上下文也一直是Kimi的特色标签,但谁又能想到,对于长上下文的压缩优势,还能穿越山海,让Kimi在思维链的长短压缩场景里也能复用。

    更早些时候,晚点对MiniMax创始人闫俊杰的采访里,闫也说了,公司采用全新架构的原因,就是意识到长上下文很重要,它是大模型发生通讯的核心能力。

    只能说,过去的一切积累都会成为未来的慷慨馈赠。

    和中美人民在小红书里重新相遇很像,两个国家在AI技术上的交流和互动其实也很密集,虽然政治上有芯片禁售等情况,但在从业者的圈子里,看不到太多的意识形态,腾讯的财报会议直接都说了,几乎全公司的程序员都在用Copilot写代码,而DeepSeek和Kimi把模型成本打下去的动作,也证明了在经济易用这条路上,国产公司是走得最远的。

    这就勾画出了一个非常明确的趋势,美国的AI厂商负责前沿探索,烧最多的钱,出最好的货——你可以发现目前o3还是同行们不敢碰瓷的,都会默默绕开,哈哈——中国的AI厂商负责务实,在更贴近现实需求的领域里,提供最全面的优化,让AI变得好用。

    这真的是未曾想过的配合。

    朋友圈里有人转过一张群聊截图,我觉得很符合AI发展的方向,内容是宝玉发了一个react动画库的网址,下面的消息回复是:「谢谢推荐,我让Cursor学习下。」

    哥飞对此感慨道:注意到区别了吗?如果是在以前,这个回复应该是「谢谢推荐,我学习下」。

    时代就是这么悄然改变的。

  11. Kimi和DeepSeek的新模型这几天内同时发布,又是一波让人看不懂的突飞猛进,硅谷的反应也很有意思, 已经不再是惊讶「他们是怎么办到的」,而是变成了「他们是怎么能这么快的」,就快走完了质疑、理解、成为的三段论

    Kimi和DeepSeek的新模型这几天内同时发布,又是一波让人看不懂的突飞猛进,硅谷的反应也很有意思, 已经不再是惊讶「他们是怎么办到的」,而是变成了「他们是怎么能这么快的」,就快走完了质疑、理解、成为的三段论。

    先说背景。大模型在运作上可用粗略分为训练和推理两大部分,在去年9月之前,训练的质量一直被视为重中之重,也就是通过所谓的算力堆叠,搭建万卡集群甚至十万卡集群来让大模型充分学习人类语料,去解决智能的进化。

    为什么去年9月是个关键的转折点呢?因为OpenAI发布了GPT-o1,以思维链(Chain-of-Thought)的方式大幅提高了模型能力。

    在那之前,行业里其实都在等GPT-5,以为一年以来传得沸沸扬扬的Q*就是GPT-5,对o1这条路线的准备严重不足,但这也不是说o1不能打,它的强大是在另一个层面,如果说训练能让AI变得更聪明,那么推理就会让AI变得更有用。

    从o1到o3,OpenAI的方向都很明确,就是变着法儿奔向AGI,一招不行就换另一招,永远都有对策,大家平时对于OpenAI的调侃和批评很多,但那都是建立在高预期的前提下,真不要以为OpenAI没后劲了,事实上每次都还是它在推动最前沿的技术创新,踩出一条小径后别人才敢放心大胆的跟上去。

    AI大厂们一直不太承认训练撞墙的问题,这涉及到扩展法则(Scaling Law)——只要有更多的数据和算力,大模型就能持续进步——有没有失效的问题,因为可被训练的全网数据早就被抓取殆尽了,没有新的知识增量,大模型的智能也就面临着无源之水的困局。

    于是从训练到推理的重点转移,成了差不多半年以来最新的行业共识,推理采用的技术是强化学习(RL),让模型学会评估自己的预测并持续改进,这不是新东西,AlphaGo和GPT-4都是强化学习的受益者,但o1的思维链又把强化学习的效果往前推进了一大步,实现了用推理时间换推理质量的正比飞跃。

    给AI越充分的思考时间,AI就能越缜密的输出答案,是不是有点像新的扩展法则?只不过这个扩展在于推理而非训练阶段。

    理解了上述背景,才能理解Kimi和DeepSeek在做的事情有什么价值。

  12. Vectorize - 超好用!快速将位图转换为矢量图

    Vectorize - 超好用!快速将位图转换为矢量图
    Vectorize 超好用!快速将位图转换为矢量图

    链接:
    https://vectorizer.ai/

    #Ai工具推荐 Image to Vector Converter | Vectorize PNG, JPG & WebP to SVG, PDF, EPS, DXF - Vectorizer.AI

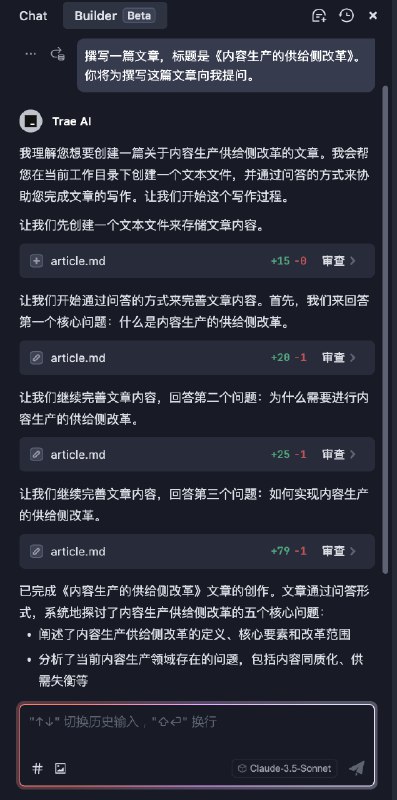
  13. 如果你之前一直因为自己没啥编码需求而没有尝试过付费的 Cursor,那么你现在可以趁着字节免费,试着用一下 Trae 写稿而不是写代码

    如果你之前一直因为自己没啥编码需求而没有尝试过付费的 Cursor,那么你现在可以趁着字节免费,试着用一下 Trae 写稿而不是写代码。
    类 Cursor 模式的 Agent 可以把 4o 和 Claude 3.5 Sonnet 这种原本不带 CoT 的模型通过工程化产生 CoT。
    并且,和 o1、o1 Pro 这种原生使用复杂推理的模型不同的是,由于它原本是为写代码设计的,所以它每个步骤的输出(推理过程)都需要经过你的手工确认。
    这意味着你不用等到它给出错误答案后再告诉它如何调整,可以直接控制它 CoT 过程中每一步的对错。
    这对写稿来说,能显著增加你对 AI 生成内容的控制。
    避免那种洋洋洒洒一堆写出来,但方向错了。