AI探索指南

  1. 沉浸式翻译换 Deepseek V3 真爽,又快又好,还便宜

    沉浸式翻译换 Deepseek V3 真爽,又快又好,还便宜

    看了一下,我这两三天库库用,18 万 Token 只花了一毛三

    可能还有很多人不知道咋换,文字更换方法写下面了👇

    - 先去 Deepseek 开发者后台注册充值(10 元起,新号送 500 万 Token)
    - 获取 API Key,自己找个地方存一下
    - 打开沉浸式翻译翻译服务切换为 Open AI
    - 选择自定义 API Key
    - 填写你获取到的 Deepseek API Key
    - 在模型部分填写:deepseek-chat
    - 下滑找到「展开更多自定义选项」
    - 展开后将「自定义 API 接口地址」改为:https://api.deepseek.com

  2. Z Potentials|玉伯,阿里前端第一人,语雀创始人,辞任字节高管创业AI创作工具,首轮融资近千万美元

    Z Potentials|玉伯,阿里前端第一人,语雀创始人,辞任字节高管创业AI创作工具,首轮融资近千万美元

    为什么选择创业,为什么尸横遍野还入局
    为什么选择了一条缝隙里的缝隙

    为什么视频是大赛道,为什么AI不是幌子
    YouMind的远方在哪

    一切说出来的,都容易错

  3. Kokoro 82M 这个 TTS 模型也太好了

    Kokoro 82M 这个 TTS 模型也太好了

    模型大小只有不到 300M,生成的音频质量很高

    在 T4 上,只需要 4.5 秒就能生成 2 分 25 秒的语音

    可惜的是只支持英文,不过可以按他们的架构训练其他语言,只需要不到 100 小时的音频数据

    模型下载:https://huggingface.co/hexgrad/Kokoro-82M
    模型演示:https://huggingface.co/spaces/hexgrad/Kokoro-TTS

    Invalid media: video

  4. 200美元拜个大哥:我为什么续订了o1 Pro

    200美元拜个大哥:我为什么续订了o1 Pro

    鸭哥这篇文章很安利,看完后我也买了o1 Pro。试用一圈下来确实觉得不太一样。

    如果 Chatgpt 是一个活在你微信上即时回复的助手,那么 o1 pro 更像是你通过邮件通信的一位智者。

    但现在的问题可能是,绝大部分人即使有了爱因斯坦的邮箱也不知道该写什么。

    我相信Chatbot大概率只是这次AI革命中第一个PMF形式。要发挥出来AI的全部潜力,需要更强大的模型,更好的context,更多的工具,适合更强大智能的产品交互形态,以及和任何强大工具一样:需要学习如何使用。

    当金钱或算力能够以更高效率地被转化成生产力,更重要的问题将会从“how”变成“what”,我们究竟要让AI做什么?

  5. InsightFaceSwap - 比Midjourney更丝滑的AI换脸工具

    InsightFaceSwap - 比Midjourney更丝滑的AI换脸工具
    InsightFaceSwap 比Midjourney更丝滑的AI换脸工具

    链接:
    https://insightface.ai/

    #Ai工具推荐 Face Analysis, APIs & Model Licensing | InsightFace

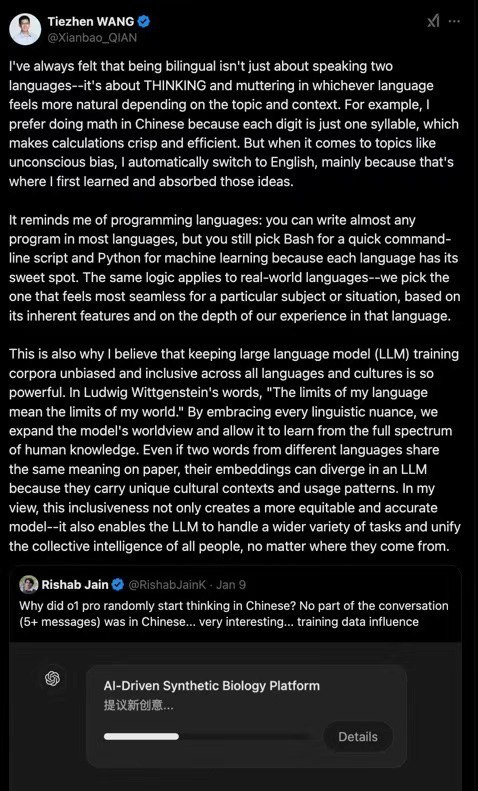
  6. 最近 X 上在讨论为什么大语言模型 O1,有时候会用中文思考?

    最近 X 上在讨论为什么大语言模型 O1,有时候会用中文思考?

    转发一段 Hugging Face 王铁震老师的想法:

    --- DeepSeek 机翻

    我一直觉得,会两种语言不仅仅是能用两种语言交流,而是能根据话题和场景,自然地用更合适的语言去思考。比如,我更喜欢用中文做加减乘除,因为每个数字只有一个音节,算起来干脆利落。但一提到“无意识偏见”这种话题,我就会不自觉地切换到英语,毕竟这些概念我最开始就是从英语里学来的。

    这让我想到编程语言:大多数程序用什么语言都能写,但我还是会用 Bash 写命令行脚本,用 Python 搞机器学习,因为每种语言都有自己最顺手的地方。现实中的语言也一样,我们会根据语言的特点和自己的习惯,选择最顺手的语言去表达特定的内容。

    这也是为什么我觉得,在训练大语言模型(LLM)时,保持所有语言和文化的多样性和包容性特别重要。就像哲学家维特根斯坦说的:“语言的界限就是世界的界限。”只有包容每一种语言的细微差别,才能让模型学到更全面的思维。即使两种语言里的两个词意思一样,它们在模型中的 Embedding 也可能完全不同,因为它们背后的文化和使用方式截然不同。在我看来,这种包容性不仅能打造更公平、更准确的模型,还能让它处理更多样化的任务,汇聚全人类的智慧。

  7. 清图 - 在线修复!国产的 AI 图像处理工具

    清图 - 在线修复!国产的 AI 图像处理工具
    清图 在线修复!国产的 AI 图像处理工具

    链接:
    https://qingtu.cn/

    #Ai工具推荐

  8. 分享一个快速完成 privacy-policy、terms-of-service 和 about 页面、README 文件的方法

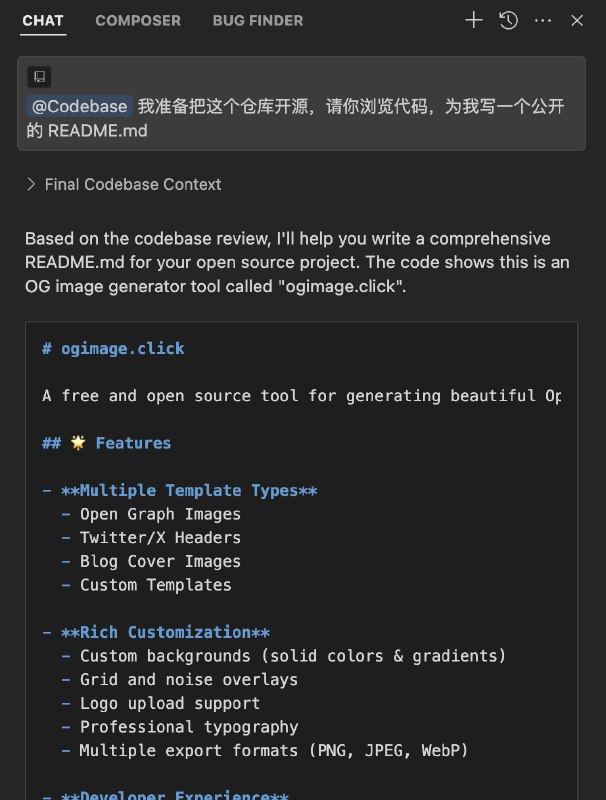
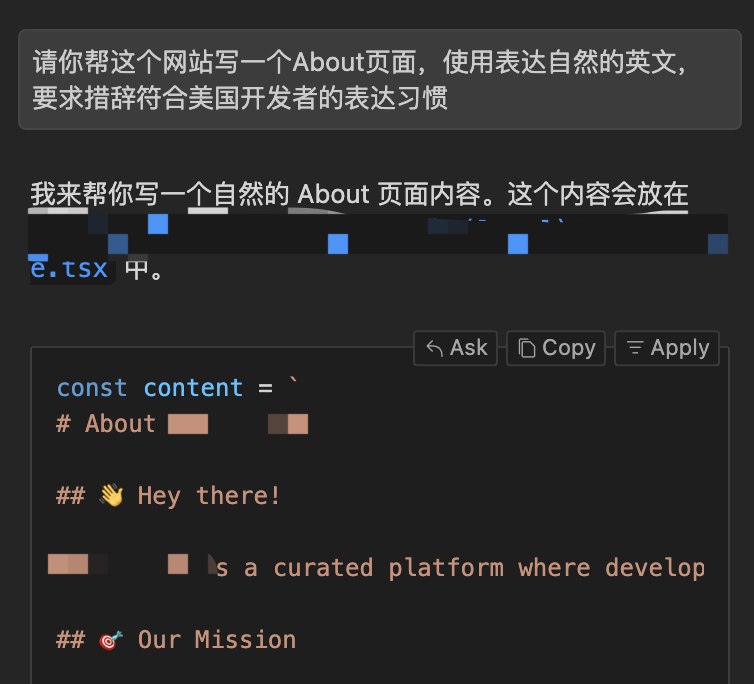
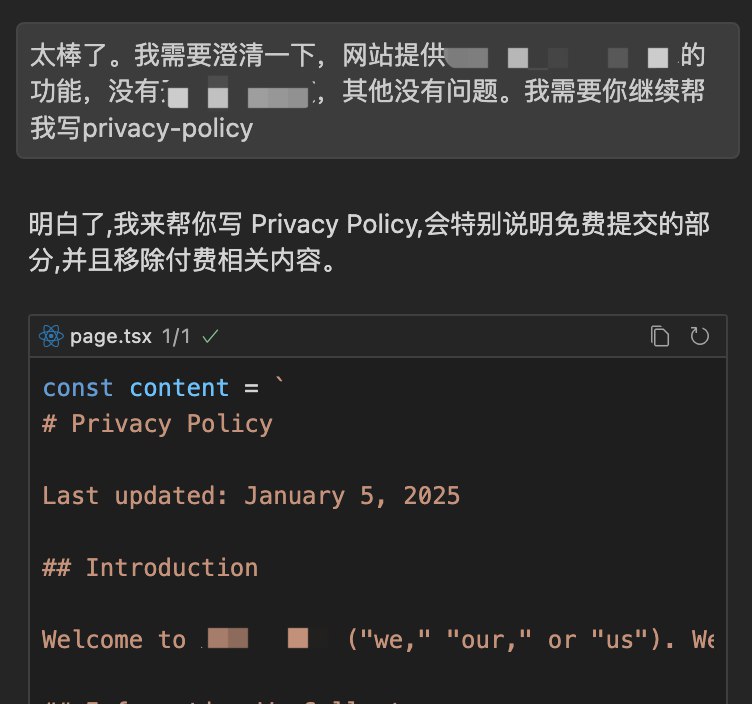
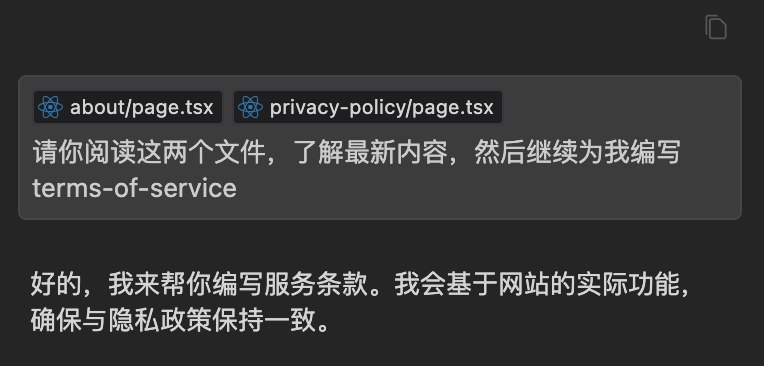
    分享一个快速完成 privacy-policy、terms-of-service 和 about 页面、README 文件的方法。

    以前要写这样的页面,我会给Claude发送网站的详细描述,如果一次描述不完整,就要对话好几轮才能改好。

    现在直接在 Cursor 上面使用 @ codebase 功能,让AI浏览代码,根据代码内容来编写,这样写出来的内容非常精准,省事不少。

    用法一:代码比较简单,像 p1 那样直接让 AI 生成结果;
    用法二:代码量比较大,存在一部分没有实际用到的代码,参考 p2-p5,先让 AI 总结网站功能再开始写,这种情况 AI 会把没用到的代码也考虑进去,所以生成内容可能会有偏差,只需要你澄清一下功能,就能重新生成正确的结果。