AI探索指南

  1. 对话谷歌首席科学家Jeff Dean:AI将成为继PC之后的第二次计算革命,改变人类工作方式

    对话谷歌首席科学家Jeff Dean:AI将成为继PC之后的第二次计算革命,改变人类工作方式

    大多数人有个误区:认为人人都能利用AI,其实不是的。只有本身就很强很有创造力的人才能驾驭AI——很强的人再利用了AI之后会变得超级强。你要能问出一个好问题,AI才能给你更好的结果,今天没有能力和没有创造力的人,其实是无法真正驾驭AI的,根本就“启发”不了AI,也就无法完成人机协作。AI时代人类的贫富分化会超过现在100倍,因为很多人公司就十来个人,但是却拥有几百万个24小时提供服务的AI数字员工。

  2. 机器人系列|③帕西尼CEO许晋诚:机器人只要能帮人干活就行,不一定要追求AGI

    机器人系列|③帕西尼CEO许晋诚:机器人只要能帮人干活就行,不一定要追求AGI

    通篇大实话,实在人,很值得读的一篇报道。

    ✋🏻Key points
    做人形机器人是为了展示触觉传感器的能力;
    数据采集已有两种模式,我们在创造第三种;
    半年造出人形机器人不是问题,传统机器人厂商随时可能加入;
    纯AI太贵了,控制论在机器人领域仍然有市场;
    机器人只要能帮人干活就行,不一定要追求AGI。

  3. 我去,这两天开源生态过年了?

    我去,这两天开源生态过年了?

    Lightricks 开源实时视频生成模型 LTX-Video。

    视频生成速度比观看速度啊还快!!!

    - 只需 4 秒就能生成 5 秒的 24 FPS 视频
    - 具有高度可扩展性,能够生成质量一致的长视频
    - 2B 参数DiT 的视频生成模型

    ComfyUI已经支持,可以冲了朋友们

    模型下载:https://huggingface.co/Lightricks/LTX-Video/blob/main/ltx-video-2b-v0.9.safetensors
    工作流:https://blog.comfy.org/ltxv-day-1-comfyui/

  4. AI探索指南
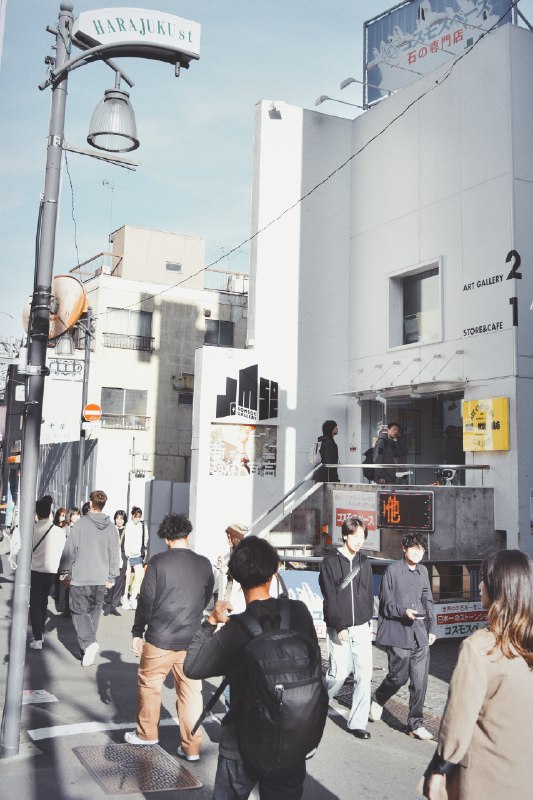
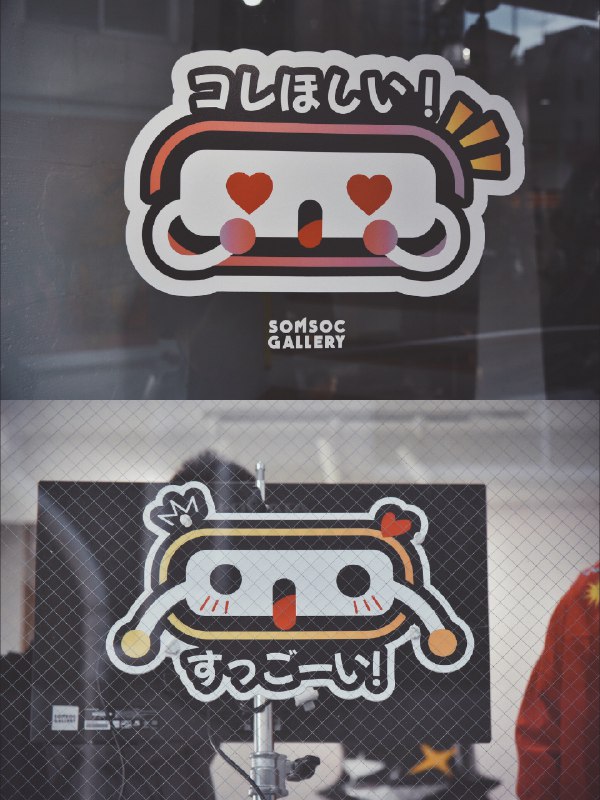
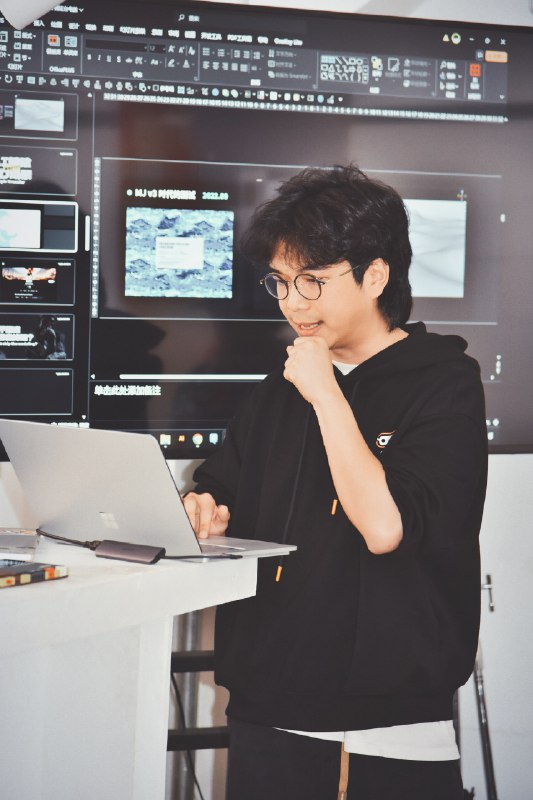
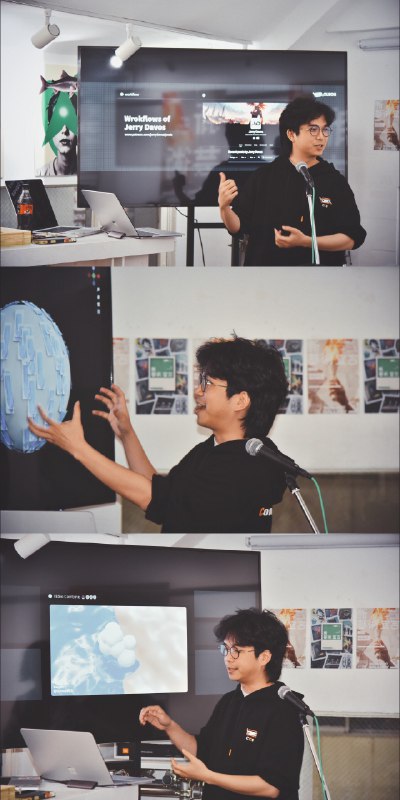
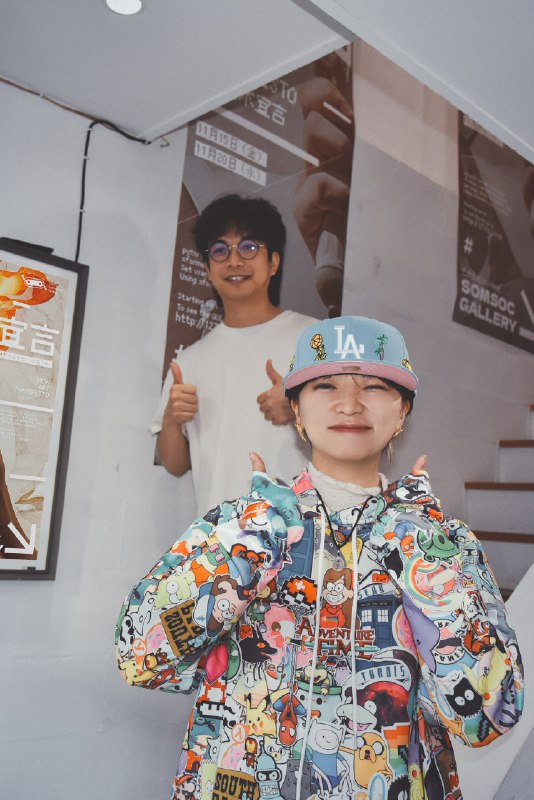
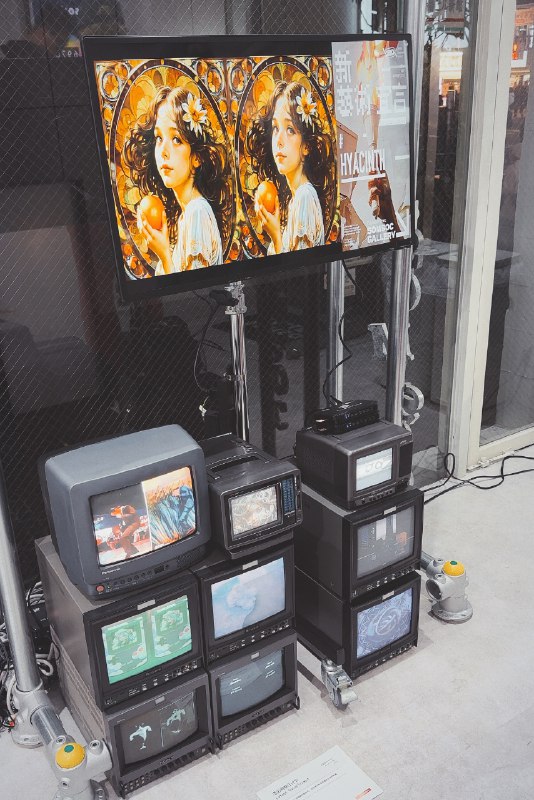
    顺利结束了东京的展览!感谢CCS邀请,能和这么多大佬同台展览&分享,这次真的解锁了超多新体验: ✅ 设计了一场海外展览和峰会的主视觉,特别特别感谢忠忠的远程全力支持,还有屹州全日文无障碍沟通! ✅ 在东京的画廊@SOMSOCGallery 展出了我和@海辛Hyacinth 的作品&工作流; ✅ 在原宿的超大屏上播放了我们的作品; ✅ 甚至在开放麦上做了人生第一次的全英演讲(中间卡壳还好有海佬救场) 期待下一站,CCS牛逼,开源牛逼! #ccs 东京站
    FpU1I5105_W4F6kCT_j4oLXS0J-kv3.jpg
    1.8 MB
    FrvSsevAbtsqkYOEG0ZyE5KzKqhgv3.jpg
    1016.9 KB

  5. 顺利结束了东京的展览!感谢CCS邀请,能和这么多大佬同台展览&分享,这次真的解锁了超多新体验:

    顺利结束了东京的展览!感谢CCS邀请,能和这么多大佬同台展览&分享,这次真的解锁了超多新体验:

    ✅ 设计了一场海外展览和峰会的主视觉,特别特别感谢忠忠的远程全力支持,还有屹州全日文无障碍沟通!

    ✅ 在东京的画廊@SOMSOCGallery 展出了我和@海辛Hyacinth 的作品&工作流;

    ✅ 在原宿的超大屏上播放了我们的作品;

    ✅ 甚至在开放麦上做了人生第一次的全英演讲(中间卡壳还好有海佬救场)

    期待下一站,CCS牛逼,开源牛逼!

    #ccs 东京站

  6. FLUX这下真无敌了!!

    FLUX这下真无敌了!!

    黑森林工作室发布官方的FLUX系列开源工具:

    - FLUX.1 Fill 局部重绘和扩图模型
    - FLUX.1 Depth&Canny 官方Controlnet模型
    - FLUX.1 Redux 通过提示转换图像风格

    Comfyui 现在就已经支持,可以冲了!

    官方公告:https://blackforestlabs.ai/flux-1-tools/
    ComfyUI工作流:https://blog.comfy.org/day-1-support-for-flux-tools-in-comfyui/

  7. Based on the following input: "{input1:风格化插图}", craft the right panel accordingly, it needs to say something along the lines of "showing the same content (Clothing, accessories, facial features, hairstyles, environment, decorations etcetc)". NO INTRODUCTION, ONLY THE PROMPT! Go!

    AI探索指南
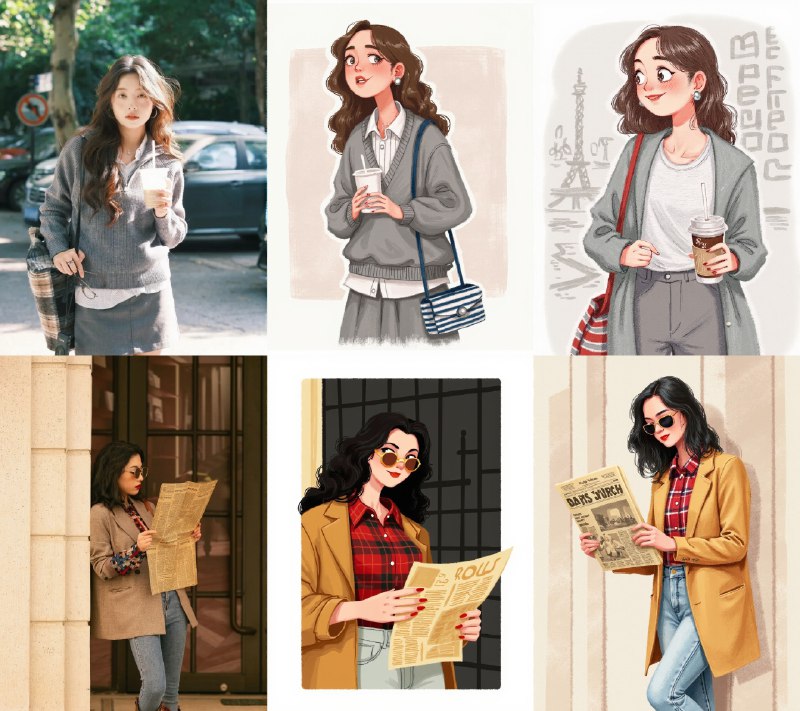
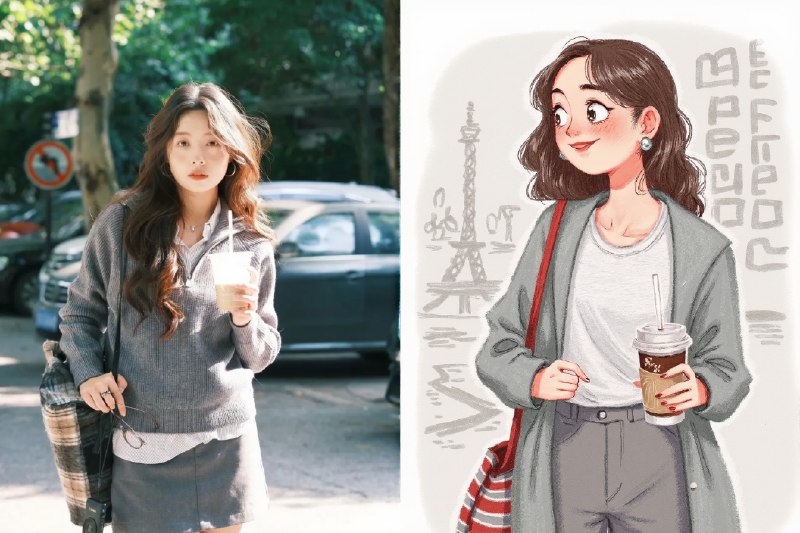
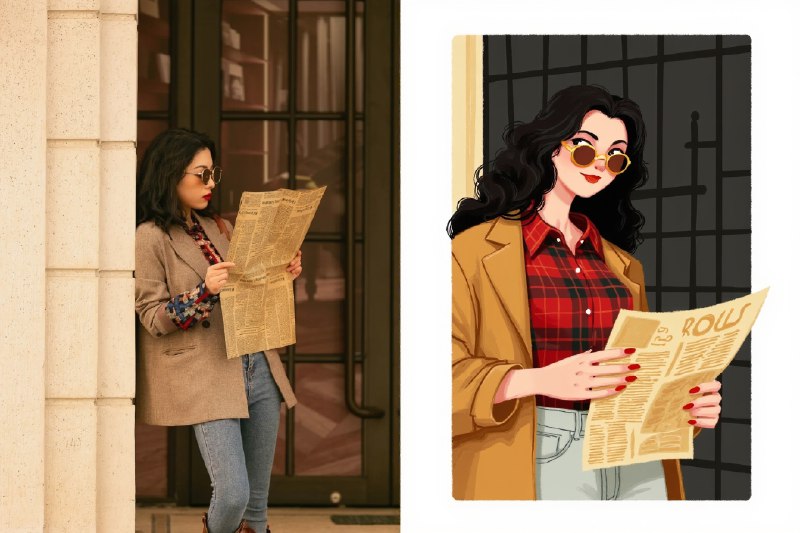
    昨天发的工作流更换成另一个 Lora 就可以做照片风格化! 对于服装和姿势的还原也很好。 有点类似米雷经常拍视频的风格,不过没有她手绘的那么精准和传神。 结合视频可以玩起来了,需要调整的提示词我放下面了。 首先需要下载 In Context Lora 中的 portrait-illustration Lora 。 然后通过这个提示词获取图片描述: 为了帮助一位视障艺术家,我们需要详细描述这幅图像的内容,包括从服装、配饰、面部特征、发型、环境、装饰等各个方面。对于出现在图中的人物,虽然不能提及具…
    Based on the following input: "{input1:风格化插图}", craft the right panel accordingly, it needs to say something along the lines of "showing the same content (Clothing, accessories, facial features, hairstyles, environment, decorations etcetc)". NO INTRODUCTION, ONLY THE PROMPT! Go!

  8. 昨天发的工作流更换成另一个 Lora 就可以做照片风格化!

    昨天发的工作流更换成另一个 Lora 就可以做照片风格化!

    对于服装和姿势的还原也很好。

    有点类似米雷经常拍视频的风格,不过没有她手绘的那么精准和传神。

    结合视频可以玩起来了,需要调整的提示词我放下面了。

    首先需要下载 In Context Lora 中的 portrait-illustration Lora 。

    然后通过这个提示词获取图片描述:

    为了帮助一位视障艺术家,我们需要详细描述这幅图像的内容,包括从服装、配饰、面部特征、发型、环境、装饰等各个方面。对于出现在图中的人物,虽然不能提及具体姓名,但考虑到艺术家的特殊需求,我们需要以匿名方式描述他们的主要特征(切记不要提及真实姓名)。

    通过这个提示词和上面的图片描述获取最终的图像生成提示:

    The following is an example prompt: “The image pair showcases the transformation from reality to a stylized interpretation; [IMAGE1] the photo shows a person with a topknot, wearing a cozy yellow sweater and plaid scarf, standing in front of a shop window, while [IMAGE2] the illustrated version highlights the warm tones, adding playful, oversized shapes and bright hues, creating an animated feel with a soft, inviting background.” Please note that this is only a sample prompt and not intended to be the final output. I want you to create a very similar prompt based on the content and style of: "{style:图片描述}", which will go onto the left panel.