AI探索指南

  1. 脑海中有个概念:信息审美

    脑海中有个概念:信息审美。

    读书时代,随着阅读文字日渐增多,大脑对文字的感知分辨率也在提升,有点像品酒师能尝出各种葡萄酒的细微差别一样,有深厚阅读底蕴的人,也能感知到文字背后的韵味层次。

    信息时代,信息过载,人类(可能)进化出适应信息社会的信息审美能力,每人拥有独属的信息偏好(不一定是离客观真相更近的),这个偏好在某种程度上定义了「我是谁」这个根本性问题。

    AI时代,人类会不会发展出对于AI文本的特殊审美感知能力? 去ai味道,是一种审美, 那会不会有专门欣赏ai 味道的审美? ai生成内容很快,会不会有专门的抵抗派审美,追求慢,追求深度思考? 或者折中派,会不会有混合审美,人的思考结合ai生成,图文并茂,更上一层楼?

  2. 当下的ai,我感觉有两个利基市场,一个往下走,解决ai上手使用的问题(什么是ai,a场景有什么好用的x工具等等)

    当下的ai,我感觉有两个利基市场,一个往下走,解决ai上手使用的问题(什么是ai,a场景有什么好用的x工具等等)。另一个往上走,解决之前人都搞不定(或不好搞)的问题。

    当下ai圈的好多人,恰恰在这两者之间扑腾,既看不到(或看不上)前者的巨大套利时间窗口,也解决不了后者的难度。

    ignoramus.

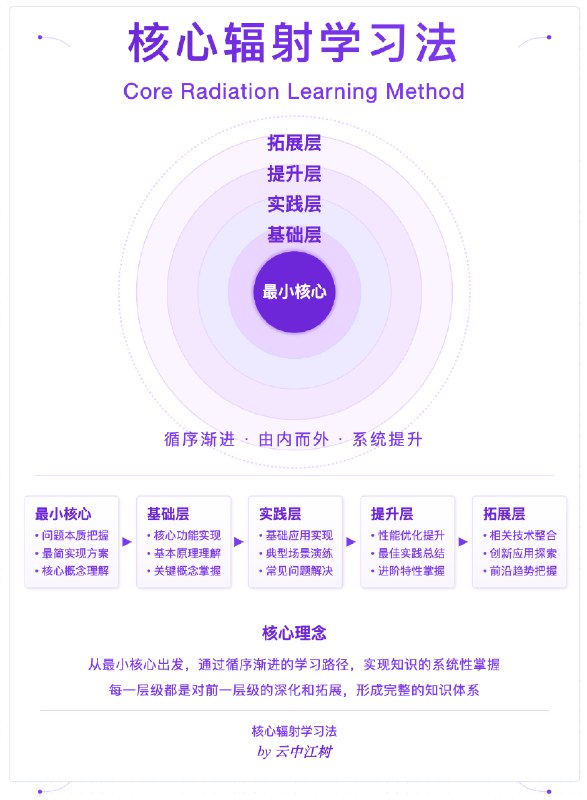
  3. 核心辐射学习法

    核心辐射学习法

    这是我常用的一种学习和思考方法。

    学习一项新知识,新技术的时候。如果直接面对一整个庞大的系统性知识,容易产生畏难心理、记忆负担、认知迷茫等问题,同时容易陷入知其然不知其所以然的地步。

    为了让自己更快更深的理解掌握一项新知识,我会希望尽可能的抛弃掉所有的复杂性,先从最小核心出发,再慢慢掌握基础,然后实践,然后提升,然后拓展。

    以 RAG为例 (个人不专业的回答,欢迎批评指正):

    1. 最小核心: 知识 + 指令 构成的提示词。 最简单的做法就是我们读文献的时候,手动将知识复制粘贴给AI (人工检索知识),然后要求AI 根据知识回答问题。

    2. 基础层。人工检索效率低,所以最小核心的人工检索知识变为机器检索知识。
    知识太多,无法一次输入,所以需要对知识进行分片,于是有了知识切片的各种方法。
    为了检索的准,于是有了关键词检索,语义检索等技术。
    为了进行语义检索,需要将文字转换为向量,所以有了转换的embedding 模型,要对这些向量操作,所以需要向量数据库。
    机器将检索到的知识和指令结合构成提示词,引导模型生成回答。

    3. 实践层。基本上使用上面这些就能构建一个小的rag系统,花时间实验,试错,调优。在优化的过程中发现更多问题,检索不准的问题,生成不理想的问题等等。

    4. 提升层。为了优化检索效果,检索的时候使用各种混合方法,有些问题依赖的知识分布在多段内容中,因此使用多段内容。但是这些内容和问题直接的相关性等又有不同,希望筛选出最相关的,于是有了对检索得到的知识的排序,有了排序模型。为了进一步提升系统效果,使用更好的模型,更好的参数,对生成数据流优化,各个步骤上的参数测试优化等等。

    5. 拓展层。进一步进行系统层面的优化,对系统稳定性,易用性,产品设计等方面优化。比如在实际使用过程中发现很多问题是重复的,这时候就可以构建缓存系统,第一次回答之后下次类似问题进来直接使用缓存的已有答案。

    思考是这个核心辐射的逆过程,不断剔除掉外在的复杂性,观察事物是否成立,最后只保留下最小的不可去除的核心。

    个人按这个思路,Agent 和 RAG 如果不断去除掉复杂性,最终保留到最小核心的话,可以回退到 prompt 的构造法。

  4. 炒两个冷饭

    炒两个冷饭。

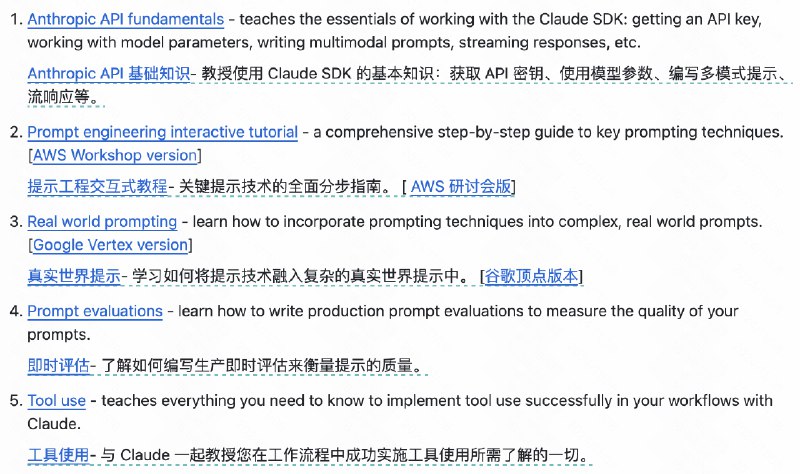
    Anthropic 官方系统教程:包括提示工程交互、真实世界提示和评估;

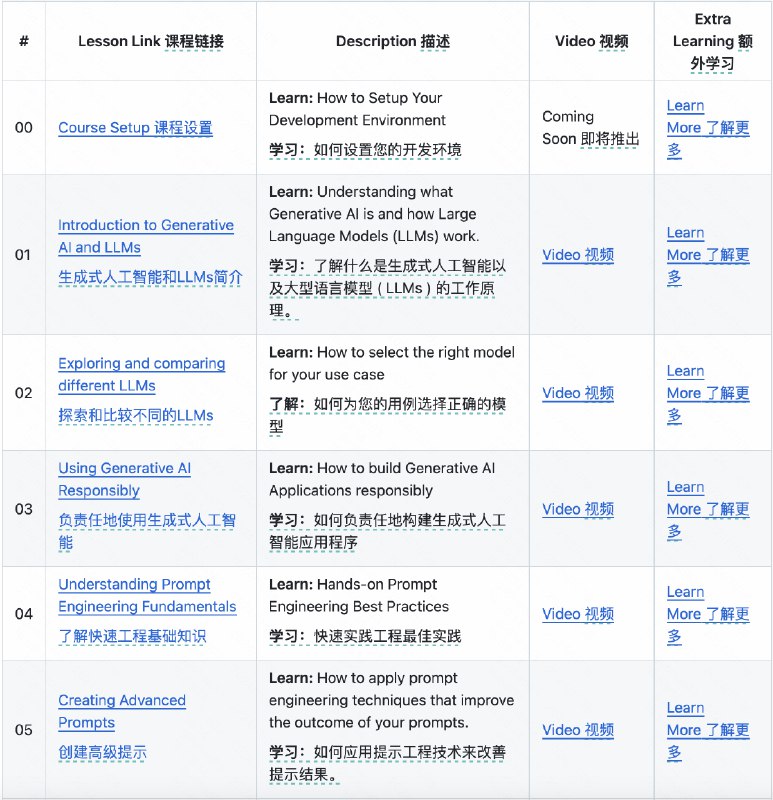
    微软面向初学者的生成式 AI 课程 V3:21 节课程教授开始构建 AI 应用程序所需了解的一切

    微软面向初学者的生成式 AI 课程 V3:
    https://github.com/microsoft/generative-ai-for-beginners

    Anthropic 官方系统教程:https://github.com/anthropics/courses

  5. 🌐 ChatGPT Search vs. Perplexity:突破语言边界的创新

    🌐 ChatGPT Search vs. Perplexity:突破语言边界的创新

    经过一段时间的探索和观察, 发现两者都非常强大,不能说谁完全胜过了谁; 但站在普通用户视角,我意识到ChatGPT Search的易用性、入口性和实用价值体现了其一流产品的水准。

    在截图的简易对比中,Hans 尝试了两者在上下文理解、来源可靠性以及LLM 推理等智能水平。 特别发现有一点,对于中文用户来说具有突破意义:

    「即 ChatGPT Search 的搜索来源不会因为你是中文输入,就只使用中文来源。这点异常关键~」

    综合来说,我之前在Perplexity一直使用英文输入的习惯会被进一步巩固,而ChatGPT Search + Chrome插件的用法,则重塑了一条全新的工作流。 我相信它正在改变新一代年轻用户的使用习惯,这是新开始。

    欢迎分享你的ChatGPT Search使用心得和新发现~#AI的神奇用法
    FurQfZMlIEps3xHbesAHQrB3JM5Gv3.png
    1.1 MB
    lg1WIrzxq7APKAqZ_mn4R9hHsld5v3.png
    4.6 MB
    FoKiZrGyfk1gdT4CbAjzYnZhPlkVv3.png
    1.7 MB
    lg3bQDFPHJ-umJ8MBYQwMz5HanrJv3.png
    4.2 MB

  6. 果然只要是视频,字节就一定会整一个 SOTA 出来

    果然只要是视频,字节就一定会整一个 SOTA 出来。

    发布 X- Portrait2 单图生成面部视频技术。

    效果吊打 Runway,甚至比 HeyGen 还好一点!!

    面部和唇部肌肉非常自然而且生动,真实的有点离谱了。

    妈的,这下 AI 脱口秀视频和对谈视频,还有表演技术彻底成熟了。

    X-Portrait 2技术上的突破是:

    他们构建了一个最先进的表情编码器模型,通过新的端到端自监督训练框架,能够从人像视频中自学习ID无关的运动隐式表征。

    另外通过为模型设计过滤层,编码器能有效过滤运动表征中的ID相关信号,使得即使ID图片与驱动视频中的形象和风格差异较大,模型还可以实现跨ID、跨风格的动作迁移。
    Media is too big
    VIEW IN TELEGRAM