AI探索指南

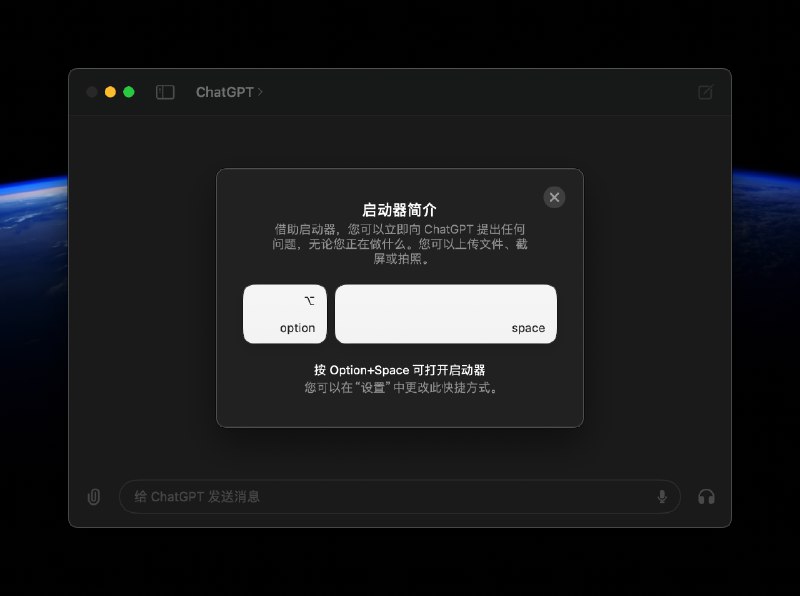
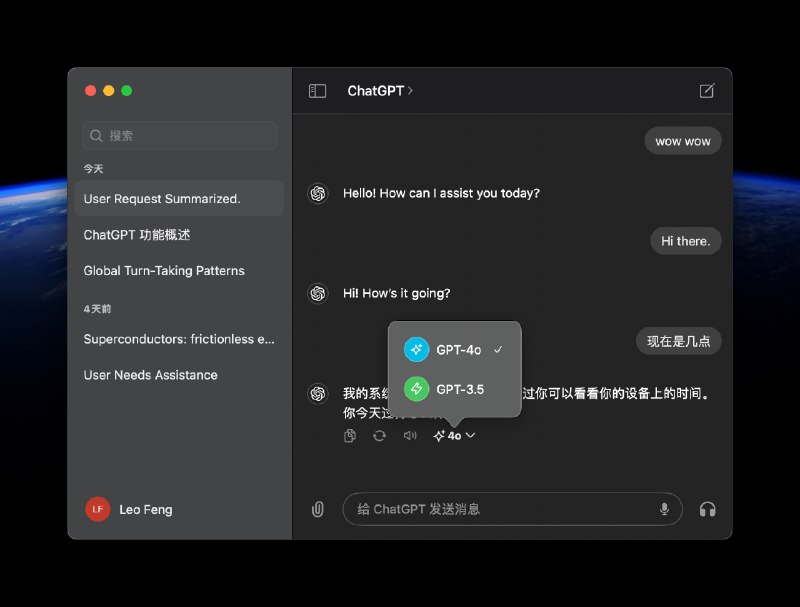
  1. 啊,用上了 ChatGPT 的 Mac 版!

    啊,用上了 ChatGPT 的 Mac 版!
    通过一个简单的骚操作,直接拿到使用权限!
    ---
    1.下载ChatGPT客户端
    https://persistent.oaistatic.com/sidekick/public/ChatGPT_Desktop_public_latest.dmg
    2.登陆账户
    3.在登录成功之后,未出现“无法使用”的提示之前,有大概3秒的菊花
    4.此时快速按下「command + Q」杀死验证程序
    5.重新打开ChatGPT客户端,就可以使用了!

  2. 终于有普通人可以立刻使用的类 Sora 视频生成工具了!#ai视频# #sora#

    终于有普通人可以立刻使用的类 Sora 视频生成工具了!#ai视频# #sora#

    海外产品 viva 发布了首个开放给全部用户使用的 Sora 同架构视频生成模型,而且现阶段免费。

    支持文本生成视频、图片生成视频以及 4K 分辨率放大功能,另外也支持提示词的自动优化。

    文生视频单次可以生成一条 5 秒的视频,图生视频是 4 秒视频

    我测试了一下应该是目前运动幅度最大的视频生成模型,同时图像分辨率也是现在可以用的视频生成产品中最大的。文生视频的效果比图生视频要更好,同时如果要是用的话建议把运动幅度调到 20 左右比较合适。

    viva 优势领域就是可以生成比较好的竖屏视频,目前很多视频模型的演示都是横屏视频,竖屏的表现并不好,但是短视频又是视频内容的大头,所以竖屏视频的生成质量是个很重要的指标。

    但是一致性有一部分测试中保持的不是很好,同时没有表现出 Sora 那样强大的物理特性模拟以及 3D 一致性。跟谷歌 刚发布的 Veo 模型对比来看在写实内容上其实以及差不多了。

    下面是 viva 的视频演示,15 秒开始有相同的提示词跟谷歌刚发布的 Veo 模型的对比。

    这里体验 viva:https://vivago.ai/video?type=1

  3. 最近在总结美国创作者调研分享,分享一些跟AI相关的关键用户认知:

    最近在总结美国创作者调研分享,分享一些跟AI相关的关键用户认知:

    一、效果比效率更重要——对应产品价值
    1. 这也是我过去一年收获的最有价值的一句话,经历很多血泪教训才真正理解
    2. 效果的关键是符合甚至超出用户预期,如果不符合预期,用户就不会完成创作,甚至没有留存。
    3. 不要为了效率而牺牲效果,这是我很容易犯的错误,尤其在漏斗分析的大厂思维下。
    4. AI大模型存在效果不稳定且不可控的问题,一方面通过「雕花」策略来优化给用户交付的结果,另一方面管理用户的预期,比如让用户理解这不是最终结果,而是一个可以继续编辑的草稿。雕花是应用层产品的宿命。

    二、用户又懒又有惯性思维——对应推广方式
    1. 最顺的是在老产品的已有主路径workflow,通过AI提效,用户甚至是无意识使用,渗透相对容易做起来
    2. 但在老产品上独立的新AI workflow能力模块,单纯通过产品策略(强插、增加入口、红点)的导流有限,用户很难注意到,也不愿意为一个不确定的结果而付出额外的上手成本
    3. 可能就需要运营和推广手段,做用户认知教育,甚至一个好的demo视频都比产品策略有效。好的内容有随机性,但也是最大的杠杆。
    4. 在字节,最有效的是抖音锚点;在腾讯,最有效的手段是微信QQ红点;它们过于成功,也导致我们过于依赖。如果我们做的产品在这个路径增长逻辑不那么成立,那么我们的方法论,经验,甚至能力模型,都很难支撑我们去推广新产品

    三、用户为刚需付费——对应付费模式
    1. 工具类产品,用户的决策是理性的,所以更多为刚需付费,而较难为冲动付费
    2. 服务偶发性刚需,比如母亲节这天,用户会为母亲节模板单次付费;
    3. 服务持续性刚需,比如通过AI能力帮助制作创作者Tiktok/Ins账号的主营内容,例如美妆博主的美妆vlog,帮助他们持续涨粉赚钱,用户会更愿意订阅付费;
    4. 目前AI创业更适合,服务少数人的持续性刚需,而不是服务大众的偶发性刚需
    4. 用户已被市场教育AI需要付费,所以强化透传AI,可以提高用户付费意愿度

  4. 我以前以为,实现小学生作文里写的,让机器人买菜做饭,是需要机器人有类似人的自主意识才能实现,而让机器有自主意识,可能需要用到通用量子计算机

    我以前以为,实现小学生作文里写的,让机器人买菜做饭,是需要机器人有类似人的自主意识才能实现,而让机器有自主意识,可能需要用到通用量子计算机。现在再看,随着技术发展,也许机器人不需要有自主意识也能执行复杂任务。
    一般来说,发指令让机器人把桌上A点的一瓶水,拿起来并放到B点,是相对容易的,只需给机器人编程,设定好坐标、姿态和抓取指令即可。
    但是如果你对机器人说,帮我去超市买两斤黄瓜回来,这个难度就相当大了,尽管这个任务只需要花5块钱就会有一个人类外卖员帮你实现。
    让机器人去超市买两斤黄瓜,涉及到大量感知、决策和执行过程。
    打个比方,怎么让机器人开门。
    机器人开门实现起来就比较复杂,研究机器人开门的文章很多。
    机器人得认识门把手,得知道门把手的精确位置,得学习从哪个姿态抓成功率更高,得有合适的控制方法避免把门把手或者把自己的手指拧断了。
    得用到机器视觉,得研究机器人运动学、动力学,得上深度学习,还得研究各种信号滤波和控制优化方法。
    我对机器人只了解一点皮毛,这是我能想到的,实际研究的人可能会遇到更多问题。
    想象一下,你所在的团队花了几年时间,成功让机器人学会了拧开各种一字形门把手,并发了很多文章。但是机器人下楼后发现,楼下有个肯德基餐厅同款的门把手。见此情景,你领导心中窃喜,又可以搞到一笔经费,并发好几篇文章。