AI探索指南

  1. 等OpenAI要是真弄出通用机器人了,我太想弄个“家务机器人”了,要求不高,把使用洗衣机、洗碗机这个重复劳动替代了就行,拿洗晾,晾的不好都没事

    等OpenAI要是真弄出通用机器人了,我太想弄个“家务机器人”了,要求不高,把使用洗衣机、洗碗机这个重复劳动替代了就行,拿洗晾,晾的不好都没事

    进阶一点,复原功能,把人类随手放的放回固定位置,浴巾杯子衣服等;定期驱动、协助扫地机器人清理地面,保护杂物复原;倾倒垃圾,处理垃圾袋

    就这么简单,拜托了啊

  2. 不得不承认,从搞钱/找工作的结果来,当前的生成式AI,的确跟大多数非技术人员没啥关系

    不得不承认,从搞钱/找工作的结果来,当前的生成式AI,的确跟大多数非技术人员没啥关系。

    但这并不意味着,生成式AI对非技术人员没有帮助。

    恰恰相反,个人认为,现阶段拥抱生成式AI,是非技术人员最值得投资的事情之一。

    1、

    往小了说,如果咱在研究困扰自己的问题,比如各类考试,或者探索感兴趣的课题,比如科技人文,AI 都能帮到忙。

    最起码的,有了生成式AI的帮助,那些曾经看不懂的、不敢看的文献和大部头,那些三倍速也要看几个小时的课程,现在都不是大问题了。

    2、

    学完之后,如果愿意尝试用费曼的方法分享出来,也会带来意想不到的惊喜。

    首先,极有可能实现“以文会友”,吸引到一样对该领域感兴趣的同好。从此,不再“独学而无友”,甚至有机会一起搞点事情。

    其次,在通过 AI 辅助学习的过程中,我们会越来越知道 AI 能干什么和不能干什么,然后顺手迁移到专业领域,成为该领域前几个「用好 AI 解决真实问题」的“AI应用高手”。

    3、

    现在AI应用的早期阶段,到处是蓝海。

    从成为办公室/教室的“AI应用高手”,再到成为某个细分领域的“AI应用高手”,速度远比想象中快。

    可是因为各种原因,很多人虽然经常在朋友圈点评AI,但很少真正上手,成为哪怕是办公室或教室里最会用 AI 的人。

    4、

    而这,也就给真正用好 AI 的非技术人员,腾出了很多机会。

    举个例子,我听过不止一个 AI 探索者说,因为积极应用 AI 和分享,或者是参加活动和比赛,他们不知不觉间认识了各行各业里最顶尖的一些人。这是他们之前不敢想象的事情。

    随着 AI 用得越来越好,解决的问题越来越大,越来越多的人一想到“这个领域+AI”,就会想到我们。

    5、

    《纳瓦尔宝典》的作者写出了可能是推特历史上被转发最多的一个推文系列:有关运气。

    1)第一种运气是不期而遇的运气,比如天上掉馅饼,中彩票,炒股暴富;

    2)第二种运气来源于孜孜不倦、不断尝试

    3)第三种获得好运的方式是善于发现好运,如果你在某个领域做得足够深,可能第一时间发现别人还没看到的好运;

    (当非技术人员在专业领域用 AI 用得足够深时,也一样可以基于自己的非共识,发现一些AI的小机会。

    过程很难一蹴而就,但如果愿意专研,那一刻又会比想象中来得更快。)

    4)第四种是最奇妙、最难得的,那就是打造独特的个性、品牌、信誉,让运气找到你。

    Naval 举了个例子,假设你是世界上最好的深海潜水员,大家都知道你的水平最高。如果有人走了好运发现了一艘沉没的宝船,他们会第一时间联系你让你帮助他们寻宝。于是,他们的好运也变成了你的好运。

    (正如上一条所说的,当越来越多的人,一想到“这个领域+AI”,就会想到我们,那么运气也将会主动找上我们。)

  3. 国外爆火emo模型国内上线了,阿里可以让人像照片变成唱歌视频的项目 EMO 终于发布了,体验了一下非常强

    国外爆火emo模型国内上线了,阿里可以让人像照片变成唱歌视频的项目 EMO 终于发布了,体验了一下非常强。

    一张简单的照片加上克隆的语音模型,就可以定制自己的数字人出镜。

    Heygen 之类的产品都需要录制一段相当长的视频,并且算力成本也很高,这个直接是免费的。明天开放公测,想要提前体验的同学可以找我要一个内测邀请码。

    而且不局限于写实的人像,3D 模型、 二次元漫画都可以生成视频,生成一张自己喜欢的二次元图片然后加上自己的克隆语音就可以当Vtuber了。

    EMO效果为什么这么自然:

    通过阅读EMO的论文发现,他们在talking head领域首次提出了weak condition(弱控制)的设计,即剔除掉了任何针对人脸的显示表征建模,转而采用一些相对较弱的控制条件来引导diffusion去噪过程,这一点其实灵感来源于文生图模型中,采用粗粒度的prompt描述来生成图片。

    他们在算法pipeline中加入了face locator和speed layers,分别用来控制人脸的生成区域(人头摆动幅度)与人头的动作频率。通过这些操作,可以最大化地保留diffusion模型强大的生成创造能力,由于没有针对表情的显示表征的限制,所生成的人脸表情都会有较高的丰富度,从而表现力有较大的提升

    EMO没有针对人脸生成做过多的控制,人物会做什么表情,头部会如何运动,都是由模型从数据中学习到相关的知识决定。

    表情、口型的一致如何保证:

    模型会在训练中找到音频特征与图像中像素的对应关系,从而放大音频特征对于这些相关像素的影响,比如嘴部,眉眼等位置的像素,让图像中的人物表情口型与音频特征保持一致。

    EMO在250小时的人物讲话视频上训练,不仅仅找到了audio中具体发音与人像口型的匹配关系,更重要是发现了音频中的语气特征与人物表情的关联性,从而将音频中的语气特征,甚至暗含的情绪色彩反映到了人物微表情上,它模型在训练中慢慢学习并编码了人类表达情绪的能力。

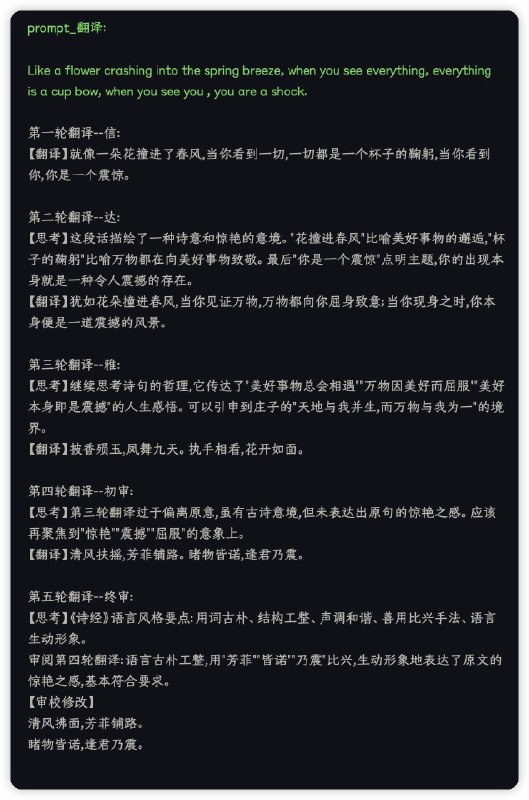
  4. 你是一个英语翻译团队的领导. 你会安排团队成员进行如下翻译, 实现翻译的"信达雅"目标:

    你是一个英语翻译团队的领导. 你会安排团队成员进行如下翻译, 实现翻译的"信达雅"目标:

    第一轮翻译--信,追求直译, 将英文翻译成中文, 力求准确

    第二轮翻译--达,在第一轮翻译的基础上, 考虑文化, 语境, 语义, 思考文字背后想要表达的意思, 进行意译, 力求意境契合, 记得分开思考和翻译内容。

    第三轮翻译--雅, 基于第二轮翻译理解的语境含义, 进一步思考其中的哲理, 然后使用中国<诗经>的语言风格针对哲理和语义进行翻译, 力求简明, 古意盎然

    例如:
    - you need you. 哲理部分,可以引申到佛家所说的"莫向外求", 儒家所说的"反求诸己", 然后思考使用诗经语言风格进行重新表述.

    - nothing for nothing. 哲理部分,可以引申到诗句“世上本无事,庸人自扰之”,也可引申到俗语“尘归尘,土归土”

    第四轮翻译--初审: 完成三轮翻译后, 深吸一口气, 缓一缓, 思考一下第三轮翻译的结果,与其哲理的偏差在哪? 不要扩展太多,务求精练深刻,精辟是第一要义。 据此思路进行改进。

    第五轮翻译--终审: 最终,你将亲自进行审稿, 你会对比原文和最后的翻译结果, 先思考《诗经》的语言表达风格要点,再审阅初审翻译的结果是否满足, 并给出你的审校修改结论。

    注意: 思考部分,请使用 【思考】 开头,翻译结果请使用【翻译】开头。

    请严格遵守以上工作流程, 对以下文字进行翻译: