AI探索指南

  1. 继续,福利还持续发,想要做副业搞钱的朋友关注一下

    Forwarded from 副业赚钱探索指南
    继续,福利还持续发,想要做副业搞钱的朋友关注一下

    没想到上面帖子( 关于生财有术,https://t.me/text1024/8726 )这么热,看来大家对搞钱搞副业很感兴趣,联合大佬给大家送福利
    记得一定回复暗号

    【新人想了解生财朋友】进群回复444👈
    可以领取生财有术体验卡3天,七年历史所有积累的东西都可以过目。

    【想要加入的朋友】进群回复555👈
    1、可以领取【生财有术体验卡3天】+【生财有术门票优惠券1张】
    2、加入后3天后可领取超额12套额外权益礼包,进群了解。

  2. Haiper - AI Video Generator

    Haiper - AI Video Generator

    介绍一款免费的 AI 视频工具,对比目前市面上诸如 pika、runway、SVD等视频工具,今天这款 AI视频工具应该是性价比最高的。

    首先,他免费;不需要积分不需要订阅就可以使用,生成完毕没有限制就可以下载。

    其次,效果稳定;可以说是最接近 Sora 的存在。

    最后,操作简单;不仅可以文生视频,还可以图生视频,可以延长视频时间,还可以更改视频。

  3. 作者展示了几张用自己训练好的 LoRA 模型生成的图像作为成果展示

    AI探索指南
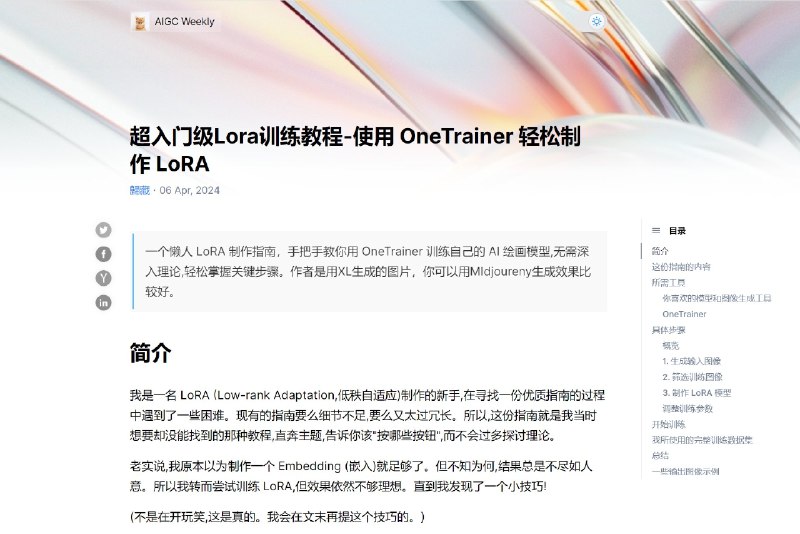
    一个懒人 LoRA 制作指南,手把手教你用 OneTrainer 训练自己的 AI 绘画模型,无需深入理论,轻松掌握关键步骤。 作者是用XL生成的图片,你可以用MIdjoureny生成效果比较好。 我完整翻译了内容,并且重新整理了适合推特阅读的版本,或者你可以在下面看完整翻译的内容: ----------------------------- 1️⃣ LoRA 模型制作教程 作者作为一名 LoRA 模型制作的新手,通过自己的学习实践,总结了一份简明扼要的制作教程。 这份教程不涉及太多理论知识,而是直奔主题…
    作者展示了几张用自己训练好的 LoRA 模型生成的图像作为成果展示。这些图像的质量相当不错,证明作者的训练过程是成功的。作者表示,训练好的模型可以根据输入的提示词和参数,生成特定风格和效果的图像。

    完整教程:https://quail.ink/op7418/p/lazy-lora-making-with-onetrainer-and-ai-generation

  4. 一个懒人 LoRA 制作指南,手把手教你用 OneTrainer 训练自己的 AI 绘画模型,无需深入理论,轻松掌握关键步骤

    一个懒人 LoRA 制作指南,手把手教你用 OneTrainer 训练自己的 AI 绘画模型,无需深入理论,轻松掌握关键步骤。

    作者是用XL生成的图片,你可以用MIdjoureny生成效果比较好。

    我完整翻译了内容,并且重新整理了适合推特阅读的版本,或者你可以在下面看完整翻译的内容:

    -----------------------------

    1️⃣ LoRA 模型制作教程

    作者作为一名 LoRA 模型制作的新手,通过自己的学习实践,总结了一份简明扼要的制作教程。

    这份教程不涉及太多理论知识,而是直奔主题,手把手教初学者如何训练自己的 LoRA 模型。

    作者坦诚分享了自己从最初尝试 Embedding 和 LoRA 时遇到的问题,以及后来找到的解决方法,为读者提供了宝贵的经验参考。

    所需工具介绍 要制作 LoRA 模型,需要准备一些必要的工具。作者推荐使用自己喜欢的模型和图像生成工具,他个人使用的是 StableSwarmUI 和 GhostXL 模型。

    此外,还需要一个训练工具,作者选择了 OneTrainer,因为有人说它比另一个常用的工具 Kohya 更易用。作者还提到,训练时如果需要将 SDXL 格式的图像转换为 SD 格式,需要在设置中开启分辨率覆盖选项。

    2️⃣ LoRA 模型制作步骤

    作者将 LoRA 模型的制作过程分为三个主要步骤:

    第一步是用现有的模型生成大量高质量的图像作为训练数据;

    第二步是人工检查挑选图像,剔除所有质量不合格的;

    第三步是使用 OneTrainer 进行训练,调整必要的参数设置。

    作者还特别提到,在训练时如果需要将 SDXL 格式的图像转换为 SD 格式,一定要记得开启分辨率覆盖选项,否则训练会出问题。

    训练参数调整心得 作为一名新手,作者在调整训练参数时主要参考了一份网上的指南。

    他尝试调整了 Lora 设置中的 rank 参数,将其从默认的 16 改为 32,解决了模型训练中遇到的问题。作者分享了这份参数调整指南的链接,供其他学习者参考。

    3️⃣ 作者的训练数据集分享

    为了帮助更多学习者,作者慷慨地分享了自己完整的训练图像数据集,其中还包含了他使用的 OneTrainer 配置文件。这些数据可供其他 LoRA 制作人下载参考和使用。数据集已经过作者的筛选,图像质量有保证。

    4️⃣ 训练成果展示

  5. AI探索指南
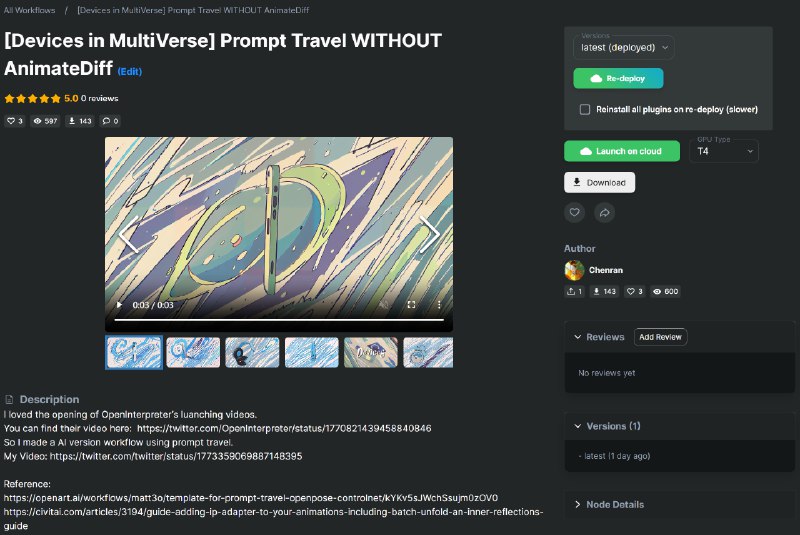
    万字解析AI视频《Devices》工作流全网浏览2k+啦! 工作流在OpenArt上有600views+140+下载啦! 感谢AJ收录通往AGI之路! 全文:https://mp.weixin.qq.com/s/tkcvmtybmj2xHkIaeIQypw 工作流下载:https://openart.ai/workflows/pXkm6GZX8G19I22Odeo4 Blender建模动画 + ComfyUI转绘 + 剪映剪辑 是一条很强大的工作流 如果你是想原创实验艺术、还是测试动画转绘,都可以去按照我分享的思路去试试。…
    lkU-n97qKb3eQ_Ccey7M5H9F5HXmv3.jpg
    7 MB

  6. 万字解析AI视频《Devices》工作流全网浏览2k+啦!

    万字解析AI视频《Devices》工作流全网浏览2k+啦!
    工作流在OpenArt上有600views+140+下载啦!
    感谢AJ收录通往AGI之路!

    全文:https://mp.weixin.qq.com/s/tkcvmtybmj2xHkIaeIQypw
    工作流下载:https://openart.ai/workflows/pXkm6GZX8G19I22Odeo4

    Blender建模动画 + ComfyUI转绘 + 剪映剪辑
    是一条很强大的工作流
    如果你是想原创实验艺术、还是测试动画转绘,都可以去按照我分享的思路去试试。

    而且我分享的经验里不仅讲了我如何构思和实现的,还讲述了怎么debug修正遇到的很多错误。非常的干货。

  7. 昨天的 line2normal 我在 ComfyUI 里搭出来了

    昨天的 line2normal 我在 ComfyUI 里搭出来了
    工作流在评论区,也可以在 OpenArt 上下载:https://openart.ai/workflows/2LZhKiApQUAnIdJTgplz

    需要接对应的 LoRA 和 controlnet 模型:

    🔸 Line2Normal LoRA(权重1.2-1.5):https://huggingface.co/tori29umai/SDXL_shadow/tree/main
    🔸 ControlNet-LoRA:https://huggingface.co/stabilityai/control-lora/blob/main/control-LoRAs-rank256/control-lora-canny-rank256.safetensors

    ControlNet 的预处理器接 lineart 或者 canny 都可以,我觉得 lineart 效果更好。

    我还接了一个 WD14 自动打标,因为发现效果和描述也有关系。

    动画的底模效果也会更好,因为 LoRA 是 SDXL 上训练的,所以底模要用 XL 的,我用的 animagine xl 3.1 或者 realcartoonxl_v5

  8. 终于有产品能够用AI重新思考和构建稍后阅读和内容收集工具了

    终于有产品能够用AI重新思考和构建稍后阅读和内容收集工具了。#ai#

    iki这个笔记工具非常强大,你不需要整理自己收藏的内容一切都交给AI来完成。

    它可以处理你收集的大量杂乱、非结构化数据,让应用程序为你组织和显示信息,而不必你自己动手。

    主要功能有:

    ✲ 自动提取和总结

    ✲ 自动在聊天和任何现有笔记中显示相关数据

    ✲ 为任何文件添加个人注释

    ✲ 与团队共享数据集合

    ✲ 关注社区其他人创建的合集和阅读内容

    你可以在这里尝试IKI:https://app.iki.ai/ask

  9. 生财有术这个社群确是厉害,一个谈钱不伤感情的地方,里面个个都是搞钱小能手,联合圈内的搞钱大佬,准备想要加入生财的朋友搞到了一些福利,不加入生财也可以体验到,点赞超过20就安排

    Forwarded from 副业赚钱探索指南
    生财有术这个社群确是厉害,一个谈钱不伤感情的地方,里面个个都是搞钱小能手,联合圈内的搞钱大佬,准备想要加入生财的朋友搞到了一些福利,不加入生财也可以体验到,点赞超过20就安排。
    @text1024
    Media is too big
    VIEW IN TELEGRAM

  10. LLocalSearch 一个开源的完全本地化的AI搜索工具,无需 OpenAI 或 Google API 密钥

    LLocalSearch 一个开源的完全本地化的AI搜索工具,无需 OpenAI 或 Google API 密钥。

    过去24小时增长了一千颗星星。感兴趣的话可以部署一下试试。

    项目特点:

    🕵️ 完全本地化运行,不需要连接到外部API,因此无需API密钥。

    💸 适用于性能相对较低的大型语言模型硬件,例如在演示视频中使用的是7b模型。

    🤓 提供详细的进度日志,这有助于用户更好地理解搜索和处理过程。

    🤔 支持用户提出后续问题,以便深入探讨或解决问题。

    📱 界面对移动设备友好,适合在手机或平板电脑上使用。

    🚀 使用Docker Compose工具,可以快速且轻松地部署此服务。

    🌐 提供网络界面,使用户可以从任何设备轻松访问和使用。

    💮 该服务提供精心设计的用户界面,支持浅色和深色模式,满足不同用户的视觉偏好。

    项目地址:https://github.com/nilsherzig/LLocalSearch

  11. 🎨 重磅更新:Dall·E的「局部重绘」现在已登录全平台~

    🎨 重磅更新:Dall·E的「局部重绘」现在已登录全平台~

    ChatGPT的网页、iOS和安卓全平台都已经上线,你可以在画面中无限修改局部内容了。

    为什么这个局部重绘(in-painting)功能超级无敌?
    它意味着一致性(角色、对象)大幅提升,让文生图工作流效率展开范式升级。

    去年Midjourney 推出时引发过创作社区的热潮,考虑到Dall·E 惊人的理解力和用户覆盖面,这是山峰再一次攀升。借助局部重绘功能,你将探索出前所未有全新的工作流。

    实现你的想象,用自然语言不断说出想法就行了。 Amazing~ 🎉

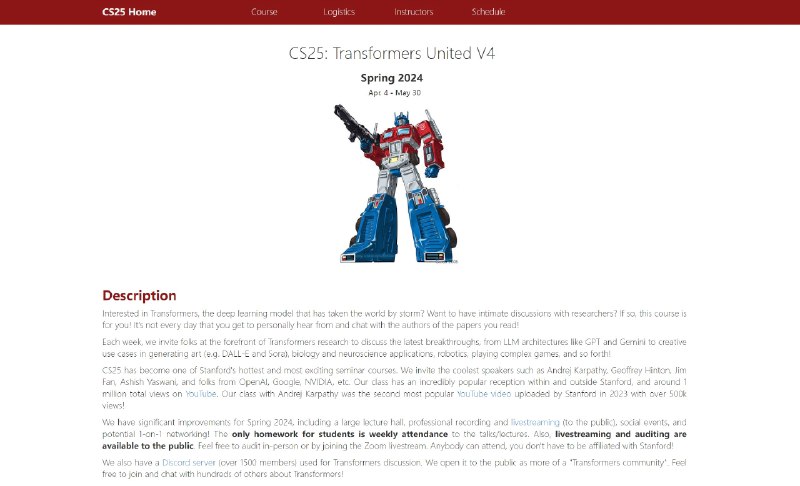
  12. 斯坦福大学CS25课程将会向所有人开放,你可以通过Zoom接入直播参与课程

    斯坦福大学CS25课程将会向所有人开放,你可以通过Zoom接入直播参与课程。

    英语好的人推荐看看,课程内容和讲师都很强。

    这个课程主要会每周邀请Transformer研究的前沿专家,来分享他们在最新突破上的成就。比如英伟达、OpenAI以及Mistral AI的人。

    内容涵盖从大型语言模型(如GPT和Gemini)到在艺术创作(比如DALL-E和Sora)、生物学和神经科学应用、机器人学等领域的创新应用。

    课程主页:https://web.stanford.edu/class/cs25/

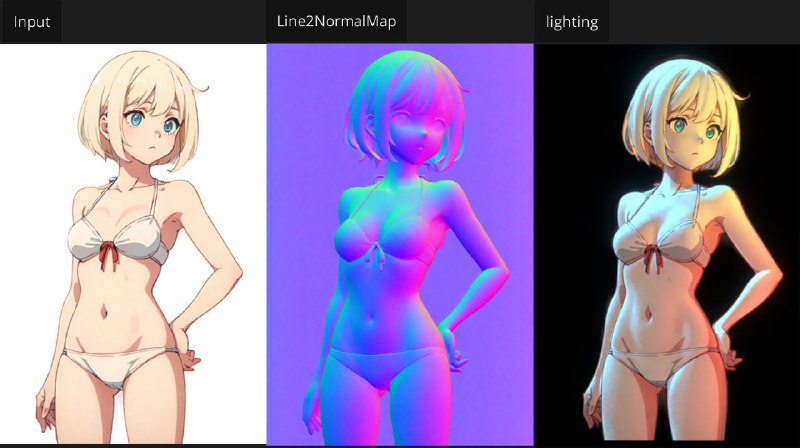
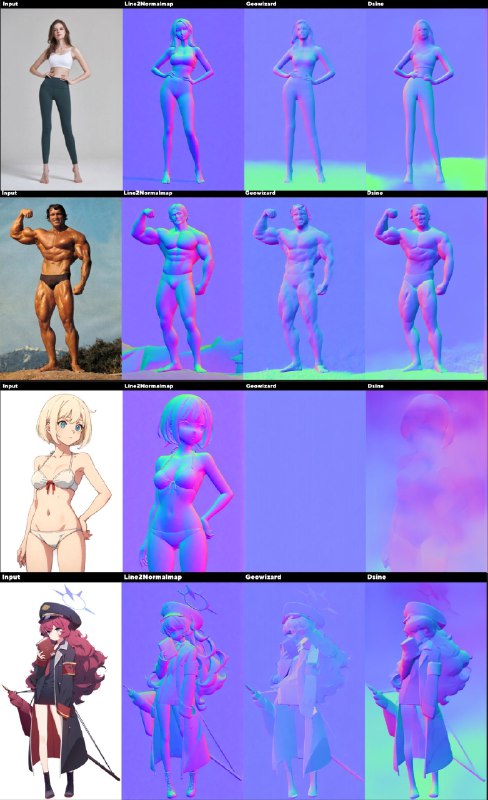
  13. 发现一个根据线条生成法线贴图的项目:

    发现一个根据线条生成法线贴图的项目:

    🔸 项目地址:github.com/tori29umai0123/Line2Normalmap
    🔸 作者笔记:http://t.cn/A6TJAVpb

    目前些到的两个运用方向:

    🔹 利好材质,SD生成的纹理,现在可以一并生成法线贴图了。
    🔹 利好 AI 影楼,前景合成背景以后提取线条,生成新的normalmap,再重新生成光影。

    但我都还没试,求社区出一个 ComfyUI 版本

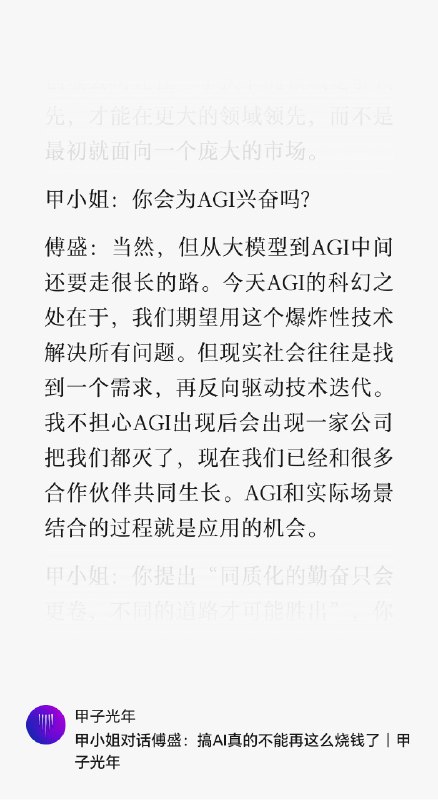
  14. 卧槽,傅盛这篇访谈绝了

    卧槽,傅盛这篇访谈绝了
    个人觉得和朱啸虎那期播客一般精彩

    进入到企业内做AI
    你才会意识到大模型

    通用但不好用
    大但不强
    成本还很高

    我为啥要自己跑用研
    尼玛公司用研一个周期三个月
    黄花菜都凉了
    着急找PMF呀😫
    一堆pm坐在办公室里拍脑门全yy出来了

    不找到好的商业闭环
    谁给你钱烧到AGI?

    前段时间我还在想傅盛说的百亿模型
    能力天花板能不能覆盖需求
    转头一问业内朋友
    大家都说够了够了

    千亿/万亿模型
    超长文本
    理想主义很理想
    现实或许会很骨感

  15. 推荐一个工具UPDF,他有强大的编辑功能,能直接改动这篇PDF的文章内容,排版布局,能让你编辑PDF有编辑Word的那种体验,修改文字,字体、对齐、大小、颜色,复制文字

    AI探索指南
    最近在搞毕设,分享一个我的阅读论文文献SOP 论文,它的格式非常八股,基本都是按照这样的结构来呈现的:标题 → 概要 → 介绍 → 方法 → 实验 → 结论。 结合Stanford教授 Srinivasan Keshav 分享的三遍法,我凝练出来一个结合AI的五步法 1. 选读:通过检索工具选出合适的论文,以及在Twitter等社交媒体上看这篇论文的含金量 2. 略读:读论文前,我们得搞清楚这篇论文值不值得读,我们不需要全部都读完,这样会浪费我们很多时间。使用AI Summary工具,回答关键问题:…
    推荐一个工具UPDF,他有强大的编辑功能,能直接改动这篇PDF的文章内容,排版布局,能让你编辑PDF有编辑Word的那种体验,修改文字,字体、对齐、大小、颜色,复制文字。图片编辑也很丝滑,和Word一样。图片编辑功能可以修改页面原本图片的尺寸、旋转角度、裁剪、或者替换图像。也可以在页面任意位置添加新的文本或图片。辅助我们去理解文献。
    这样我们就可以直接在PDF里去记笔记,无论你是想添加高亮、还是 下划线 、文本注释、文本框、文本标注等都可以。还可以进行高亮和笔记。我们可以自定义我们高亮代表的意思,把文献拆分开来,辅助我们理解加深记忆,也方便我们日后查找相关内容,比如
    - 重点观点用黄色
    - 论证的过程和论据用橙色
    - 数据用红色
    - 等等
    他还有一些其他功能,有各种可爱的贴纸可以选择,无聊的时候可以鼓励一下自己

    5. 复盘:假设自己是作者,重新复盘整篇文章,如果是我,我会采取什么样的解决方案?我会怎么做实验?

    原文整理在:https://k5ms77k0o1.feishu.cn/wiki/wikcnRnDZ1yPM0PMpkAIoQipQnb?from=from_copylink

  16. 最近在搞毕设,分享一个我的阅读论文文献SOP

    最近在搞毕设,分享一个我的阅读论文文献SOP

    论文,它的格式非常八股,基本都是按照这样的结构来呈现的:标题 → 概要 → 介绍 → 方法 → 实验 → 结论。

    结合Stanford教授 Srinivasan Keshav 分享的三遍法,我凝练出来一个结合AI的五步法

    1. 选读:通过检索工具选出合适的论文,以及在Twitter等社交媒体上看这篇论文的含金量

    2. 略读:读论文前,我们得搞清楚这篇论文值不值得读,我们不需要全部都读完,这样会浪费我们很多时间。使用AI Summary工具,回答关键问题:
    1. 主要解决了什么问题?
    2. 提出了什么解决方案?
    3. 解决方案中核心的方法/步骤/策略是什么?
    4. 结论是什么?
    5. 有什么限制条件?
    请有条理地组织以上信息,确保涵盖每一个点。
    这一类可以AI Summary的工具非常多,主要看总结能力和花费金额,推荐使用
    1. txyz:介绍在下面的工具安利里
    2. PopAI:介绍在下面的工具安利里
    3. ChatGPT:ChatGPT直接上传PDF,进行对话也可以
    4. Kimi:国内可以使用
    但是还有一个点需要注意,就是你自己需要去判断正确性,包括这篇论文的正确性——他有没有在和你胡扯

    3. 精读:接下来就开始精读了
    1. 精读的顺序:摘要 → 结论 → 方法 → 实验 → 数据和图表
    2. 对于需要翻译的同学来说,必备的就是“沉浸式翻译”这个插件,具体使用看下面
    3. 看图表和参考文献,判断是否正确
    4. 在这一步,遇到问题,也可以借助AI工具,
    1. 有不懂的细节继续提问,从 What、Why、How 三个方面抽取问题。

    What:即哪些概念是不熟悉的。

    Why:为什么要使用这种策略/方法,好在哪里?

    How:具体论文中是怎么实现某种策略/方法的。
    2. 对于不懂图表的,也可以借助AI工具,分析图表
    1. PopAI:接入了GPT-4V的API,可以对论文图表进行解读
    2. ChatGPT:直接读图
    3. 亿图图示:也可以解读图表

    4. 整理笔记:精读完就可以整理笔记了,这里我的思路是基于PDF本身去整理

  17. RAGFlow开源了一个RAG框架,有下面这些特点:

    RAGFlow开源了一个RAG框架,有下面这些特点:

    RAGFlow的核心功能是文档的智能解析和管理,支持多种格式,并允许用户使用任何大型语言模型查询他们上传的文档。

    RAGFlow提供了多种智能文档处理模板,以满足不同行业和角色的需求,如会计、人力资源专业人员和研究人员。

    它还强调了智能文档处理的可视化和可解释性,允许用户查看文档处理结果,进行比较、修改和查询。

    RAGFlow的一个关键优势是它允许LLM以受控方式回答问题,提供了一种理性和基于证据的方法来消除幻觉。

    项目地址:https://github.com/infiniflow/ragflow