AI探索指南

  1. 我这里有一批 ChatGPT 4.0的账号,是否有人愿意一起拼,我这里大概每天都有现开4.0的账号,我会保证每个账号大概有10人一起使用,基本没什么限制,都是官网直登账号,但是不能删除其他人聊天记录,质保一个月,可咸鱼担保,赚点零花钱~

    我这里有一批 ChatGPT 4.0的账号,是否有人愿意一起拼,我这里大概每天都有现开4.0的账号,我会保证每个账号大概有10人一起使用,基本没什么限制,都是官网直登账号,但是不能删除其他人聊天记录,质保一个月,可咸鱼担保,赚点零花钱~

    查特帕斯4.0(支持语音),仅需25元/月,提供账号密码和Token两种接入方式。
    有干净的I/P可自己直登官网,我会提供账号。
    无番茄或不懂番茄,我会提供Token和免番茄网站。
    **优势:**稳定、高效,支持3.5和4.0版本且支持原版官网插件。
    **缺点:**不支持第三方外部插件(如y猴、Chrooome插件)。
    需求可自选。

    【闲鱼】https://m.tb.cn/h.559pXwF?tk=pxS4WZGRZ2d CZ3457 「我在闲鱼发布了【查特帕斯4.0(支持语音),仅需25元/月,提供官网直登账号密码】」
    点击链接直接打开

  2. BOT(聊天机器人)通常需要一种新的通讯协议来与用户进行交互

    BOT(聊天机器人)通常需要一种新的通讯协议来与用户进行交互。这种协议通常是一种基于文本或语音的交互协议,用于指导人机对话的流程。

    现有的通讯协议,如HTTP和SMTP等,主要是为人类之间的交流设计的,它们不适合机器人之间的交互。因此,为了使BOT能够更好地与用户进行交互,需要开发新的通讯协议,例如基于WebSocket的通讯协议。

    WebSocket是一种双向通信协议,可以在客户端和服务器之间建立持久的连接,并允许双方随时发送和接收数据。这种通讯协议可以使BOT更好地感知用户的意图和情感,并作出相应的响应。同时,这种通讯协议也可以提高机器人的响应速度和交互效率,提供更好的用户体验。

    因此,开发基于WebSocket的通讯协议可以为BOT提供更好的交互体验和更广泛的应用场景。

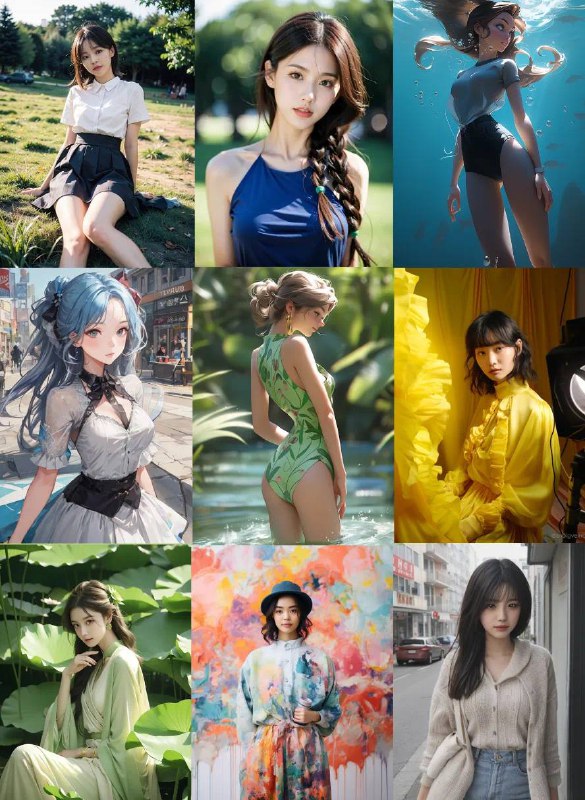
  3. 用嘴绘画的时代来了,118位AI绘画师联合出品共创的《AI绘画一本通》专栏,在小报童上线已持续更新数日,现在已经2700+订阅用户了

    用嘴绘画的时代来了,118位AI绘画师联合出品共创的《AI绘画一本通》专栏,在小报童上线已持续更新数日,现在已经2700+订阅用户了

    365个AI绘画实操案例,MJ+SD,累计50万字,各行各业、变现、应用,不能说一网打尽吧,只能说覆盖面极广!
    亮点:
    365个Al绘画实操案例
    看得懂(每个案例都有详细的教程)
    学得会(普通人都可以使用的场景,做头像,做壁纸,做写真等)照着做(把Al绘画变现方式提炼出来)
    还不贵
    小报童知识库持续更新

    链接直达:http://b.btmcheck.com/r2HY

  4. 论文:arxiv.org/abs/2309.08872

    AI探索指南
    PDFTriage:PDF分诊技术 该技术由斯坦福大学和Adobe 研究团队共同开发,主要解决了ChatGPT在处理长篇、结构复杂的文档(如PDF、网页、演示文稿等)时遇到理解不全或回答问题不准确的问题。 PDFTriage通过先了解文档的结构,然后精准地找到与用户问题相关的部分,最后用语言模型生成答案,从而解决了传统模型在处理长篇和复杂结构文档时的不足。 大型语言模型(LLM)在处理长篇、结构复杂的文档时面临以下几个主要问题: 1、上下文窗口限制:LLM通常有一个固定的上下文窗口大小,这意味着它…
    论文:arxiv.org/abs/2309.08872

  5. PDFTriage:PDF分诊技术

    PDFTriage:PDF分诊技术

    该技术由斯坦福大学和Adobe 研究团队共同开发,主要解决了ChatGPT在处理长篇、结构复杂的文档(如PDF、网页、演示文稿等)时遇到理解不全或回答问题不准确的问题。

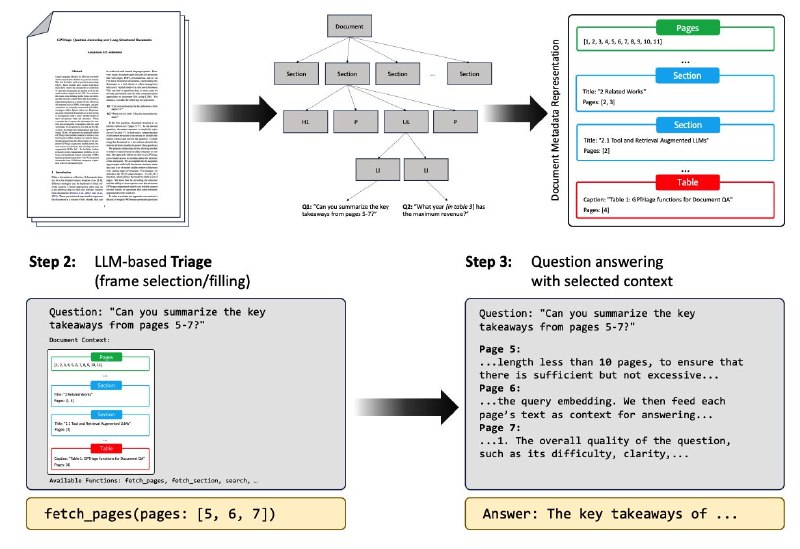
    PDFTriage通过先了解文档的结构,然后精准地找到与用户问题相关的部分,最后用语言模型生成答案,从而解决了传统模型在处理长篇和复杂结构文档时的不足。

    大型语言模型(LLM)在处理长篇、结构复杂的文档时面临以下几个主要问题:

    1、上下文窗口限制:LLM通常有一个固定的上下文窗口大小,这意味着它一次只能处理有限数量的文本“令牌”(tokens)。对于长篇文档,这就需要进行预处理或分割,以便模型能够处理。

    2、文档结构忽略:传统的LLM通常只处理纯文本,忽略了文档的结构信息(如页面、表格、标题等)。这在处理PDFs、网页或演示文稿等结构复杂的文档时会导致问题。

    3、查询不准确:由于缺乏对文档结构的理解,当用户提出与文档结构有关的问题(例如,“表3中哪一年的收益最高?”)时,传统的LLM往往无法准确回答。

    4、信息获取不全面:在处理结构复杂的文档时,仅仅依赖文本内容可能会导致信息获取不全面或不准确。

    工作原理:

    PDFTriage技术旨在解决这一问题,它能根据文档的结构信息,准确地回答用户提出的各种问题。例如,用户可以提出“请总结第5-7页的内容”或“表3中哪一年的收益最高”等问题,PDFTriage能够准确地提供答案。

    获取元数据:首先,该技术会生成文档的结构化元数据表达,包括文档各个部分(如段落、标题、表格等)的信息。

    选择相关内容:当用户提出一个问题时,该技术会根据元数据选择与问题最相关的文档部分(如特定页面、表格等)。比如,如果问题是“第5-7页的内容是什么?”,它会直接定位到这几页的内容。

    生成答案:最后,选定的文档部分和用户的问题会被LLM处理,以生成准确的答案。

    实验评估:

    研究者创建了一个包含约900个问题和90份文档的数据集进行评估。实验结果显示,PDFTriage技术在处理各种类型的文档时都表现出色,优于现有的方法。

    用户反馈:

    根据用户反馈,PDFTriage生成的答案在多页任务(如结构问题和表格推理)中排名更高,而在一般文本任务(如分类和文本问题)中排名较低。然而,在所有问题类别中,PDFTriage都优于页面检索和块检索方法。