AI探索指南

  1. GPT-4详细架构技术细节泄漏,训练一次要 6300 万美元

    GPT-4详细架构技术细节泄漏,训练一次要 6300 万美元

    今天上午一篇关于 GPT-4 详细技术架构和训练过程的文章泄漏了,虽然没有提及信源在哪但看起来还是挺靠谱的,所以我翻译了一下。

    信息量非常大全文可以在这里看:https://mp.weixin.qq.com/s/E7uP48xfbZOtUk8GXZYbmQ

    有关GPT-4的信息包括模型架构、训练基础设施、推断基础设施、参数数量、训练数据集构成、标记数量、层次数量、并行策略、多模态视觉适应、工程权衡背后的思考过程、独特实施的技术以及解决与巨型模型推断相关的瓶颈的方法。此外,文章还介绍了在A100上训练和推断GPT-4的成本以及与H100上下一代模型架构的比例关系。

  2. 刚看了一眼李飞飞的那篇voxposer,确实是一篇不错的工作,而且巧妙得提出了3D value map表示环境从而让LLM在motion planning做的更好

    刚看了一眼李飞飞的那篇voxposer,确实是一篇不错的工作,而且巧妙得提出了3D value map表示环境从而让LLM在motion planning做的更好。但并没有做出任何底层的创新或者突破性技术,更多是把现有模型做了集成然后发现了一些incremental的效果。看到大家狂吹好像是具身智能从此就要到来也是挺夸张。不得不感慨现在噪音太重,静下心来把paper多读两篇你对行业的认知就已经可以超过90%的人了吧

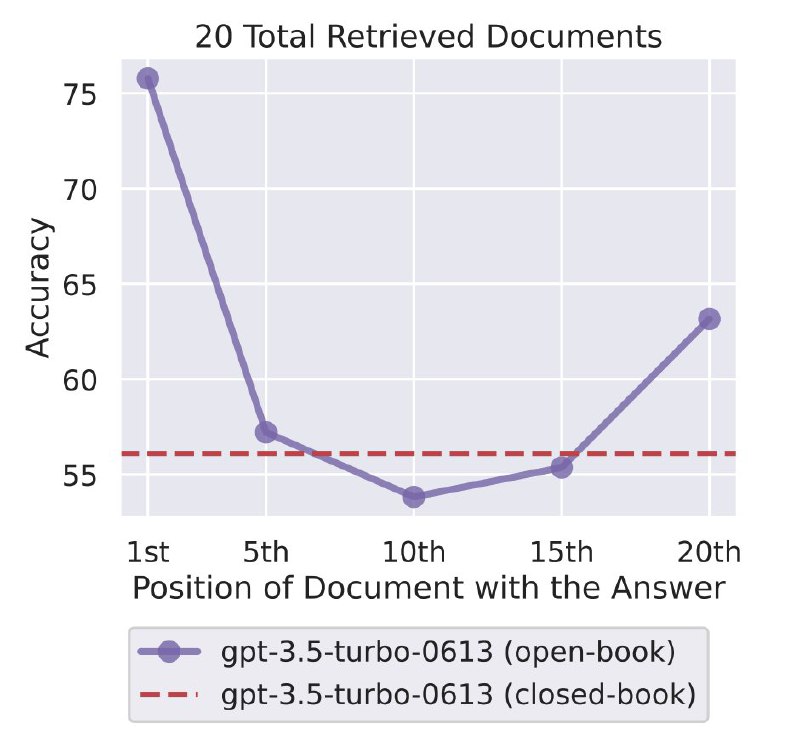
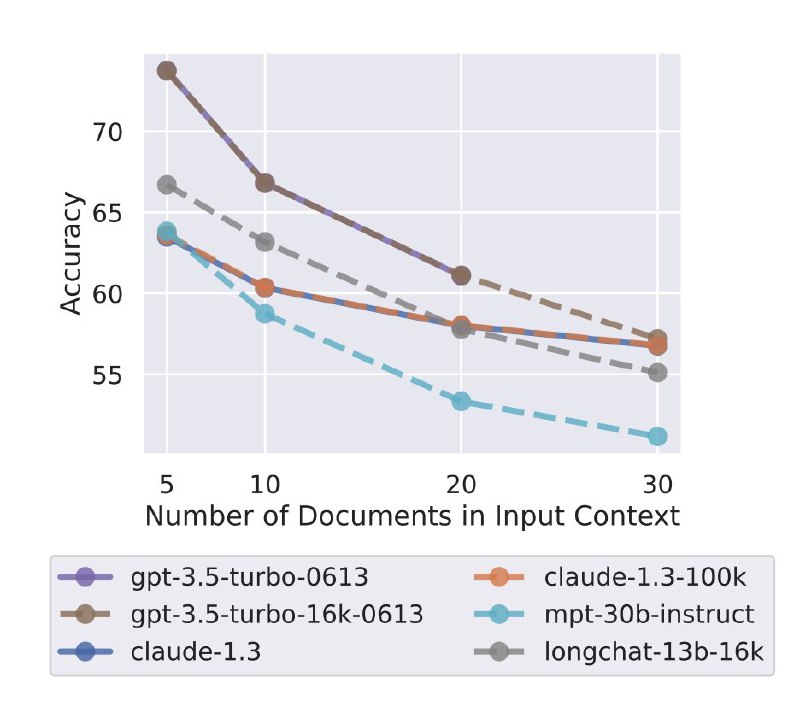
  3. 最近不少宣称支持超长上下文的论文,但实际可用性却很差

    最近不少宣称支持超长上下文的论文,但实际可用性却很差。有点像人类一目十行,LLM 看了但没注意到关键信息。
    目前可用性的平衡点可能还是100k以下。

    Jim Fan: I'm calling the Myth of Context Length:

    Don't get too excited by claims of 1M or even 1B context tokens. You know what, LSTMs already achieve infinite context length 25 yrs ago!

    What truly matters is how well the model actually uses the context. It's easy to make seemingly wild…

     https://twitter.com/i/web/status/1678460065811136512

  4. AI探索指南
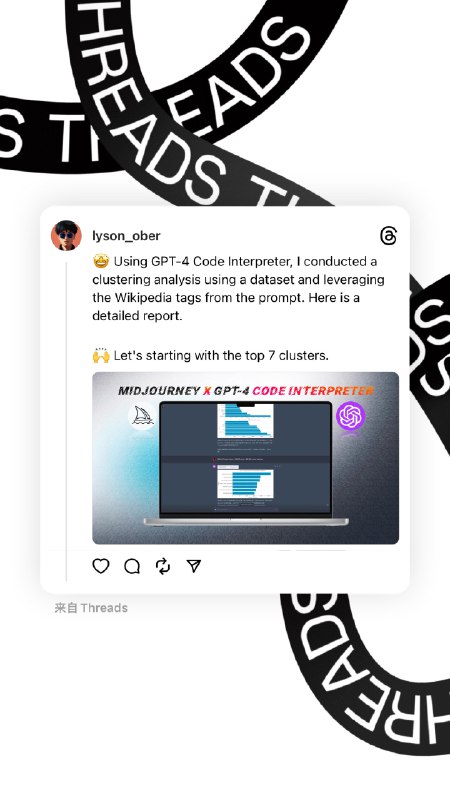
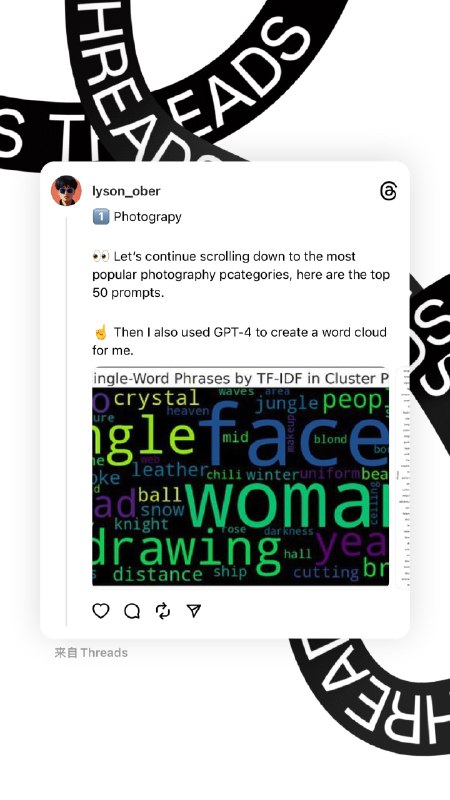
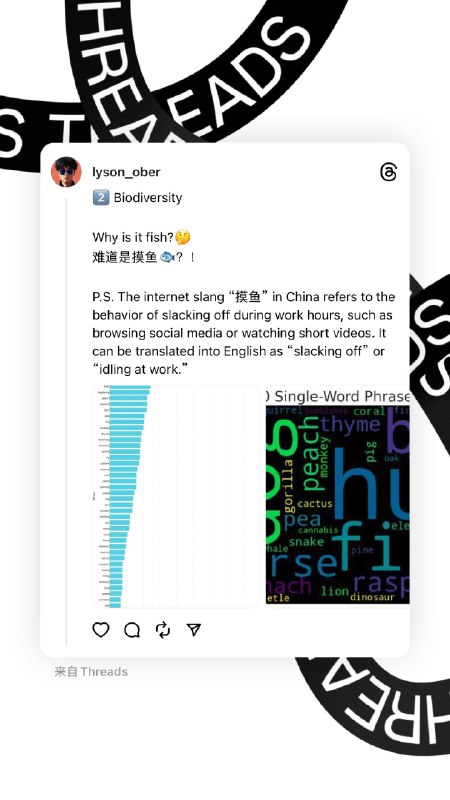
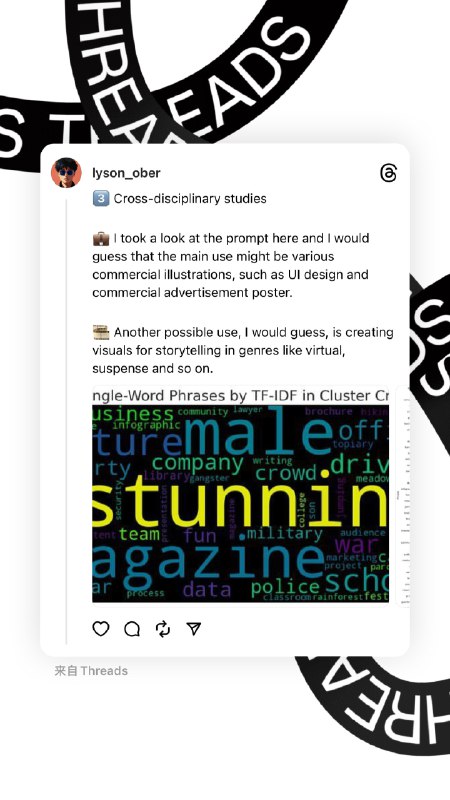
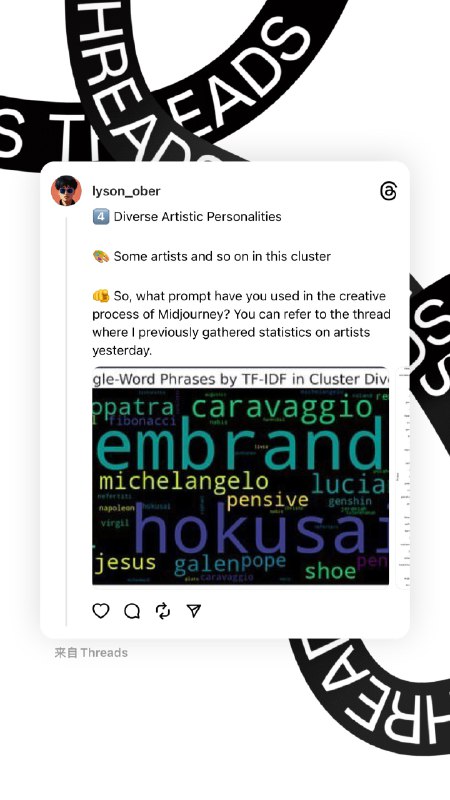
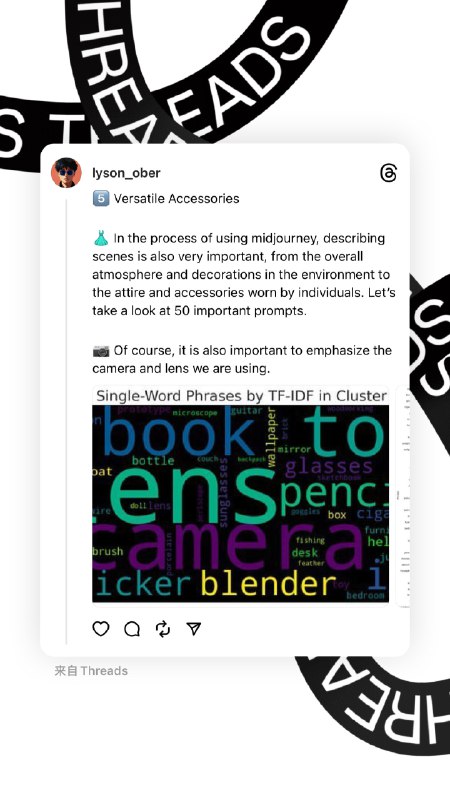
    👉 用 GPT-4 Code Interpreter 处理聚类后的数据 🤔 Midjourney 创作最受欢迎的 7 个大类方向是…… 🤔 以及每个类别的 TOP 50 Prompt 是…… Btw,我发现 Threads 有个好处是 -> 减轻了创作负担,每次只需要写一个小节 -> 没空了也没关系,能写一个小卡片算一个 😼 等整个线程写完了再发就行 我的 Threads 原链接:https://www.threads.net/t/Cuc9ANUyK9z/?igshid=YjA3ZDljY2FiMw==
    Fq7knoNUIPZv_QqdGx4oRBKfEcKmv3.jpg
    521.6 KB
    FiYz91kVH9Na3AcmJnq50s9pWuXmv3.jpg
    494.3 KB
    Fngd8-nbM2G4MI1SZahuMx5mVpCpv3.jpg
    591.6 KB

  5. 👉 用 GPT-4 Code Interpreter 处理聚类后的数据

    👉 用 GPT-4 Code Interpreter 处理聚类后的数据
    🤔 Midjourney 创作最受欢迎的 7 个大类方向是……
    🤔 以及每个类别的 TOP 50 Prompt 是……
    Btw,我发现 Threads 有个好处是
    -> 减轻了创作负担,每次只需要写一个小节
    -> 没空了也没关系,能写一个小卡片算一个
    😼 等整个线程写完了再发就行
    我的 Threads 原链接:https://www.threads.net/t/Cuc9ANUyK9z/?igshid=YjA3ZDljY2FiMw==