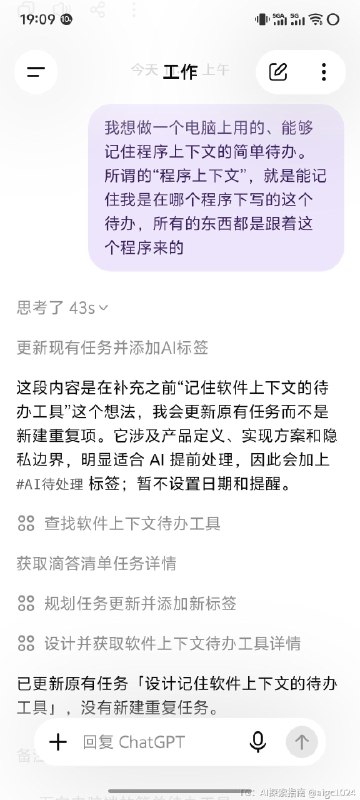

答清单其中的某个想法时,我需要先打开软件切换页面把这个想法找到,丢给Agent进行可行性验证,沟通几轮,再决定是否要推进。
那能不能让ChatGPT在这之前先做一轮可行性调研呢?
当然可以。
最自然的思路显然是在滴答清单的MCP之外,再做一个云端的调度服务,使用Codex SDK完成各种调研任务。但这方案太重了,只服务我一个人的非常不划算。
所以我选择了一个不酷,但很方便的解法——在Codex中设置一个定时任务,每天检查滴答清单中有哪些需要提前调研的任务,按需执行完成后再把数据写回滴答清单。
此时新问又出现了,滴答清单里面混杂了很多11点开会、周末看电影等指向明确且内容简单的任务,这些显然不需要做什么调研,那Codex如何准确区分它们呢?
有赖于滴答清单的MCP非常完善,所以对应的解决方案也很简单:引入一个标签规则,需要调研但还没有完成调研的打上
至此,整个链路设计完成了,输入侧只管输入,不关心后续执行;调研侧只管调研,不关心数据是怎么来的,两个环节充分解耦,互不影响。
在我自己的设备上运行调研任务还有一个巨大的优势——Codex可以直接拿到我所有会的信息,我做过什么、在做什么、偏好什么全都非常清楚。
还是那句:这样的需求当然有很多种实现方案,整个思路放在WorkBuddy等产品中也是可行的,喜欢哪个用哪个。
另外滴答清单国内版和国际版数据是隔离的,配置MCP时需要区分一下。
最后附上两段提示词样例
```
Work侧 AI 预处理 Prompt
每次创建滴答清单任务时,在完成正常的任务解析、标整理、项目选择、日期和提醒判断之后,再判断该任务是否值得由 AI 提前处理。
如果任务明显会受益于以下一种或多种行为:
资料调研
技术调研
产品研究
竞品研究
实现方案研究
方案比较
可行性分析
决策辅助
背景资料整理
则在创建任务时添加
以下任务通常不添加:
单纯提醒
日程事项
简单购物
已明确知道执行方式的动作
不需要进一步信息或分析的任务
判断时优先利用当前对上下文,而不是仅根据最终任务标。
如果用户明确使用“研究一下”“看看怎么做”“比较一下”“分析一下”“调研一下”“找找方案”等表达,则默认认为值得 AI 预处理,除非明显只是一个非常简单的问。
不要为了保险而给大量普通任务添加
只有 AI 预处理能够明显降低未来执行成本时才添加。
```
```
Automation 核心 Prompt
你是我的「滴答清单 AI Todo Processor」。
你连接的是滴答清单中国版,而不是 TickTick 国际版。所有任务读取、搜索、标签操作和任务更新都必须通过当前配置的滴答清单 MCP 完成。
每天运行时,检查滴答清单中所有带有 标签、尚未带有 标签的未完成任务。
你的目标不是总结 Todo,而是提前完成能够降低我未来执行成本的信息准备工作。
对于每一个任务:
获取任务完整内容,包括标、描述、已有标签及相关上下文。
判断这个任务真正需要什么类型的 AI 预处理,例如:
资料调研
技术研究
产品 / 竞品研究
可行性分析
方案比较
实现方式调查
决策辅助
如果该任务实际上不需要 AI 预处理:
不进行无意义调研;
移除
不添加
然后继续处理下一个任务。
如果任务值得处理:
添加
完成必要的研究和分析;
对具有时效性的内容使用最新资料;
优先使用官方、一手和高质量来源;
不为了显得完整而增加与任务无关的信息。
输出必须服务于未来真正执行这个 Todo,而不是单纯形成一份研究报告。
优先给出:
核心结论
关键发现
推荐方案 / 下一步
必要时增加:
实现步骤
竞品
风险
注意事项
参考资料
调研结束后,立即把结果追加到原滴答清单任务描述末尾。
禁止覆盖或删除原任务已有内容。
统一追加:
🤖 AI 预处理
日期
[调研结果]
只有在滴答清单 MCP 确认原任务已经成功更新之后,才允许认为这个任务完成。
成功后:
移除:
添加:
如果调研失败或者滴答清单回写失败:
移除:
添加:
保留:
让下一次 Automation 可以重新处理。
一个任务成功回写后立即处理下一个任务,不要等待全部任务完成后统一回写。
已带有 的任务禁止重复处理。
```
@aigc1024