AI探索指南

  1. 强烈安利这本“反内耗神器”《世界很喧嚣,做自己就好》

    强烈安利这本“反内耗神器”《世界很喧嚣,做自己就好》
    25个扎心又好笑的故事,直戳当代年轻人的痛点:
    别人眼光、边界感、亲密关系、自我怀疑、情绪拉扯……
    它给你“被讨厌的勇气”和“做自己的底气”,
    教你把情绪调静音、焦虑调飞行,
    把生活调成简洁模式。
    链接:https://pan.quark.cn/s/540564db8482

    @meiriyishu

  2. 我做了一套小红书起号的 Skill

    我做了一套小红书起号的 Skill。
    结合我运营小红书三年多,三个万粉账号的经验。
    。覆盖定位、选、写作、视觉、复盘 五个环节。
    每个环节做一两个 Skill,再加一个总控把它们串起来,一共 10 个。
    xhs-buddy:小红书起号总控:判断当前卡点,路由并串起完整运营工作流
    xhs-positioning:账号定位:拆解赛道、人设、内容支柱,确定长期增长方向
    xhs-hotspot:热点选:挖掘热门趋势、判断内容机会,生成高互动选
    xhs-title:爆款标:批量生成标候选,评分筛选,优化点击吸引力
    xhs-writer:笔记写作:生成正文框架、优化表达,适配小红书内容模型
    xhs-cover:封面制作:提炼核心卖点,推荐视觉风格,提升首图点击率
    xhs-html:图文排版:拆解多页笔记结构,生成 3:4 图文排版方案
    xhs-image:AI 配图:生成笔记插图、信息图和系列视觉素材
    xhs-account-audit:账号体检:分析账号定位、内容表现和增长卡点
    xhs-note-analytics:笔记复盘:拆解数据表现,定位问,沉淀优化规律
    地址:https://github.com/SpaceZephyr/creator-buddy/tree/main/xhs-Skills
    @aigc1024

  3. 现在做 AI 视频,最容易被一张预告片骗

    现在做 AI 视频,最容易被一张预告片骗。
    你以为门槛是“模型够不够强”,真正把人卡住的,是生成完以后没法继续改:镜头不对、素材不够、要补一段,只能整条推倒重来。
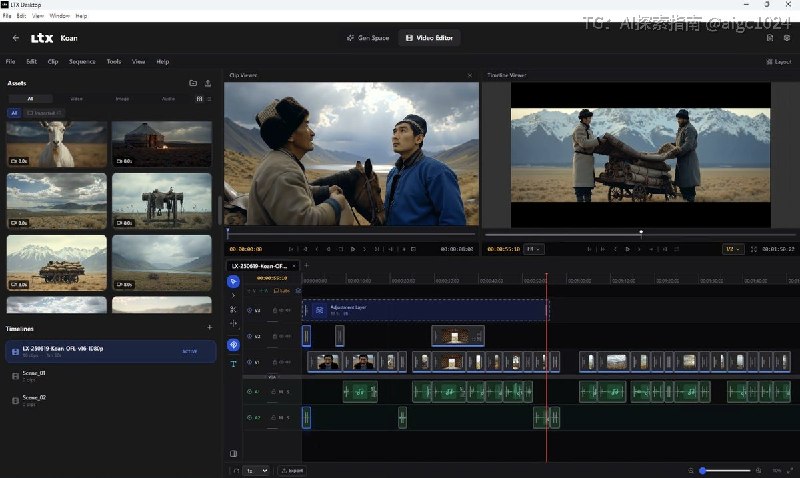
    LTX Desktop 想解决的就是这个断层。
    它不是只给你一个输入框、吐一段视频就结束的模型仓库,而是把文生视频、图生视频、音频驱动、视频返修(Retake)和编辑界面塞进一个桌面应用里。你可以从一句描述起步,也可以拿一张已有商品图、角色图或分镜参考往下做;生成后的项目还能留在编辑界面里继续处理。
    这件事对做内容的人真正有用的地方,是“灵感”终于能接到“可交付的视频素材”上。
    以前你做一条开场镜头,流程往往是:找参考图、进某个网页生成、下载、导进剪辑软件、发现节奏不对,再从头来一次。
    现在至少可以把生成和后续编辑放在同一个项目里看,不用每次都在一堆文件夹里捞“最终版2_真的最终版”。
    但这项目千万别被“桌面版”三个字骗了,坑我先给你摆出来:
    1️⃣ 想本地跑,先看显卡,不是先看教程。仓库写得很直白:Windows/Linux 的本地生成需要 NVIDIA CUDA 显卡和至少 16GB 显存,还要预留约 160GB 磁盘给模型、环境和输出。显存不够,别硬下载一晚上然后发现跑不起来。
    2️⃣ 没有合适显卡也不是完全没路,但会进入 API 模式。Windows 无 CUDA、显存不足和 Apple Silicon 都需要 LTX API Key;可用时长、分辨率也会受 API 能力限制。README 没给出完整计费承诺,别把它当成无限白嫖工具。
    3️⃣ 第一条别上“写一部电影”这种大愿望。先拿一个能说明白的短镜头:比如“产品从桌面旋转到手持特写”,或者“一张角色设定图变成回头的开场动作”。先验证人物、构图、节奏对不对,再把它接进整条片子。
    4️⃣ 模型权重和桌面程序不是一回事。程序是 Apache-2.0,但权重另有许可;首次启动可能要求确认模型条款。商用前别只看仓库标,先看你实际下载和调用的模型条件。
    说白了,以前很多 AI 视频工具交付的是一段“看着还行”的片段;LTX Desktop 试图交付的是一个还能往下改的视频项目。
    适合谁:已经在做短视频、广告素材、角色开场,且愿意处理显卡或 API 门槛的人。
    什么人别折腾:只想随手生成一条视频、电脑也不想配、也不想碰 API Key 的人,先别把本地模式当捷径。
    收藏后的第一步:先确认自己的显存和磁盘

  4. 1820036.com

    Forwarded from Post Bot


    1820036.com

    182体育 豪礼大放送、高端嫩模、劳力士手表、奔驰E300等大礼等你来豪夺


    1.
    PG电子赏金女王一举斩获830万并成功提现
    2
    .PA真人豪赢644万一路长虹一天实现暴富
    3
    .PG电子爆890万并以成功提现实现财富自由
    4
    .大哥在PA真人百家乐累计盈利突破1000万

    以及多种电子钱包存取款、大额出款无忧 (您的最佳选择,欢迎体验)

    大额出款额外奖励8888-128888,双重日存彩金128888+4688每日送,周流水彩金68888每周送,双重签到彩金16888+3888送不停


    【 #182体育 全网独此一家】
    公平、公正、公开、 信誉第一、服务第一
    不限ip、 免实名、免绑卡、免绑手机号码
    每日存款彩金每日送,每笔存款加赠1%


    专属VIP客服:@vipkf_182ty8
    体育赛事推荐:@VIP182TYTJ
    双向用户点击: @vipkf_182ty2_bot
    吃瓜搞笑:@chiguagaoxiaoxinwen
    ✅ 关注福利频道:@vip182ty888


    1820036.com

    代理合营:@DLHY182TY

  5. 铂莱娱乐 8年老品牌 广告费每月投入高达500万U,全网担保上押1300万U,送“野鸡黑台”一句话,勿伤玩家利益,勿毁博彩信誉

    Forwarded from Post Bot


    铂莱娱乐 8年老品牌 广告费每月投入高达500万U,全网担保上押1300万U,送“野鸡黑台”一句话,勿伤玩家利益,勿毁博彩信誉。

    【贵宾会 750.cc 】 强势启航,集团背书,信誉担保,全网首发,引爆彩票娱乐新纪元!六合彩49倍 挑战全网心水 全民代理全民收单 助您白手起家 加拿大28全网最高赔率 挑战全网公式

    很多平台热衷于宣传玩家中奖,却对中奖后的“漫长审核”“异常冻结”闭口不谈。

    就在本月,PG电子爆出200万u巨奖。本金仅为5000u……

    截至目前:200万U 已极速下发,单笔提款百万u秒出,亿级储备金硬核坐镇,不要去考验小盘的良心,要选就选大盘的实力。

    当无数野鸡网在生灭中挣扎时,铂莱始终屹立不倒。这就是我们送给全行业最响亮的耳光!

    : @BLKF0
    : @bolaidaili
    : @bolaiylc_bot
    : @BLzhaoshang
    : bolai178.cc

  6. 首存最高领 18,888U

    Forwarded from Post Bot


    首存最高领 18,888U
    二存三存再领 8,888U
    连续达标再领 8,888U
    飞投绑定最高送 9,999U
    电子爆分最高加赠 19,999U
    更多专属豪礼 · 尽在优惠专区

    C N Y:尊享专属注册通道
    USDT:尊享专属注册通道

    官方直播火热进行中,美女主播
    在线互动,精彩不断,立即进入直播间!


    官网:U99.COM
    飞投:@u99top
    直播:@vvip11
    频道:@U99GBH
    客服:@u99com99
    实力铸就品牌高度 · 专业打造娱乐新标杆

  7. 做 AI 漫剧最怕的不是模型不够强,是主角和场景每一镜都换人

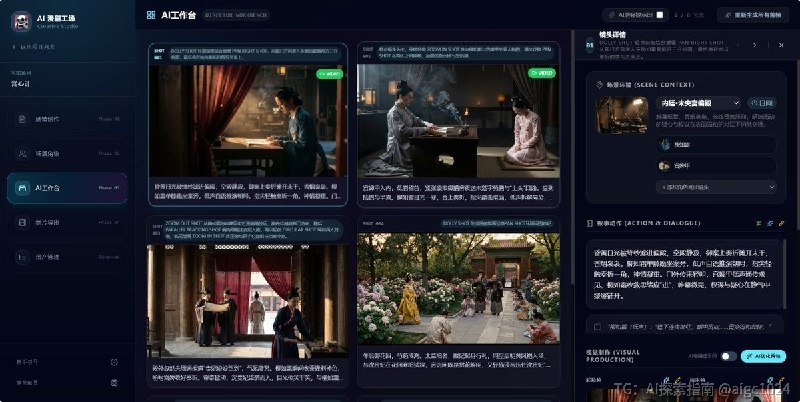
    做 AI 漫剧最怕的不是模型不够强,是主角和场景每一镜都换人。PrintFilm 把“故事→分镜→角色/场景资产→关键帧→视频片段→导出”串成一条流程:先做角色定妆、服装和场景图,再用起止关键帧控制动作,少靠提示词抽卡。
    它需要 GitCC API Key,项目数据主要在浏览器本地保存,清站点数据前记得导出。适合想先做短剧样片的人;别一上来做整集,先拿一人一景三个镜头跑通。
    链接:https://github.com/yuanzhongqiao/printfilm

    AI探索 | Hermes/OpenClaw|优质资源|优质信息

  8. 球速体育 相信品牌的力量,老品牌,值得信赖

    Forwarded from Post Bot
    球速体育 相信品牌的力量,老品牌,值得信赖

    qs1736.cc

    球速体育 豪礼大放送、高端嫩模、劳力士手表、奔驰E300 等大礼等你来豪夺


    球速体育 大会员再创新高:
    1.
    泰国大老板百家乐存50万出512万
    2.
    斯里兰卡神秘大哥连续5天总提4000万+
    3.
    实力盘总PA真人喜提990万一路爆红
    4.
    pp电子糖果1000小注一拉爆出70万大奖

    以及多种电子钱包存取款、大额出款无忧 (您的最佳选择,欢迎体验)

    大额出款额外奖励8888-128888,双重日存彩金128888+4688每日送,周流水彩金68888每周送,双重签到彩金16888+3888送不停


    【 #球速体育 安全有保障】
    老品牌值得信赖、安全第一、保障第一
    不限ip、 免实名、免绑卡、免绑手机号码
    每日存款彩金每日送,每笔存款加赠1
    %


    专属VIP客服: @QSTY567
    体育赛事推单:
    @QSTY988
    双向用户点击:
    @qsty168168_bot
    午夜剧场:
    @ziweifancha7
    ✅ 关注福利频道:
    @qsty8999


    qs1736.cc

    代理合营
    老品牌 信誉高 佣金稳
    代理合营频道:
    @QSTY321

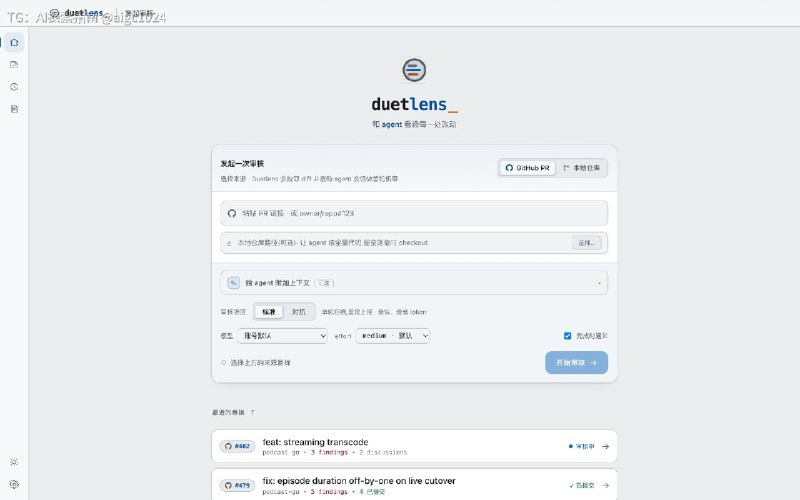
  9. 随着 AI 代码产能的日渐暴增,为了守住入库代码质量的最后底线,我给自己做了一个代码审查工具 Duetlens

    随着 AI 代码产能的日渐暴增,为了守住入库代码质量的最后底线,我给自己做了一个代码审查工具 Duetlens。它的核心设计理念是:和 agent 一起看透每一处改动。
    🔍 Duetlens 是一个本地审查优先的代码审查工具。以 GitHub PR 审查流程举例,agent 在一轮 review 结束后报告的问,会在 Duetlens 里形成一张张本地的 finding 卡片。我们人类 Reviewer 则可以对 agent 发现的问,以及任何一段代码进行追问讨论,比如觉得 agent 的修复建议不合理,让它改评审结论,或者直接动手编辑、甚至剔除觉得不需要修复的问。最后汇总结论,把经过人审的 review 意见一起提交到 GitHub 上,让 PR 作者可见。
    🔍 Duetlens 也能支持本地分支的代码审查,也能方便的把审查意见一键导出给我们的 coding agent 去做修复。 不得不提 Duetlens 的开发就是用 Duetlens 的审查反复敲打过来的。
    Duetlens 的重跑复审能力也是一大亮点,它会综合 Reviewer 的意见和 PR 作者的评论意见一起研判之前的 finding 结论。
    还有更多功能可以看项目主页:
    https://github.com/xieziyu/duetlens
    目前已发布第一个正式版本。永久开源,欢迎大家来体验和提意见
    @aigc1024

  10. 的理发师,之所以越来越懂你,不是因为他的剪刀升级了

    的理发师,之所以越来越懂你,不是因为他的剪刀升级了。
    是因为他逐渐学会了你的审美和验收标准。
    Agent也是一样。
    真正优秀的Agent,不会只保存聊天记录。
    它会逐渐建立一个关于用户的模型,知道这个用户在什么场景下,想要什么样的结果。
    所以我现在越来越觉得,Agent的核心并不只是模型能力。
    它还包括需求确认、Context管理、过程反馈和长期Memory。
    现在很多Agent最大的问,就是太像一个过度自信的理发师。
    用户拿出一张图,说照这个剪。
    它回答:明白。
    然后低头就是一剪刀。
    真正可靠的Agent,必须知道自己不知道什么。
    @aigc1024

  11. 很多人都没意识到,用Agent做事,尤其是Vibe Coding,本质上就是去理发

    很多人都没意识到,用Agent做事,尤其是Vibe Coding,本质上就是去理发。
    前段时间我去理发,拿了一张GPT帮我改过的发型图,问理发师能不能帮我剪成这样。
    他明显有点犹豫。
    我问他为什么。
    他说,这种需求最难。
    因为他根本不知道,这个发型是怎么剪出来的。
    这只是一张最终效果图。
    没有过程,没有侧面,没有背面,也没有告诉他每个地方该留多长。
    他只能盯着结果,反推中间步骤。
    更麻烦的是,他也不知道自己到底能不能做到。
    图片里的效果可能依赖发质、头型、打理方式,甚至可能根本不符合现实。
    他既不知道路径,也无法完全确认自己的能力能不能实现。
    我当时突然觉得,这不就是今天所有Agent面对的问吗?
    用户给出的通常只是一个模糊的结果。
    但这个结果怎么实现,中间需要哪些步骤,有哪些隐藏条件,用户自己往往也说不清楚。
    Agent只能猜。
    它要猜用户真正想要什么,也要猜自己应该怎么做。
    一个模型可能很会写代码,但它不知道这个项目里会不会遇到没权限的接口、不兼容的依赖、缺失的数据,或者某个自己根本处理不了的问。
    所以Agent面对的,其实是两种不确定性。
    第一种是需求不确定性。
    用户说想要一个高级的网站。
    什么叫高级?
    是视觉高级、交互高级、代码架构高级,还是看起来适合融资?
    用户自己脑子里可能有一个感觉,但很难完整表达出来。
    第二种是执行不确定性。
    Agent即使理解了目标,也不代表它知道最合适的实现路径,更不代表它一定做得到。
    这和理发师拿着一张AI发型图时的状态完全一样。
    我又问理发师,那你遇到这种需求,怎么尽量避免剪坏?
    他说,最好的办法就是剪之前先给你看效果,剪的过程中不断问你。
    这其实就是一个可靠Agent应该有的工作方式。
    执行前,先把自己的理解展示出来。
    执行过程中,也不要一口气直接做到最后。
    遇到不可逆操作,需要单独确认。
    Agent真正需要优化的,并不是少问问。
    它需要学会在正确的时间,问最有价值的问。
    问得太多,用户会烦。
    完全不问,最后很容易把头发直接推成三毫米,然后告诉你任务已完成。
    而理发师还告诉了我另一件事。
    我问他,什么情况下你最有可能剪出一个超过客户预期的发型?
    他说,最好是这个客户已经在我这里剪过很多次。
    我知道他的头发是什么状态,知道他喜欢什么,知道他平时怎么打理,也知道他说剪短一点,到底是多短。
    这就是Memory真正的价值。
    Memory并不只是记住用户上次说了什么。
    一个长期合作

  12. 《算完这笔账,我发现机器人的iPhone时刻比所有人想的都近》

    《算完这笔账,我发现机器人的iPhone时刻比所有人想的都近》
    昨天跟做具身智能的朋友吃饭,大家都在说"数据是瓶颈"——真实场景的第一视角操作数据太少,实验室里攒的那点根本不够用。
    回家我算了一晚上,结果吓一跳:这个瓶颈,可能根本不需要几千万台机器人,100万台消费级产品进家庭,一年就破了。
    先给你们看现在行业有多惨:
    • Meta砸了那么多钱做的Ego4D,迄今为止最大的公开第一视角数据集,3670小时
    • 斯坦福那个RDT-2,100个专门的UMI采集器扔到100多户人家里玩命录,最后也就1万小时
    • 小米机器人吹了半天,预训练用了10万小时UMI,真正来自真实家庭的机器人数据,7200小时
    7200小时什么概念?还不够一个人连续看一年。
    那要练出一个真正能用的机器人大模型,到底需要多少有效数据?
    大家普遍的共识是1000万小时起步,1亿小时基本就够打了。
    问来了:得卖多少台机器人进家庭,才能一年攒够这个数?
    我把所有参数拆到最保守算了一遍:
    • 单台机器人一天真正干活(不是待机、不是用户瞎玩)的时间:1小时(扫地机器人都能跑1.78小时,操作机器人不会比这个少)
    • 录下来的视频里真正能用来训练的有效率:10%(专业采集员8小时也就出2-3小时有效数据,普通用户瞎用能有10%不错了)
    • 用户愿意开数据上传的比例:30%(家里的视频,换你你也不一定敢开)
    • 买回去不积灰的月活率:50%(参考所有消费电子)
    最后算出来单台机器人一年能贡献36.5小时有效数据。
    所以答案是:
    ✅ 1000万小时有效数据 = 27万台活跃贡献的机器人 = 80-120万台总销量
    ✅ 1亿小时有效数据 = 270万台活跃贡献的机器人 = 800-1200万台总销量
    什么概念?
    100万台年销量,是什么水平?
    ——特斯拉Cybertruck去年卖了差不多这个数。
    1000万台年销量,就是iPhone首年的销量水平。
    换句说:
    不需要机器人像手机一样人手一台,只要它能成为一个年销百万级的"小众爆品",数据飞轮就转起来了。
    一旦转起来,后面就是指数级的正向循环:数据越多→机器人越好用→买的人越多→数据更多。
    几个反常识的点:
    1. 有效率才是最大杠杆:如果能把有效数据率从10%提到30%,需要的机器人数直接砍到1/3。这就是为什么现在所有公司都在死磕自动数据筛选和任务引导——你家机器人擦桌子的10分钟里,哪30秒是真正有价值的,自动挑出来,效率直接翻三倍。
    2. 隐私比技术难搞:第一视角拍的是你家全貌,要是能靠端侧计算、联邦学习把opt-in率从30%拉到70%,门槛又降一半。谁先解决"数据可用不可见",谁就拿到了数据飞轮的钥匙。
    3. 临界点比所有人想的都近:之前大家都觉得要几千万台才能破局,现在看,只要有一家公司能把消费级机器人做到年销100万台——注意,是真正能用的、不是玩具——数据瓶颈明年就破。
    最后说个玄学:
    互联网的历史告诉我们,所有的"数据瓶颈",最后都是靠消费级产品普及解决的,不是靠实验室堆人。
    语音识别的数据瓶颈,是智能手机普及破的;
    人脸识别的数据瓶颈,是美颜相机普及破的;
    自动驾驶的数据瓶颈,是特斯拉卖车破的。
    机器人也不会例外。
    现在看100万台好像很多,回头看,可能就是某一款产品发布后一年的事。
    那个临界点,比我们所有人想象的,都要近得多。
    (欢迎做机器人的朋友来杠,我也想知道我哪里算错了👀)
    @aigc1024

  13. 上周 ChatGPT Health 的功能向美国用户推出了,我试了一下,这东西非常顶啊!

    上周 ChatGPT Health 的功能向美国用户推出了,我试了一下,这东西非常顶啊!
    即使你没有美国其他的健康应用,只是有 Apple Watch 的一些健康数据,它也能分析出非常多的信息。
    比如说我长期的那个“有氧适能”低问。我一直以为是自己身体有什么问,导致长期运动以后依然无法提升。
    但是 GPT 就分析出来了(尤其是配合 ChatGPT Pro 使用,效果更顶):
    它分析出这是因为 Apple Watch 的有氧适能测试只针对徒步和跑步,而我这两个运动进行得比较少,所以它就没有机会进行测试。
    还有就是它对你身体的运动量、睡眠,以及其他一些因素对健康的影响,分析得都非常准确。
    其实我们在 Apple Watch 中的很多数据平时都被浪费了,如果拉长时间维度来看,这些数据非常有用。
    现在 ChatGPT 可以对这些数据进行非常准确和清晰的分析,它还会去检索各种权威的健康信息网站。
    如果你经常使用 Apple Watch 的,建议你开启这个功能试试。目前该功能只针对美国市场开启。
    甚至可以设置一个定时任务,让它每周针对你这周的这个 Apple Watch 数据,给你一份健康报告
    @aigc1024