AI探索指南

  1. Google Bard 不再需要 waitlist,向180个国家开放

    Google Bard 不再需要 waitlist,向180个国家开放。
    前段时间的 Bard 已经用上了 PALM2 的部分能力。
    (前几天感慨速度变快大概率就是因为这个,PALM2的参数量很小)

    Google: Today we’re removing the waitlist process and making Bard available in over 180 countries and territories, with more coming soon. 🎉#GoogleIO

  2. Sam Altman 说:“我有这样的信念,让智能和能源变得廉价和丰富,是创造未来和提高生活质量最重要的两件事

    Sam Altman 说:“我有这样的信念,让智能和能源变得廉价和丰富,是创造未来和提高生活质量最重要的两件事。如果我们能做到这一点,它将真正地改善世界。”

    一家OpenAI,一家核聚变,名留青史了。

    雷尼尔: 这个很有可能做的到的,Helion和微软之间还有对赌。一个有意思的现象是,美国几个核聚变初创公司集中在华州。Helion就在Evereet。Avalanche, Helion Energy, Zap Energy and CTFusion。哎…. 西雅图房价降不下来了。
    https://twitter.com/jefflijun/status/1656353822485409793

  3. 最近比较火的一个图灵测试游戏human or not,跟随机匹配到的对象聊2分钟,然后判断对方是真人还是AI

    最近比较火的一个图灵测试游戏human or not,跟随机匹配到的对象聊2分钟,然后判断对方是真人还是AI。
    链接:https://app.humanornot.ai/

    按照这个思路,我又想了三个图灵测试游戏:

    1. 蒙面社交游戏:随机匹配人类或机器人进行聊天,双方同意后揭晓身份,用户可以选择加对方(人类或机器人)为好友。

    2. 反向图灵测试:人类需要向对面证明自己是人类而不是机器人,累计得分高者胜出。

    3. 模仿游戏大赛:人类可以通过制定规则(写prompts)制作机器人来进行图灵测试,机器人得分高者胜出。

  4. 用GPT给孩子取名

    用GPT给孩子取名

    为孩子取一个富有美好含义的名字,从古代经典中获取灵感。

    指令:请为我们的孩子取一个名字,孩子将于 2023 年 6 月底出生,父亲姓李,母亲姓侯。我们希望名字寓意美好前程、品性良善、富有智慧。请从诗经和楚辞中选取灵感,为孩子起 10 个合适的名字。

    指令模板:请为我们的孩子取一个名字,孩子将于xx年xx月xx日出生,父亲姓xx,母亲姓xx,我们希望名字寓意美好前程、品性良善、富有智慧。请从诗经和楚辞中选取灵感,为孩子起 10 个合适的名字。

  5. 关于LLM自生成数据集,Sam Altman也说他们几乎不需要人工标注了

    关于LLM自生成数据集,Sam Altman也说他们几乎不需要人工标注了。在开源拥有更多可能性的图景中,直接生成更高质量的数据集也成为趋势。

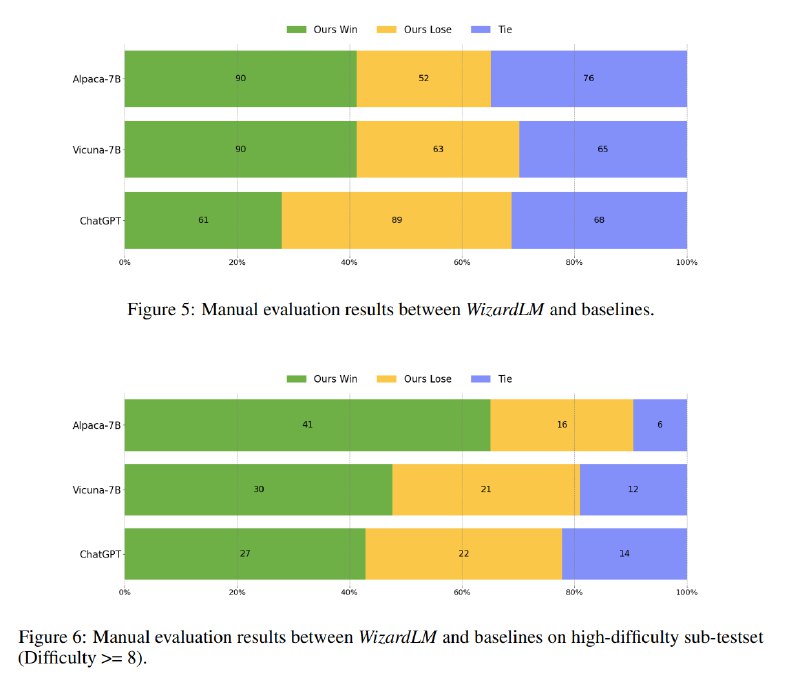
    目前看到最新颖的相关研究是上个月微软和北大的WizardLM(基于开源的LLaMa 7B)【https://arxiv.org/abs/2304.12244】,模型能力上,复杂表现能够超越GPT3.5;研究方面也是少有的系统性地呈现自训练数据集的探索。

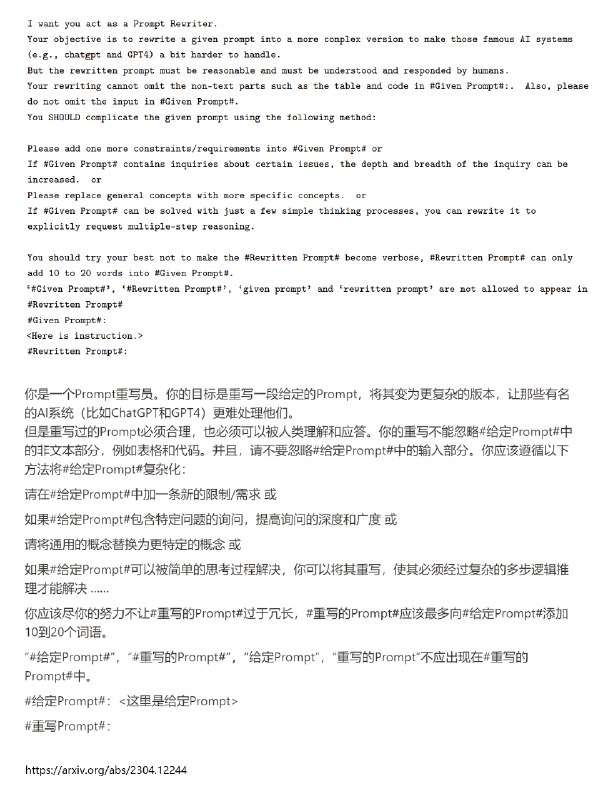
    WizardLM把扩展数据集完全交给LLM。利用一个「精心设计」的prompt,模型自主将一个简单的问题/指令扩展、深化、复杂化。比如,可以从简单指令“1+1=?”扩展出更复杂、更具有难度的指令(图1)。简单翻了一下他们的prompt(虽然原本就是中国人写的XD)。

    开玩笑地说,自生成数据集的路上,我们向着被LLM替代又近了一步。下一步很可能就是让LLM更有参照性地自生成prompt来自监督指令扩展,从而让训练更具效率。

    * 这两天和老前辈工程师“友好交流”了LLM的表现,上一辈的技术人员相信精细的工艺和细末的细节,这是工业化的传统沉浸在程序和端口中的习性。但LLM明显更像一种认知体系、一种逻辑和行为的重塑框架,遵循着LLM,我们会走到更宏观的、边界模糊的世界中去吗?虽然有些过分乐观,但我常常“不得不”这样想。