AI探索指南

  1. 手把手教你训练你自己的AI歌手,最重要的一步来了

    手把手教你训练你自己的AI歌手,最重要的一步来了。如何训练歌手的模型。这一步主要由两部分组成数据处理和模型训练。

    感谢各位的支持,下面是具体步骤🧶

    详细教程和文件下载可以看这里:https://mp.weixin.qq.com/s/IeeW1PbMUbxMlLl529JTYQ

    首先我们需要准备你训练的人的声音素材,尽量找质量比较高人声比较清晰的音频。

    歌手的声音素材是比较好找的,因为他们的歌就是天然的素材,我们在训练的时候最少要准备30分钟以上的人声素材,一般一个小时到两个小时最好。但是声音的质量大于时间长度,不要为了凑数搞一些质量不那么好的素材。

    在准备好足够的声音素材之后我们开始对素材进行处理,跟第一期一样,先把我们的素材转换为WAV格式,批量转换的话还是用格式工厂之类的本地软件比较快。

    获取到我们个WAV格式素材之后,继续进行跟上个教程一样的步骤利用UVR去掉我们素材的伴奏以及混响之类的声音,只留下单纯的人声。

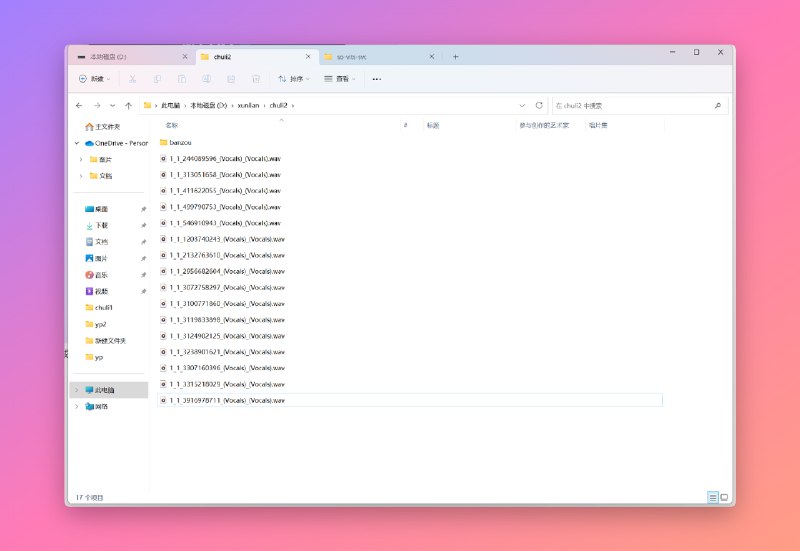
    处理完成后扔掉分离出来的伴奏,只留下人声素材,整理好备用。类似我下图这样扔到一个文件夹里。
    接下来我们要对处理好的人声文件进行分割,因为如果训练的时候每段文件过长的话容易爆显存。

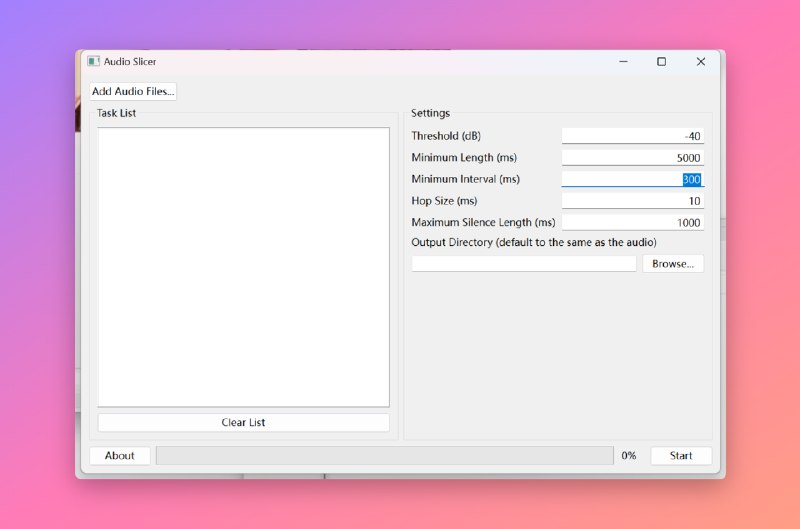
    这个时候就要用到下载文件里的【slicer-gui】这个软件了,它可以自动把声音素材分割成合适的大小。我们先打开slicer-gui,刚开始的参数按我的来就行。

    把你你准备好的人声素材拖到【Task List】里面,在Output位置设置好输出文件夹的位置,然后点Start就可以开始分割了。

    处理好的文件,基本上就是下面这个文件的样子,处理完成后在输出文件夹把文件从大到小排序,看一下最大的文件时多长的,分割完的素材每一段尽量不要超过15秒。不然有可能会爆显存。

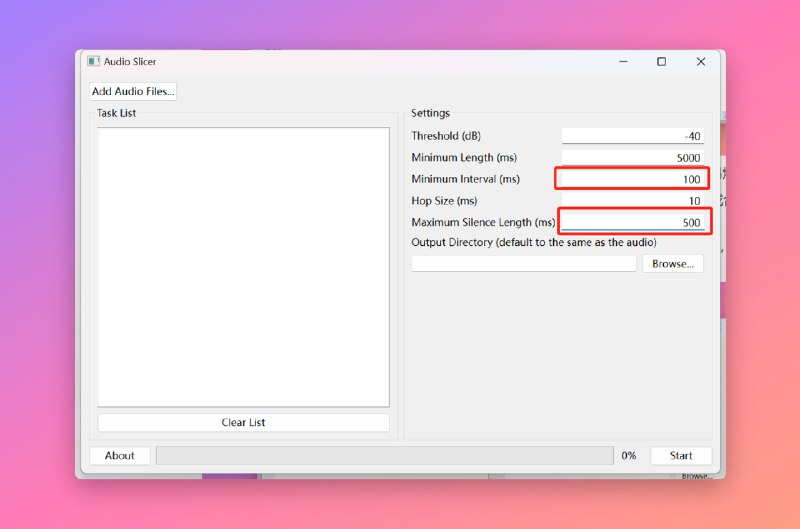
    如果你发现有几条素材比较大的话可以拖进slicer-gui里面重新分割一下,参数按我下面图片设置就行。

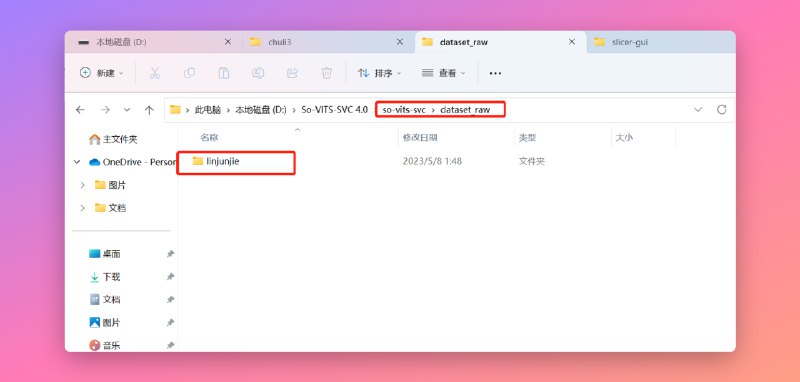
    所有数据处理好之后,我们准备开始训练了首先需要把准备好的素材移动到so-vits-svcdataset_raw这个文件夹下,注意不要直接把素材放在dataset_raw文件夹里,拿个文件夹装好放进去,所有的目录不要有中文字符。

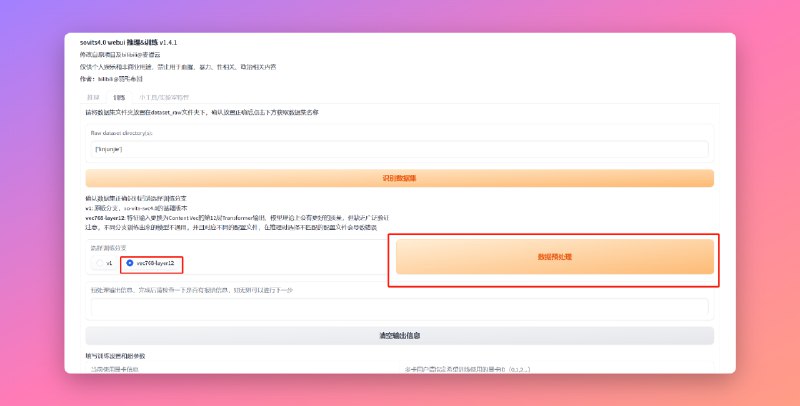
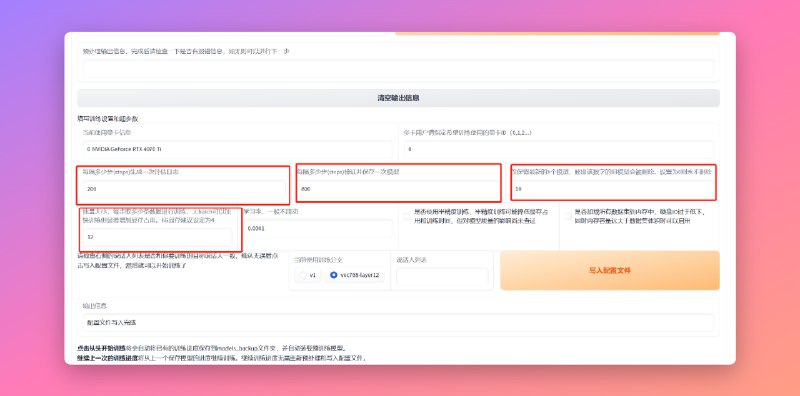
    我们开始模型训练,运行so-vits-svc根目录的【启动webui.bat】打开Web UI界面,切换到训练Tab下面。然后点击识别数据集,这时候上面就会展示你数据集文件夹的名字,也会是你模型的名字。

  2. 创新不是壁垒,数据、分发、优质产品才是壁垒

    创新不是壁垒,数据、分发、优质产品才是壁垒。

    Emad: While this article fits with much of our thesis I think it has a misunderstanding of what moats actually are

    It is v difficult to build a business with innovation as a moat, base requirement is too high

    Data, distribution, great product are moats
    https://www.semianalysis.com/p/google-we-have-no-moat-and-neither

  3. News Minimalist 是一个让 AI 精选新闻的服务

    News Minimalist 是一个让 AI 精选新闻的服务。
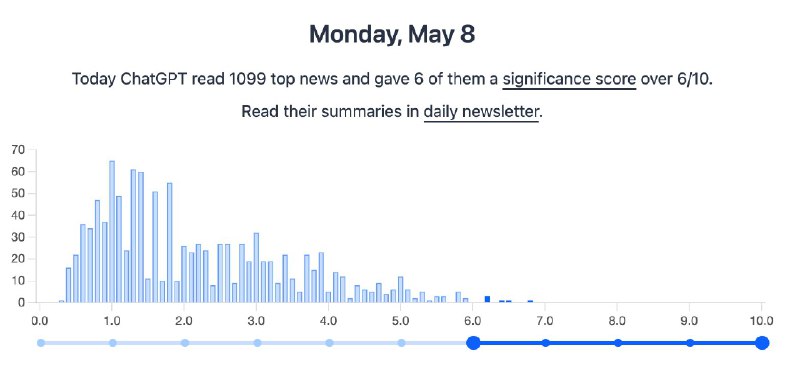
    它使用 AI (ChatGPT-4) 每天阅读前 1000 条新闻,并根据事件的严重性、规模、潜力和来源可信度,按重要性从 0 到 10 对它们进行排名。
    你可以选择一个适合自己的阈值,并订阅这个阈值内的 newsletter 。
    听起来很合理对不对?… https://twitter.com/i/web/status/1655714234385457152

  4. 虽然已经恢复了,但还是对一边要发展科技一边封杀科技的行为表示非常的疑惑…

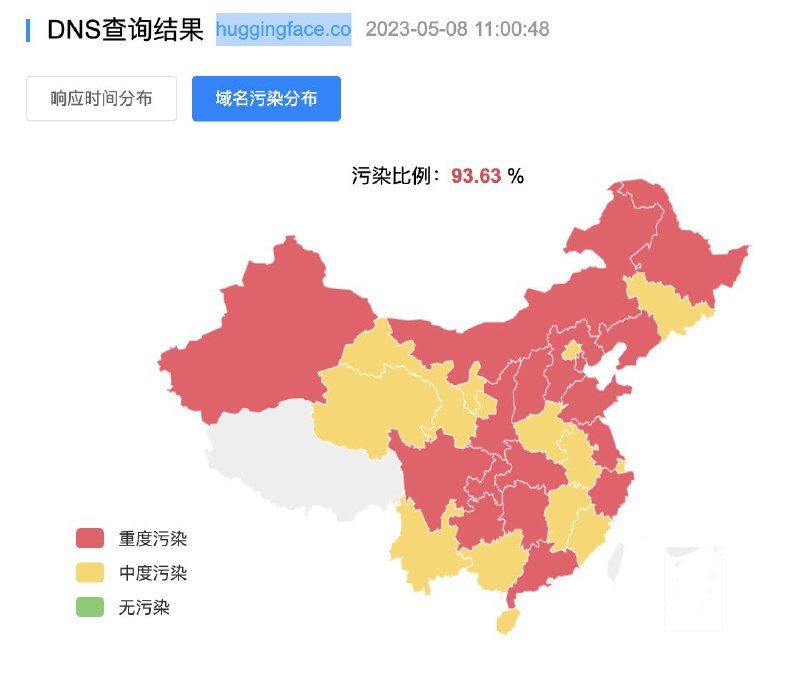
    虽然已经恢复了,但还是对一边要发展科技一边封杀科技的行为表示非常的疑惑…

    零零發: 从昨晚开始到现在,
    国内互联网监管是想对GPT类的各项开发和研究进行彻底的封锁吗?想不通这个逻辑何在。
    huggingface完全没有任何意识形态的问题,也不是一个讨论社区或者SNS社区,纯粹是个开发服务工具而已啊。

     http://huggingface.co

  5. RT 歸藏

    RT 歸藏
    手把手教你训练你自己的AI歌手,最重要的一步来了。如何训练歌手的模型。这一步主要由两部分组成数据处理和模型训练。
    这个林俊杰是我自己训练的4800步的模型,对比一下上一篇教程里的孙燕姿模型有两万多步,数据的质量也很重要。
    感谢各位的支持,下面是具体步骤🧶

  6. 昨晚和一位 OpenAi Candidate 的聊天,聊了 nerf, AI 3D, AI 动画, AI 服装模特… 是我近期信息量最大的对话了

    昨晚和一位 OpenAi Candidate 的聊天,聊了 nerf, AI 3D, AI 动画, AI 服装模特… 是我近期信息量最大的对话了。给我最大震撼的是,我们发现 AI 动画这个事学术界感兴趣的方向和工业界需要的竟然完全不一样。

    ▶ 对于工业界来说,img2img 比 txt2img 重要,因为业内的工作流程一直是从草稿细化到成品;而 txt2img 由于可控性太低,相对于 img2img 来说真的太低效了。

    制作电影/动画也是同理,讲故事的是视觉,分镜脚本是比剧本更重要的存在,一些 case 我们是直接跳过剧本直接写分镜脚本的(比如广告)。基础的工作流是:分镜脚本 -> 预演 -> 成片。

    放到 AI 时代的视角来看,从电影分镜到成片,本质是一种 style transfer. 不是给视频套一个滤镜的那种 style transfer,是真的改变画面内容 structure 的 style transfer. 而这就是 Gen-1 在干的事情。

    所以我们期待类似 Gen-1 的产品比期待 Gen-2 (txt2video) 要多很多,能预想到 txt2video 出来了以后融入实际工作流肯定会各种因为可控性太低而被各种诟病,但更完善更好的 Gen-1 可以很快地进入实际的工作生成中。

    ▶ 对于学术界来说,Gen-2 在技术含量上比 Gen-1 要有趣得多,带 structure 改变的 style transfer 是已经解决了很长一段时间的问题,Gen-1 的技术是没有秘密的。学术界的重心基本都铺在了 txt2video 上。

    我:@#¥%…&* I dont really give a damn to txt2video _(:ι」∠)_