AI探索指南
- 第一性原理的反面就是类比思维。
马斯克说:
在日常事务中应该使用类比推理,否则大脑会因为第一性原理思考而不堪重负。
但在做重大抉择时,类比推理无法摆脱传统和以往经验的枷锁,这种思考方式实属荒唐。
切记不要盲目跟风,运用物理学思维,从第一性原理出发进行思考,就可以避免犯错,这种方法极为强大,适用于生活的方方面面。
类比思维:电池一直很贵,电动车永远无法流行。
第一性原理:从原料看,电池可以非常便宜。
类比思维:以前的火箭都很贵,以后也会很贵。
第一性原理:从原料看,火箭的材料成本只有 1%-2%,完全可以做得很便宜。
—— 《马斯克原理》
@aigc1024 - 如何逼自己7天拿下AI视频创作?2026最新,50分钟入门AI视频制作!AI生成视频零基础入门保姆级教程,AI视频制作全流程教学!包含所有干货内容!赶紧存下吧!
AI探索 | Hermes/OpenClaw|优质资源|优质信息 - 赚钱的本质就四个字:创造,销售。
通过自己的劳动所获得的收入可以拆解为三个因素:专长、责任、杠杆。
专长,可以拆解为天分(没办法)和热爱(一万小时,100%的专注度)
责任,承担责任,才能建立可信度,才能获得更多的收益。
杠杆,人类在进化过程中,学会了相互信任,学会了合作,学会了利用资本,从而进入了杠杆时代。
杠杆可以拆解为,劳动力杠杆,资本杠杆,软件和媒体。
杠杆的另一面,是判断力的重要性,因为每一个决策质量的提升,都会被快速放大。
@aigc1024 - 这个马真的比机器人狗更让人小脑停摆
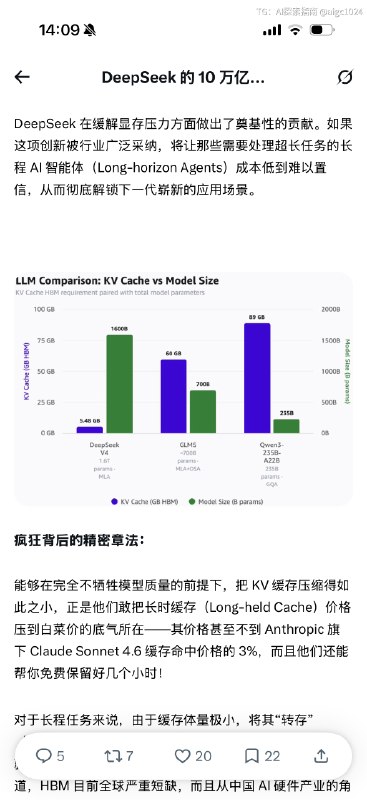
- 《DeepSeek 的 10 万亿美元大战略》
这篇文章的核心就是这一张图了
deepseek v4 pro 虽然不是最好的模型
但是缓存基本不要钱
这是所有大模型都需要的技术
opus 用这个技术成本都能下降10倍
同时相信 v4.1 有了真实的 harness 数据进行训练之后,一定会很快变好
@aigc1024 - 很多人说,中国房子跌了这么多了,可以抄底了。但,房价真的跌到位了吗?我觉得没有。最大的利空刚刚开始发酵,这个利空是——白领失业。
前段时间,Block裁员4000多人,占比40%,结果,股价大涨25%。“裁员”广进已经被反复验证了,根本原因是现在的AI确实已经强大到可以干活了。于是,未来必然会有越来越多的公司去裁员。大量白领丢工作后,房价会怎样,不言自明了吧。
除了要小心房价下跌,还要注意什么?AI趋势带来的不应该只是风险,还有红利,那怎么抓住AI带来的红利呢?欢迎观看视频。
AI探索 | Hermes/OpenClaw|优质资源|优质信息 - 说个暴论:下一个十年,属于一人公司(OPC)的时代,已经彻底来了。
传统创业的游戏规则,已经被AI和开源工具砸得稀碎。
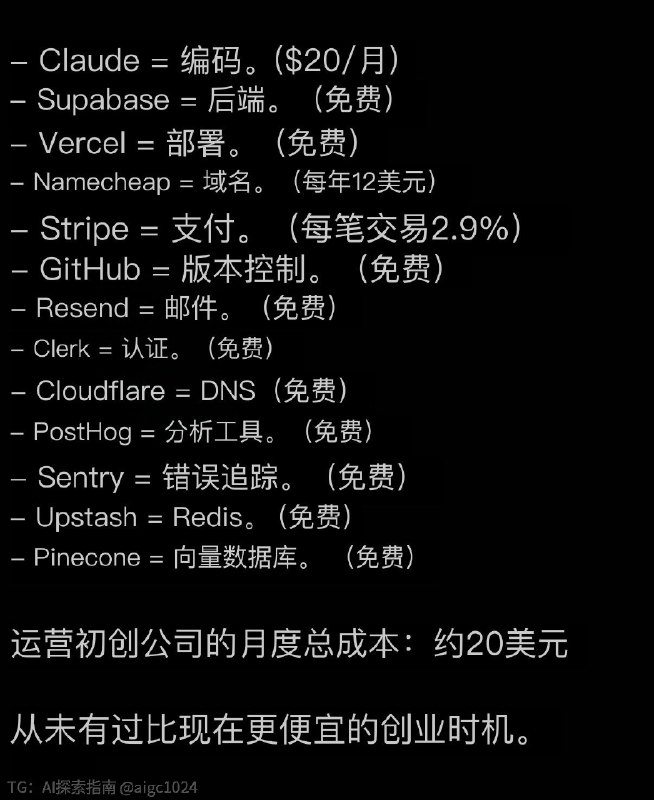
这张清单,就是一人公司的完整基建包,把一家互联网公司需要的全栈能力,给你列得明明白白:
• Claude:写代码,搞定全栈开发,每月20美元
• Supabase:后端服务,免费
• Vercel:部署上线,免费
• Namecheap:域名,每年12美元(平摊到每月1美元)
• Stripe:支付系统,按交易抽成2.9%
• GitHub:版本控制,免费
• Resend:邮件服务,免费
• Clerk:用户认证,免费
• Cloudflare:DNS解析,免费
• PostHog:数据分析,免费
• Sentry:错误监控,免费
• Upstash:Redis缓存,免费
• Pinecone:向量数据库,免费
算下来,一个人启动一家完整的、能跑通商业闭环的公司,每月固定成本只要约20美元。
以前你要开公司做产品,得先组团队、融资金、搭基建。开发、运维、产品、运营、财务,光人力成本一个月就要几十万,还没算服务器、软件的固定开销。
现在倒好,所有这些公司职能,全被AI和SaaS工具打包成了“一键即用”的服务,90%以上都是免费的。
你一个人,就是CEO、产品经理、全栈开发、运营、财务。
不需要融资,不用稀释股权,不用看投资人脸色;
不需要团队,不用搞管理内耗,不用应付办公室政治;
你只需要找到一个能解决用户痛点的需求,把产品做出来,然后收钱。
一人公司的核心,从来不是“一个人干所有活”,而是“一个人掌控所有的决策权和100%的利润”。
它不是小打小闹的副业,是未来十年,最适合普通人的商业形态。
以前创业,是你要凑齐所有条件,才能拿到入场券。
现在创业,是你只要敢动手,20美元就能开干。
从来没有哪个时代,能让一个普通人,用这么低的成本,完全掌控自己的全部商业价值。
你不需要再等别人给你机会,你自己,就是一家公司。
AI探索 | Hermes/OpenClaw|优质资源|优质信息 - 不用写一行代码也能做管理系统?这套AI开发流程让程序员都慌了
1.你打开ChatGPT,输入提示词:"帮我生成一个学生管理系统的Spring Boot项目代码" 2.你用Cursor打开生成的项目,自动修复报错,导入MySQL数据库 3.你启动前后端,测试增删改查功能
AI探索 | Hermes/OpenClaw|优质资源|优质信息
- 我发现中文圈没人提这个⬇️
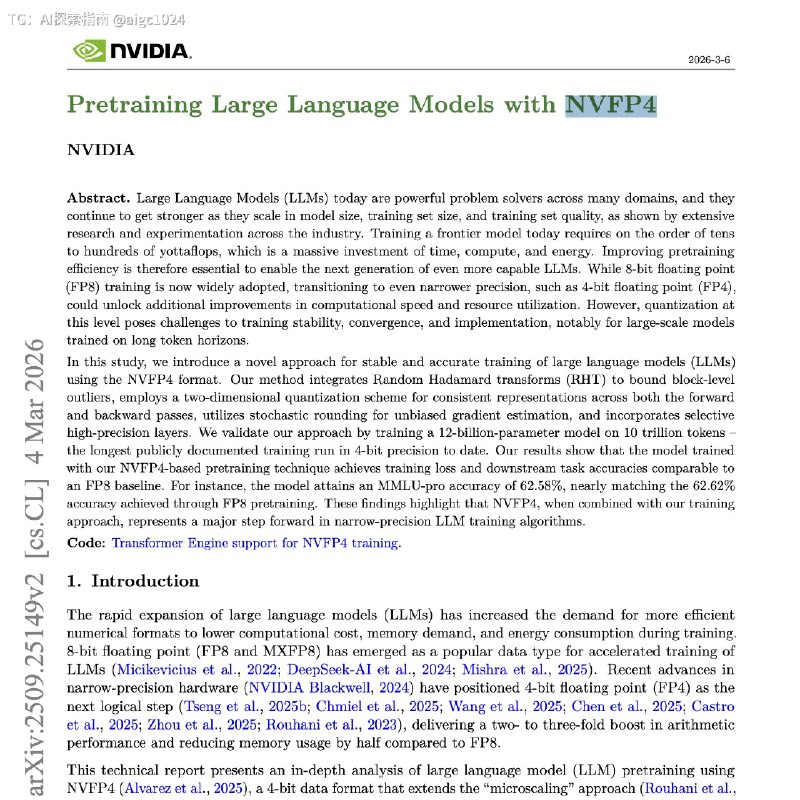
刚刚英伟达完成了一件很多人以为做不了的事。
他们用4bit精度,在10万亿tokens上,预训练了一个12B参数的大语言模型。
其实预训练方向一直陷入停滞很久了,过去几年,预训练基本被16bit和8bit统治。
你可以在推理阶段做4bit量化,可以省显存,可以让模型跑得更便宜。
但真拿4bit去做预训练,就是另一回事。
训练不是把模型压小然后跑起来。
训练是每一步都要算梯度,每一步都要更新参数,每一步都可能被数值误差放大。
精度降太狠,loss会飘,梯度会偏,它会变得不稳定,自己“幻觉”出错误的计算,最终崩溃。
但英伟达证明了“不可能”只是一个数学问。
他们使用了一种名为 NVFP4 的新格式,与标准结构不同,NVFP4 采用“微缩放”。
它不是粗暴地把所有数字砍成4bit,而是把数字切成很小的block,给每一小块单独配scale。
你可以理解成,以前是一把尺子量一整间屋子,现在是每一小格都有自己的尺子。
其结果是一次彻底的范式转变:
性能提升 2× 到 3×
内存使用减少 50%
最重要的是智能几乎无损
研究人员将该 4 位模型与庞大的 8 位基线进行了比较。曲线完全一致。
在 MMLU、GSM8K 和编程基准测试中,“微小”4 位版本的表现与更昂贵的模型相差不到 0.1%。
当然,它不是整个模型从头到尾全部纯4bit。
embedding、norm、attention相关部分、optimizer states这些地方,仍然有高精度保留。
但最重的那部分linear GEMM,已经可以被NVFP4接管,而且模型没有炸。
训练一个前沿模型过去需要数万块 GPU 和数月时间。NVIDIA 刚刚证明我们可以用一半的硬件和极少的电力得到相同的结果。
这对整个行业的意义很简单:
大模型训练不会因为算力贵就停下来。
英伟达正在把那张训练账单,一刀一刀往下切。
这会是一个非常颠覆的事情。
Paper:https://arxiv.org/abs/2509.25149
@aigc1024