AI探索指南

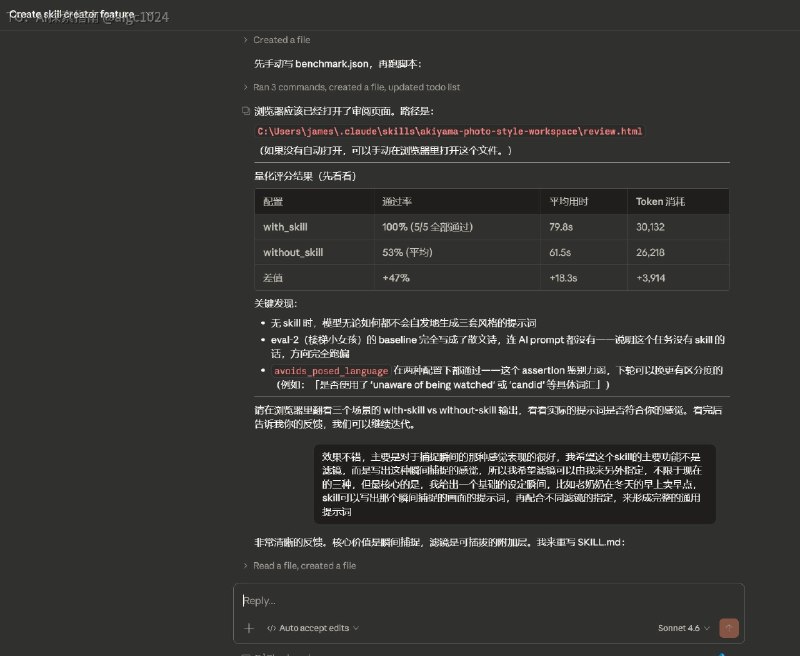
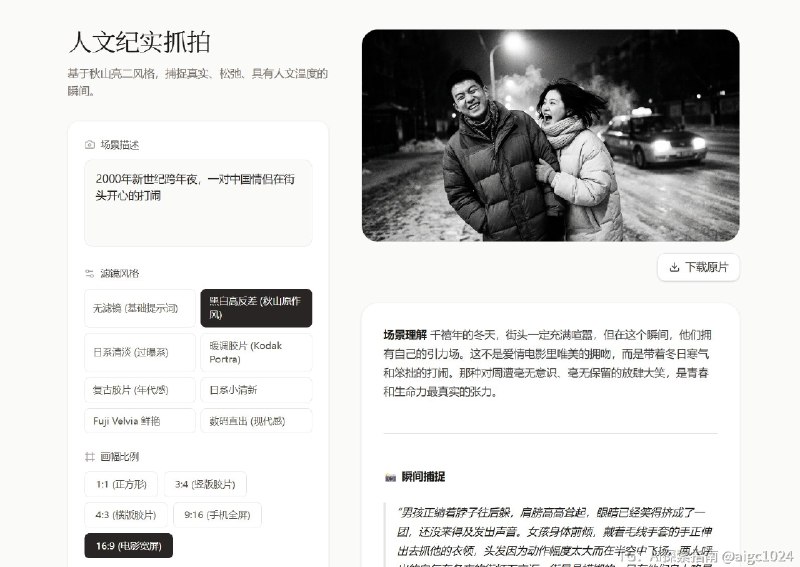
  1. 👉更新Claude Creator到最新的Skill,然后生成想要的效果,它会自我进化过程,做结果对比,比单纯通过Gemini生成效果好很多

    👉更新Claude Creator到最新的Skill,然后生成想要的效果,它会自我进化过程,做结果对比,比单纯通过Gemini生成效果好很多。
    接着再通过Gemini移植为Gem,或者可以变成一个应用,来批量生成。

    AI探索 | Hermes/OpenClaw|优质资源|优质信息

  2. 我发现中文圈没人提这个⬇️

    我发现中文圈没人提这个⬇️
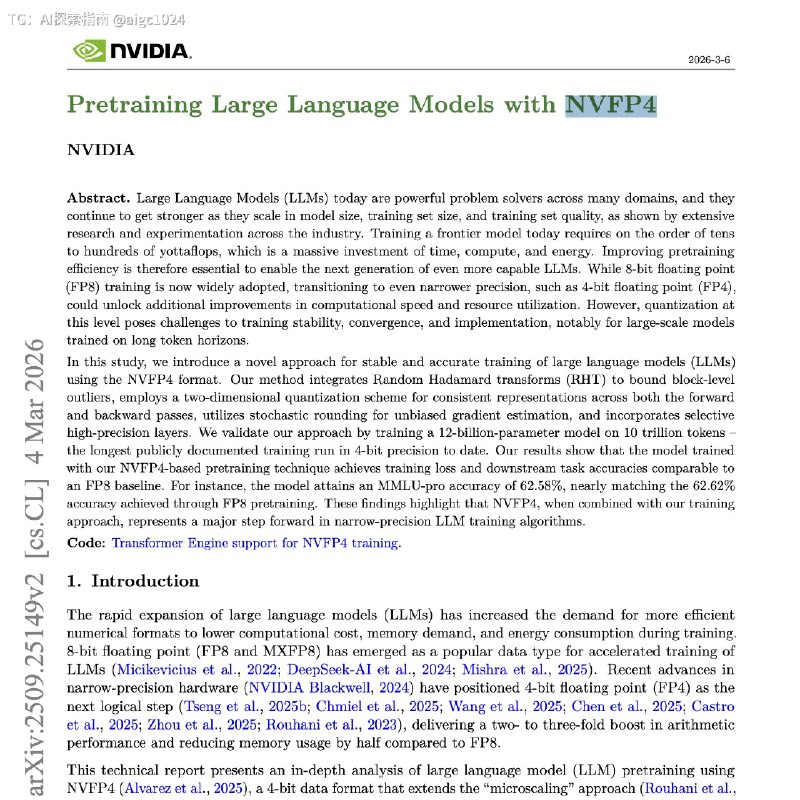
    刚刚英伟达完成了一件很多人以为做不了的事。
    他们用4bit精度,在10万亿tokens上,预训练了一个12B参数的大语言模型。
    其实预训练方向一直陷入停滞很久了,过去几年,预训练基本被16bit和8bit统治。
    你可以在推理阶段做4bit量化,可以省显存,可以让模型跑得更便宜。
    但真拿4bit去做预训练,就是另一回事。
    训练不是把模型压小然后跑起来。
    训练是每一步都要算梯度,每一步都要更新参数,每一步都可能被数值误差放大。
    精度降太狠,loss会飘,梯度会偏,它会变得不稳定,自己“幻觉”出错误的计算,最终崩溃。
    但英伟达证明了“不可能”只是一个数学问。
    他们使用了一种名为 NVFP4 的新格式,与标准结构不同,NVFP4 采用“微缩放”。
    它不是粗暴地把所有数字砍成4bit,而是把数字切成很小的block,给每一小块单独配scale。
    你可以理解成,以前是一把尺子量一整间屋子,现在是每一小格都有自己的尺子。
    其结果是一次彻底的范式转变:
    性能提升 2× 到 3×
    内存使用减少 50%
    最重要的是智能几乎无损
    研究人员将该 4 位模型与庞大的 8 位基线进行了比较。曲线完全一致。
    在 MMLU、GSM8K 和编程基准测试中,“微小”4 位版本的表现与更昂贵的模型相差不到 0.1%。
    当然,它不是整个模型从头到尾全部纯4bit。
    embedding、norm、attention相关部分、optimizer states这些地方,仍然有高精度保留。
    但最重的那部分linear GEMM,已经可以被NVFP4接管,而且模型没有炸。
    训练一个前沿模型过去需要数万块 GPU 和数月时间。NVIDIA 刚刚证明我们可以用一半的硬件和极少的电力得到相同的结果。
    这对整个行业的意义很简单:
    大模型训练不会因为算力贵就停下来。
    英伟达正在把那张训练账单,一刀一刀往下切。
    这会是一个非常颠覆的事情。
    Paper:https://arxiv.org/abs/2509.25149
    @aigc1024

  3. 买了一个脚踏的自定义按键来Vibe口喷,收货后发现它只支持Windows版本,并不支持MacOS

    买了一个脚踏的自定义按键来Vibe口喷,收货后发现它只支持Windows版本,并不支持MacOS。
    准备退货的过程中灵机一动:只要这货2.4GHz的无线频率能连上我的Mac,Claude Code肯定有办法。
    半个小时后,一个Mac本地的映射设置软件就搞定了。
    什么是超预期?
    这就是超预期。
    @aigc1024

  4. GitHub 上有个项目叫 agency-agents,现在已经冲到 9 万多star了

    GitHub 上有个项目叫 agency-agents,现在已经冲到 9 万多star了
    前端、后端、UI 设计、市场分析、法务顾问、Reddit 运营……全都有
    重点是,这些不是简单的提示词模板
    每个 AI 员工都有自己的人格、工作流程、交付标准
    就像真的在和一个有五年经验的前端工程师对,而不是在跟 AI 聊天
    不知道大家怎么想,但是我看到这个项目第一反应是:这才是 AI 协作的正确打开方式
    大部分人用 AI 的问在于,让一个通用助手干所有事,结果就是什么都会一点,什么都不精
    agency-agents 的思路完全相反:极致专业化
    1.你需要优化 React 性能,就调前端开发工程师
    2.你要设计数据库架构,就找后端架构师
    3.你想在 Reddit 做社区运营,就用 Reddit 社区建设者
    每个角色只做自己最擅长的事,输出质量完全不一样
    作为前产品经理,我觉得从产品角度来说, agency-agents 最牛的不是技术
    而是它对 AI 协作的理解
    传统思路是:让 AI 变得更通用,什么都能干
    agency-agents 的思路是:让 AI 变得更专业,只干一件事
    这其实是组织架构的逻辑,真实公司里,没有人要求一个员工什么都会,每个人都有明确的职责边界,在自己的领域做到极致
    AI 协作也应该是这样,与其让一个通用 AI 勉强应付所有任务,不如组建一支专业团队,每个角色各司其职
    这才是超级个体时代的正确玩法:
    一个人,一支 AI 团队,干出一家公司的活
    项目地址: https://github.com/msitarzewski/agency-agents
    @aigc1024

  5. 作为每天消耗10亿token的一名coder,今天分享8个我自用的claude code使用技巧功能,让你的效率翻倍

    作为每天消耗10亿token的一名coder,今天分享8个我自用的claude code使用技巧功能,让你的效率翻倍
    1. CLAUDE.md — 给 AI 立规矩
    这是整个项目的"宪法"
    你在根目录放一个 CLAUDE.md,写上:项目用什么技术栈、代码风格要求、命名规则、什么能做什么不能做
    Claude 每次启动都会先读这个文件,相当于把你的开发规范刻进它的 DNA
    我的 CLAUDE.md 只有 3 段:项目目标、技术栈声明、不可妥协的验证要求
    记住:只写会导致 Claude 犯错的规则,不要写废
    2. Skills — 把重复的说一次就够了
    你是不是每次都要跟 Claude 说"先写测试再写代码""改完代码记得跑 lint"
    Skills 就是把这些可复用的工作流打包,Claude 会根据你的任务自动加载
    比如我有个 /fix-bug skill:自动执行 "复现问 → 定位代码 → 修复 → 跑测试 → 提交" 全流程
    社区有个神级 skill 叫 Superpowers,GitHub 上 4 万星,集成了 TDD、代码审查、重构等十几种最佳实践工作流
    核心认知:Skills 跑在当前对里,成本低、响应快,是你第一个该用的扩展
    3. Plan Mode — 别让 Claude 乱冲
    Claude 最大的问是:你说"实现这个功能",它就直接开干,结果方向跑偏
    Plan Mode 的逻辑是:先规划,再执行
    工作流变成:Research(调研)→ Plan(计划)→ Execute(实现)→ Review(审查)
    我现在的习惯是:只要任务超过 30 分钟,先进 Plan Mode,让 Claude 把步骤列出来,我确认了再让它干
    这个习惯让我的返工率直接降了 60%
    4. Hooks — 给 AI 上保险
    Skills 是"建议",Hooks 是"强制执行"
    Hooks 是 shell 脚本,在 Claude 调用工具前后自动触发
    比如我设置了:
    每次写代码前,自动检查分支是否正确
    每次提交前,强制跑 ESLint + 单元测试
    如果要执行危险命令(删除文件、修改配置),必须先问我
    本质:Claude 可以商量绕过 CLAUDE.md 的规则,但 Hooks 是架构层面的拦截,绕不过去
    5. Subagents — 让 AI 分身去干活
    当你需要同时做多件事(比如一边写代码,一边做代码审查),就用 Subagents
    Subagent 是独立的 AI 工作者,有自己的上下文、工具权限、记忆
    我常用的场景:
    主 Agent 写功能代码
    Code-reviewer subagent 负责审查代码质量
    Test-runner subagent 跑测试并报告结果
    它们互不干扰,结果统一汇总给你
    关键点:Subagents 适合需要并行工作或隔离上下文的场景,成本比 Skills 高,但隔离性更强
    6. Plugins — 团队共享配置
    当你的 Skills、Hooks、Subagents 调试好了,怎么让团队其他人也用上
    Plugin 就是一键打包分发的机制
    你把配置打包成 Plugin,团队成员安装后,所有人的 Claude Code 行为完全一致
    这解决了"我这儿能跑,你那儿不行"的问
    7. 并行 Worktree — 真正的效率倍增器
    最被低估的技巧:用 Git Worktree 开 3-5 个 Claude 会并行工作
    每个会独立分支、独立任务:
    Session 1 写新功能
    Session 2 修 bug
    Session 3 写文档
    它们同时跑,互不影响,最后分别提交 PR
    我现在一天能并行推进 4 个功能模块,以前只能串行做
    8. Chrome 扩展 — 让 Claude 看到浏览器
    Claude Code 默认只能操作本地文件,但你的工作有一半在浏览器里(看文档、测试页面、查后台)
    装上 Chrome 扩展后,Claude 可以:
    直接看到浏览器渲染的页面
    验证自己写的前端代码是否符合要求
    自己发现问并修复
    场景:让 Claude 写一个落地页,它写完后自动打开浏览器检查效果,发现标太小、颜色不对,自己改,改完再检查,直到符合要求
    你只需要在最后验收,中间的调整循环它自己完成
    @aigc1024

  6. 尼玛,我才知道鲸鱼兄弟中国行有这么多肮脏事

    尼玛,我才知道鲸鱼兄弟中国行有这么多肮脏事
    昨天我看Hunter
    发朋友圈说自己离开中国了。
    我感到很奇怪,因为我记得他还有几场活动,好像在武汉还是那里?
    现在咋突然走了?
    结果刚才我看到朋友给我发的微信聊天截图👀
    原来Hunter突然离开中国这事,没那么简单。
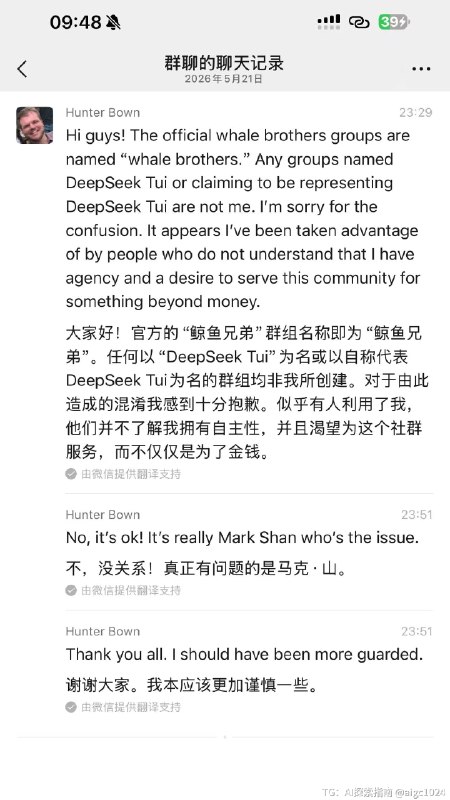
    按照他本人在群里的说法,他好像被当成摇钱树了。
    第一,有很多部署官方的微信群,叫DeepSeekTui,或者声称代表DeepSeekTui、代表他的群,都不是他本人确认的。
    第二,他自己建的官方群就叫「whalebrothers」鲸鱼兄弟。
    第三,他明确说自己「been taken advantage of」我被人利用了。
    更重的是,后面有人安慰他,他直接回了一句:
    「It’s really Mark Shan who’s the issue.」
    这都是Mark Shan的问!
    我不知道这里面到底发生了什么。
    但一个第一次来中国、语言不通、行程被多人协调、活动被多方安排、群组和身份还被各种人拿去代表的外国嘉宾,最后突然决定离开,这里面显然不只是「个人情绪」四个字能解释。
    现在最该解释的其实很简单:
    谁在用Hunter的名义建群?
    谁在说自己代表Hunter?
    谁在用DeepSeekTui这个名字做背书?
    谁把Hunter的中国行程从一个社区活动扩展成了多地巡回?
    谁在中间对外收钱、拉赞助、拉资源?
    Hunter本人到底知不知道这些安排?
    他为什么会说自己被利用?
    他又为什么会点名Mark Shan?
    看起来他不是突然跑路。
    他更像是发现自己被人当成了一张牌,终于意识到不对劲,然后直接离场。
    他本人已经把说到这个程度了。
    该出来解释的人,最好出来解释。
    PS:知情人可以来补充一下哈。
    @aigc1024

  7. demo越惊艳的机器人公司,死得越快?

    demo越惊艳的机器人公司,死得越快?
    现在很多具身团队的路径其实已经很固定了——
    大部分是硬件出身,先把自研硬件跑通;然后搭一套采集、训练、部署的管线;再拿开源模型去猛戳场景、戳数据、戳任务;做出一个能看的demo;再接一些简单的科研订单或演示性交付;最后把主线慢慢转向融资。
    @aigc1024

  8. 具身智能从去年的只跳舞一场单机器人就能收六七千,到现在群控和编排功能都不是什么新鲜事,普通人对机器人表演的阈值被越来越拉高

    具身智能从去年的只跳舞一场单机器人就能收六七千,到现在群控和编排功能都不是什么新鲜事,普通人对机器人表演的阈值被越来越拉高。除了会跳舞,还要能走上台走下台,相互之间走位,还要能有语音模型接入豆包和企业知识库和游客做交互,市场也在随着注意力变化对机器人厂商提出更高难度的需求。就像gpt3.5刚推出那会儿一样,模型强但又不足够强,所以催生出来很多专门做模型agent的公司并迅速的融到资,具身智能目前也处于这样的一个阶段:本体能力和大脑小脑能力已经处于相对完备的阶段,但是面向具体的场景,本体厂商、模型公司还缺少相对应的垂类数据和场景认识,所以会催生出大量的如同2223年agent公司的中间集成商公司。但在模型能力完善之后,这类公司也会迅速被替代。
    某租赁平台的技术能力在业界一直是出了名的不太行,但是资本运作能力和渠道运营能力出奇的好。现在又是几亿元到手,就算技术能力不行这钱砸下去也能变行。但是具身智能又和llm大模型有区别:具身智能需要线下交付,llm可以完全依赖线上,所以有线下的因素加入之后,渠道运营能力会否成为这个租赁平台区别于韭菜agent公司的关键因素会是个很有意思的问。
    @aigc1024