AI探索指南

  1. 这种情侣互动视频应用Seedance2.0 生成效果太好了!感觉女朋友要扑过来了😂

    这种情侣互动视频应用Seedance2.0 生成效果太好了!感觉女朋友要扑过来了😂
    要有更好的效果,我觉得要提示词有几个要点:
    1.第一人称男生视角,有种身临其境的感觉
    2.微表情、眼神都能够大大增加亲密互动的体验感
    3.像写小说一样写提示词,心理和动作越细腻,越真实
    Seedance2.0提示词👇
    第一人称男生视角,客厅沙发上,一位年轻女性(面部形象参考
    主视角坐在她身旁,看着她放松的样子,忍不住伸手轻轻碰了碰她的小腿,指尖刚触到皮肤——
    她瞬间浑身一颤,手机差点掉落,猛地转过头瞪大眼睛看向观看者,眼神中闪过一丝惊慌和意外,嘴巴微微张开,像是被吓到。
    然而下一秒,她表情骤然变化。嘴角慢慢勾起,眼睛微微眯起,露出一抹意味深长的邪笑。她缓缓放下手机,坐直身体,盯着观看者的眼神像是发现了什么有趣的事。
    还没等主视角反应,她突然身体前倾,直接朝观看者身上扑了过来。双手按在观看者胸口,整个人压了上来,将观看者推倒在沙发靠背上。她近距离盯着观看者的眼睛,笑意更深。
    主视角被这突如其来的动作弄得手足无措,身体僵住,双手悬在半空不敢碰她,慌乱地开口:“等、等一下……你误会了,我没那个意思……”
    她只是笑着凑近,一言不发。
    场景是客厅,暖色调家居灯光,浅景深,焦点集中在她的表情变化和扑过来的动作上,使用写实风的画面风格生成素材。胶片颗粒感, 增强光影对比度, 画面细节重塑, 消除数码噪声。

    AI探索指南 | Hermes爱马仕 & OpenClaw小龙虾🦞

  2. https://mp.weixin.qq.com/s/LEbdg5gktwJjAYU7hQ4whg

    π0.7:复刻LLM的关键时刻
    π0.7是 PI 第一次在论文里展示,机器人能做"训练数据里完全没有"的任务。
    核心概念是 compositional generalization(组合泛化)——"组合泛化是指把在不同情境下学到的技能组合起来,去解决模型从未见过的问题的能力"。"在此之前,机器人训练的标准做法本质上就是死记硬背——为某个特定任务收集数据,训练一个专门模型,然后对每个新任务重复这个过程。π0.7 打破了这个模式"。
    最有说服力的实验:跨机器人本体的零样本迁移。用 A 机器人(小型、灵活)的叠衣服数据训练,让 B 机器人(重型工业臂、惯量大、夹爪不精准)零样本叠衣服并成功。这相当于一个人只看过别人用筷子吃饭,自己就直接能用刀叉吃饭——动作模式完全不一样,但"叠衣服"这个抽象概念被模型学会了,并且能映射到完全不同的"身体"上。
    PI 自己的措辞非常克制——这是好的科学态度,但也意味着别过度兴奋:"论文本身全程使用谨慎措辞,把 π0.7 描述为展现了泛化的'早期迹象'和新能力的'初步演示'。这些是研究结果,不是已部署的产品"。
    下一波要看的是:(1)开源后第三方能不能复现;(2)在真实部署里(不是实验室)的成功率;(3)下一代 π1 出来时这个泛化能力是继续涨还是平台化。

  3. π0.7:复刻LLM的关键时刻

    π0.7:复刻LLM的关键时刻
    π0.7是 PI 第一次在论文里展示,机器人能做"训练数据里完全没有"的任务。
    核心概念是 compositional generalization(组合泛化)——"组合泛化是指把在不同情境下学到的技能组合起来,去解决模型从未见过的问题的能力"。"在此之前,机器人训练的标准做法本质上就是死记硬背——为某个特定任务收集数据,训练一个专门模型,然后对每个新任务重复这个过程。π0.7 打破了这个模式"。
    最有说服力的实验:跨机器人本体的零样本迁移。用 A 机器人(小型、灵活)的叠衣服数据训练,让 B 机器人(重型工业臂、惯量大、夹爪不精准)零样本叠衣服并成功。这相当于一个人只看过别人用筷子吃饭,自己就直接能用刀叉吃饭——动作模式完全不一样,但"叠衣服"这个抽象概念被模型学会了,并且能映射到完全不同的"身体"上。
    PI 自己的措辞非常克制——这是好的科学态度,但也意味着别过度兴奋:"论文本身全程使用谨慎措辞,把 π0.7 描述为展现了泛化的'早期迹象'和新能力的'初步演示'。这些是研究结果,不是已部署的产品"。
    下一波要看的是:(1)开源后第三方能不能复现;(2)在真实部署里(不是实验室)的成功率;(3)下一代 π1 出来时这个泛化能力是继续涨还是平台化。

  4. AI图片相关的提示词网站我收藏过不少,也用过很多,但

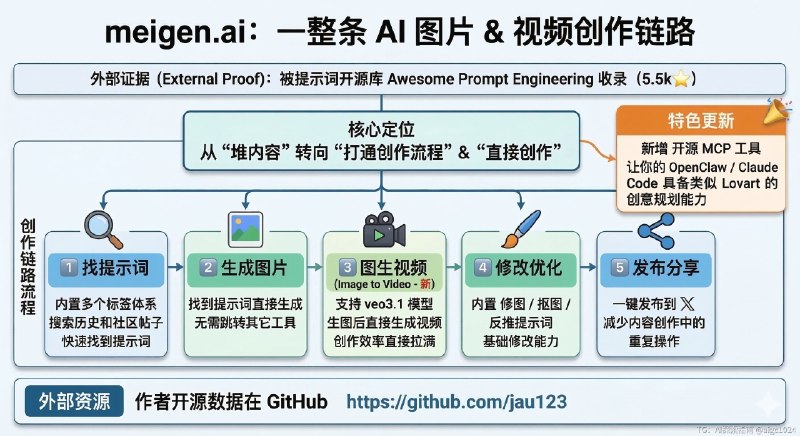
    AI图片相关的提示词网站我收藏过不少,也用过很多,但 http://meigen.ai 是目前我仍然在高频使用的一个开源网站。
    前段时间,它刚被提示词开源库 Awesome Prompt Engineering(5.5k⭐) 收录,这就足以证明它的优秀
    但我真正喜欢它的原因,其实不是“提示词多”,而是它把整个创作流程打通了。很多提示词网站只是在“堆内容”,而 MeiGen做的是一整条创作链路:
    找提示词 → 生成图片 → 修改优化 → 发布分享
    整个流程几乎没有卡点。
    这次更新之后,它甚至把AI图片创作 → AI视频创作也打通了。新增 veo3.1 模型,做完图之后可以直接图生视频,创作效率直接拉满。
    另外还有一个很有意思的更新:新增开源 MCP 工具,可以让你的 OpenClaw / Claude Code 具备类似 Lovart 的创意规划能力。
    如果你经常做 AI 图片创作,你应该能理解这种感觉:从灵感到成品,一路丝滑。
    使用 MeiGen 的创作流程基本是这样的:
    1️⃣ 内置多个标签体系,可以搜索历史和社区帖子,快速找到想要的提示词
    2️⃣ 找到提示词后可以直接生成图片,无需跳转其它工具
    3️⃣ 支持 veo3.1 模型,生成图片后可以直接图生视频
    4️⃣ 内置 修图 / 抠图 / 反推提示词 等基础修改能力
    5️⃣ 一键发布到 𝕏,减少内容创作中的重复操作
    可以说 MeiGen 把 AI 图片创作从“找工具”变成了“直接创作”。
    作者的所有开源数据,都可以在👉https://github.com/jau123 中可以找到

    AI探索指南 | Hermes爱马仕 & OpenClaw小龙虾🦞

  5. 小时候梦想走进现实转场🎫

    小时候梦想走进现实转场🎫
    Seedance 2.0全能参考视频 prompt 👇
    1人出镜,
    0.0-4.0秒:
    超低机位贴地微距,午后暖金阳光照亮米色毛绒地毯,尘埃粒子漂浮,复古柯达胶片暖黄调。
    小时候的
    镜头紧贴玩具车车头高速滑行跟拍,模拟真实赛车第一视角,速度越来越快,童年想象力被彻底点燃。
    4.0-5.5秒:
    玩具车径直冲入沙发底部黑暗阴影,光线骤灭,地毯纹理拉成放射状速度残影,整个画面被黑暗吞没。
    利用冲入阴影的遮挡动作完成无缝转场,形成从童年到现实的时空跃迁。
    5.5-9.0秒:
    黑场中引擎轰鸣炸开,真实红色保时捷911 GT3从黑暗中咆哮冲出,赛道冷灰,天光锐利,车漆反光凌厉,轮胎卷起热浪与轻微烟尘。
    镜头保持与前一镜完全一致的贴地高速跟拍,像同一辆车从玩具尺寸直接变成真实赛车,视觉震撼强烈,物理速度感真实凶猛。
    9.0-12.0秒:
    切入车内极限特写,成年
    镜头猛然上摇推近,定格头盔下
    车内空间快速摇摄,震动强烈,压迫感拉满,最后以眼神高潮定格收尾。
    负面:
    模糊,低清,人物变形,多人,手部错误,车型错误,跳切,转场生硬,卡顿,掉帧,塑料质感,假车感,过度特效,动漫感,廉价滤镜,脸部不稳定,年龄衔接混乱。

    AI探索指南 | Hermes爱马仕 & OpenClaw小龙虾🦞
  6. 这个 GitHub 的视频自动剪辑工具 AutoClip,我先 fork 了

    这个 GitHub 的视频自动剪辑工具 AutoClip,我先 fork 了。
    完全就是一个 AI 剪辑师。
    丢一个 YouTube / B站视频链接进去,
    AI 会自己:
    -下载视频
    - 分析内容
    - 找出精彩片段
    - 自动剪成多个短视频
    - 甚至顺手把标都写好
    也就是说——
    一条长视频 → 自动变成一堆短视频素材。
    特别适合:
    - 直播回放拆短视频
    - 播客剪高光
    - 访谈剪金句
    - 课程拆知识点
    做内容矩阵的人,应该一眼就懂这个价值。
    很多人做短视频最累的其实不是拍,
    而是 一点点拖时间轴剪片段。
    这个项目就是把这一步
    直接全自动化了。

    AI探索指南 | Hermes爱马仕 & OpenClaw小龙虾🦞