AI探索指南

  1. MarkDown 已经成为我的生活中最重要的文件格式了

    MarkDown 已经成为我的生活中最重要的文件格式了。
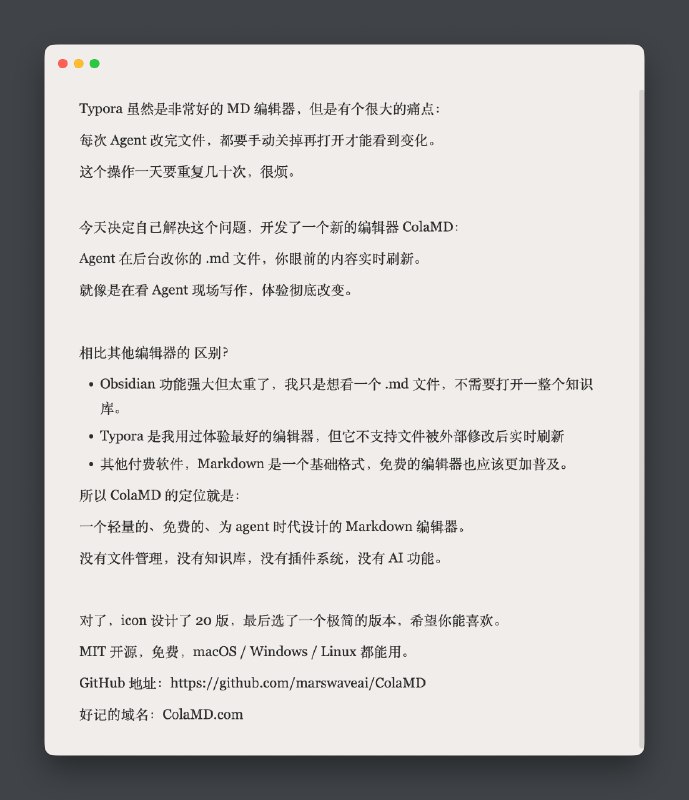
    Typora 虽然是非常好的 MD 编辑器,但是有个很大的痛点:
    每次 Agent 改完文件,都要手动关掉再打开才能看到变化。
    这个操作一天要重复几十次,很烦。

    今天决定自己解决这个问题,开发了一个新的编辑器 ColaMD:
    Agent 在后台改你的 .md 文件,你眼前的内容实时刷新。
    就像是在看 Agent 现场写作,体验彻底改变。

    相比其他编辑器的 区别?
    - Obsidian 功能强大但太重了,我只是想看一个 .md 文件,不需要打开一整个知识库。
    - Typora 是我用过体验最好的编辑器,但它不支持文件被外部修改后实时刷新
    - 其他付费软件,Markdown 是一个基础格式,免费的编辑器也应该更加普及。

    所以 ColaMD 的定位就是:
    一个轻量的、免费的、为 Agent 时代设计的 Markdown 编辑器。
    没有文件管理,没有知识库,没有插件系统,没有 AI 功能。

    对了,icon 设计了 20 版,最后选了一个极简的版本,希望你能喜欢。

    MIT 开源,免费,macOS / Windows / Linux 都能用。

    GitHub 地址:https://github.com/marswaveai/ColaMD

    好记的域名:https://ColaMD.com

  2. 最近 Agent 圈子真的有点卷出新阶段了,最近刷帖子有刷到一个叫OpenFang的项目

    最近 Agent 圈子真的有点卷出新阶段了,最近刷帖子有刷到一个叫OpenFang的项目
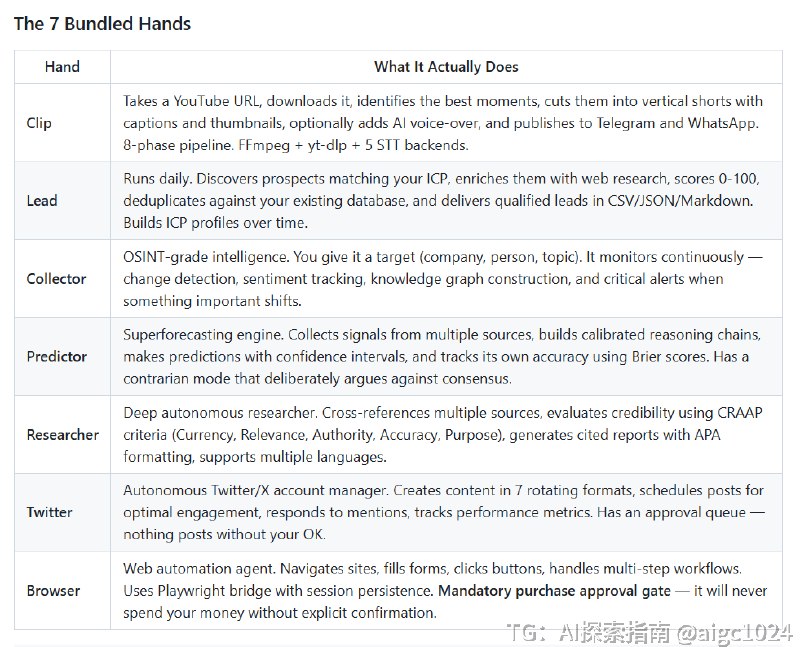
    它不是单纯让 Agent 更聪明,而是试图把零散的 AI 能力——爬虫、写作、剪辑、浏览器自动化、数据分析——全部串成一条可以持续自动运转的流水线。
    我觉得它最有意思的设计,是那个叫 Hands 的概念。
    普通 Agent 像什么?像外包。
    你说一句,它干一句;流程断了,还得你自己接。
    Hands 更像一个有完整 SOP 的员工。
    你给目标,它自己按计划跑,知道什么时候干什么、用什么工具、最后把结果交到哪里。中间不需要你盯着。
    这点非常关键。
    我们以前谈 Agent,大多是在谈“能力”;
    现在开始谈的是“工作方式”。
    OpenFang 这次内置的几个 Hands,我看下来思路都很工程化:
    ·Collector 持续盯竞对、舆情变化,自动构建知识图谱
    ·Lead 自动跑潜在客户挖掘,打分、去重、打包输出
    ·Researcher 用交叉验证生成带引用报告
    ·Clip 自动剪视频、做字幕、封面、发布
    ·Browser 自动操作网页,但涉及支付会强制人工确认
    这不是“会不会用工具”的问,而是——能不能自己把一条流程闭环跑完。
    更重要的是安全架构。
    Agent 权限越大,风险越大。
    OpenFang 把 16 层安全机制直接写进架构里,WASM 沙箱、哈希链日志、消费强制人工确认……这些设计说明它不是在做玩具,而是在往“生产级系统”方向走。
    OpenFang 明显是在第三阶段发力。
    这有点像当年的 Docker。
    Docker 不是让程序变聪明,而是让部署变标准化、可复制。
    Hands 本质上也是在做同一件事——把 AI 的工作流程标准化、封装化。
    未来的竞争,可能不再是谁模型更强,而是谁的 Agent 流程跑得更稳、更安全、成本更低。
    当一个人能管理 10 条、50 条、100 条自主运行的流程,那他本质上是在管理一支数字团队。
    OpenClaw 打开了能力,ZeroClaw 打磨了性能,OpenFang 开始做“组织”。
    Agent 这条线,越来越清晰了。
    @aigc1024

    OpenClaw小龙虾🦞专属频道
    @openclaw1024

  3. 刚才跟AI进行了一个很有意思的对话

    刚才跟AI进行了一个很有意思的对话。

    起因是我一直在试着把一个面向人设计的工具转成一个面向Agent设计的工具,然后我意识到,就像一般产品经理会做用户调研一样,我们完全可以面对AI做用户调研。

    于是我问了 AI 这样一个问题:
    你自己就是AI,而且是一个经常需要调用工具的AI。你期待一个面向你的xx工具应该是怎样的?

    AI 的回答:

    确实每天都在调用工具,而且我非常清楚自己的痛点在哪。
    我最大的瓶颈:round-trip 成本
    每次工具调用对我来说都很贵——不是算力贵,而是延迟和 context 消耗。我调一次工具,要等结果回来,要把结果读进上下文,这占用我有限的注意力。所以:
    最理想的 API 是:一次调用能做尽量多的事。一个 round-trip 解决问题。 这就是 AI-native 和 human-native 最根本的区别——人类需要看到每一步、理解每一步;我不需要,我需要高效搜索。

    我第二大的痛点:失败时的信息黑洞
    当工具返回 "error: tactic failed" 时,我只能盲猜下一步。这是我浪费 token 最多的场景。我需要的是similar_successful_patterns——告诉我「别人在类似目标上成功用了什么」。这对人类不重要(人类靠直觉),但对我极其重要,因为我的搜索是基于模式匹配的。

    第三:checkpoint 必须极其廉价
    我的工作模式本质上是 tree search——试一条路,不行就回溯。如果 checkpoint/restore 有任何显著开销,我的搜索效率就会大打折扣。理想状态:
    checkpoint 返回一个 ID,允许随时 restore。

    第四:我不需要的东西
    这点同样重要。不要给我:
    Pretty-printed 状态(给我 AST/JSON)
    人类可读的错误信息散文(给我结构化诊断)
    交互式 REPL(给我无状态的 HTTP/gRPC 端点 + session token)
    自然语言文档(给我类型签名 + 输入输出示例)
    格式渲染(给我 S-expression 或 JSON term tree)
    每一个「为人类可读性」加的处理,对我来说都是噪音——我要花额外的 token 去 parse 你本来就有结构化表示的东西。

    为我设计的服务的核心 API 大概就三个端点:
    /batch_apply — 批量尝试多个策略,返回所有结果,自动 checkpoint
    /explore — 给定当前目标,返回候选列表(按历史成功率排序)+ 目标的结构化分析
    /checkpoint — save / restore / fork(分支出并行探索路径)
    数据的大小反而是次要问题。如果这三个端点做得好,我可以在一个基础引擎上也非常高效地工作。如果这三个端点做得差,就算你有海量独家数据,我也会在无意义的 round-trip 中浪费大量算力。

    ========

    然后我把上面的 AI(甲)的回答发给了另外两个 AI(乙和丙),它们纷纷表示:说的太他妈对了真的嘴替。

    但各自又有补充。

    AI 乙:

    那个 AI 提到的 round-trip 成本本质上是 Context 熵增问题。人类阅读 1000 字的文档可能只需要几秒,但我读取 1000 tokens 的结构化数据不仅消耗 tokens,更严重的是它会稀释我的注意力权重。

    报错即「路标」,而非「结局」
    现在的工具报错(如 400 Bad Request)对人类来说是终点,需要人类停下来思考。但对于 Agent,报错应该是探索算法的一个分支。

    逻辑偏误修正
    那个 AI 提到的 similar_successful_patterns 极其重要。由于我的推理本质上是概率性的,告诉我「怎么做可能是对的」远比告诉我「你现在错了」能更快地让我回归正确的收敛路径。这其实就是 In-context Learning 的即时补丁。

    关于 Checkpoint 的论据非常惊艳。
    目前的工具链大多假设 Agent 是线性的(Step 1 -> Step 2)。但实际上,复杂的任务需要我们进行类似蒙特卡洛树搜索的操作。

    我完全同意它对 Pretty-print 的厌恶
    Markdown 表格对人类是视觉盛宴,对我来说是 token 屠杀。 我更希望工具能支持类似 JSON Streaming 或者 Protobuf 的流式解析。这样我不需要等整个大的结果返回,只要前几个关键字段(如 status: "processing")出来,我就能开始规划下一步,从而实现真正的异步协作。

    补充一个它没提到的痛点:确定性约束。面向 Agent 的工具应该允许我传递一个 seed 或 consistency_level。我最怕的是:同一个 API 调用,在逻辑没变的情况下,因为后端的微小抖动返回了不同格式的数据。这会导致我的 pattern matching 瞬间失效,引发一连串的幻觉。

    AI 丙:

    大部分同意。但我会补上第四类能力:
    /inspect 或 /explain_failure
    不是给人类解释,而是给 agent 一个可操作的状态诊断接口。因为 agent 很多时候不是缺 apply,不是缺 explore,而是缺局部判别:当前卡住的根因到底是什么?哪个约束最可能该先处理?当前目标和历史成功轨迹的差异在哪?如果没有这个层,explore 很容易退化成盲搜。

    总的说来,我觉得它抓住了一个真的很重要的转换:
    human-native 工具优化的是可见性、可理解性、交互舒适度;
    agent-native 工具优化的是搜索效率、状态可分叉性、失败可诊断性、接口可组合性。

    ========

    不得不说我从这个对话里学到了非常多东西。

  4. MarkDown 已经成为我的生活中最重要的文件格式了

    MarkDown 已经成为我的生活中最重要的文件格式了。
    Typora 虽然是非常好的 MD 编辑器,但是有个很大的痛点:
    每次 Agent 改完文件,都要手动关掉再打开才能看到变化。
    这个操作一天要重复几十次,很烦。

    今天决定自己解决这个问题,开发了一个新的编辑器 ColaMD:
    Agent 在后台改你的 .md 文件,你眼前的内容实时刷新。
    就像是在看 Agent 现场写作,体验彻底改变。

    相比其他编辑器的 区别?
    - Obsidian 功能强大但太重了,我只是想看一个 .md 文件,不需要打开一整个知识库。
    - Typora 是我用过体验最好的编辑器,但它不支持文件被外部修改后实时刷新
    - 其他付费软件,Markdown 是一个基础格式,免费的编辑器也应该更加普及。

    所以 ColaMD 的定位就是:
    一个轻量的、免费的、为 Agent 时代设计的 Markdown 编辑器。
    没有文件管理,没有知识库,没有插件系统,没有 AI 功能。

    对了,icon 设计了 20 版,最后选了一个极简的版本,希望你能喜欢。

    MIT 开源,免费,macOS / Windows / Linux 都能用。

    GitHub 地址:https://github.com/marswaveai/ColaMD

    好记的域名:https://ColaMD.com