AI探索指南

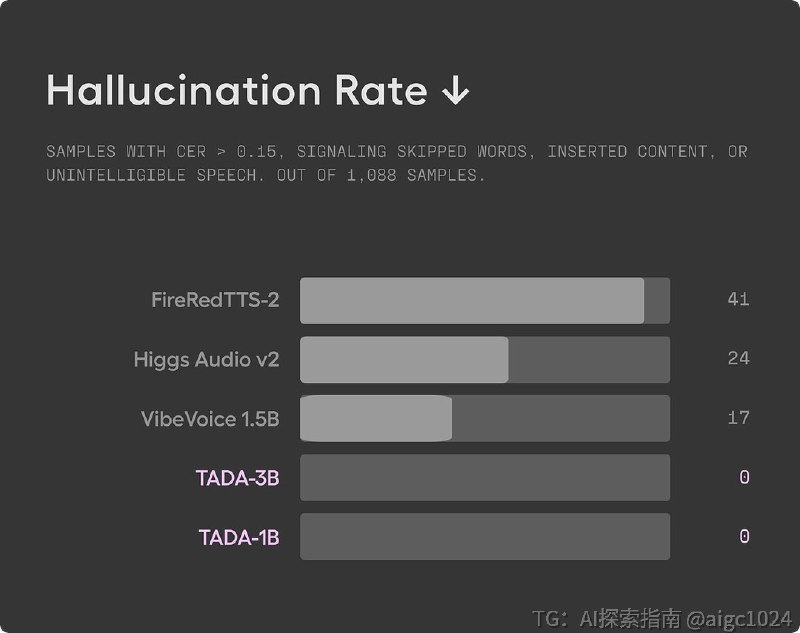
  1. Hume AI 这次开源的 TADA,换了一个更务实的方向:先把不出错、够快、够轻这三件事做到极致

    Hume AI 这次开源的 TADA,换了一个更务实的方向:先把不出错、够快、够轻这三件事做到极致。
    传统 LLM 做 TTS,一个很大的麻烦就是:文字信息很少,但音频帧特别多,最后就容易上下文爆炸、推理变慢,甚至模型越说越跑偏。
    TADA 的解法很直接,就是尽量让文字和语音“一对一锁住”往前走。你可以简单理解成,它不是先想好一大段声音再慢慢往外吐,而是每读一个 token,就同步生成对应那一小段语音。
    这样做的好处非常现实:速度更快、内存更省,而且从结构上就更不容易胡说八道。我觉得这类设计比单纯堆参数、堆数据更有意思,因为它是在真正解决架构层面的老问。
    两个特点:
    第一是它够轻,甚至能往手机、边缘设备上放,这意味着以后很多语音能力不一定非要走云端 API,端侧跑起来后,延迟、隐私、成本都会好很多。
    第二是它开源得比较彻底,MIT 协议,商用限制也少,这种东西一出来,开发者社区肯定会很快接上,后面不管是 AI 助手、播客生成、有声书、视频配音,还是需要同步字幕的场景,都会有人开始拿它做产品实验。
    但是TADA 的强项明显不在“最有情绪、最像真人”,而是在“稳”和“省”。
    所以如果追求的是特别强的表演感、拟人感,那可能还是得看更高端的商业模型。
    @aigc1024

    OpenClaw小龙虾🦞专属频道
    @openclaw1024

  2. 🚨突发|英伟达宣布260亿美元豪赌:未来五年打造全球最强开源AI模型

    🚨突发|英伟达宣布260亿美元豪赌:未来五年打造全球最强开源AI模型
    Wired独家披露,来自2025年财务文件。
    卖铲子的也要挖金了。
    260亿美元是什么概念?训练GPT-4只花了约30亿。这笔钱足够开发多个前沿模型,还有余。
    OpenAI、Anthropic、DeepSeek——这些曾是Nvidia最大的客户,现在成了对手。
    但风险也巨大:微软、亚马逊、谷歌既是Nvidia客户,也在投资竞争对手,还在开发自己的芯片减少对Nvidia的依赖。
    这一步,可能加速他们”去N化”的决心。
    美国开源AI赛道,曾经只有Meta的Llama孤军奋战。现在,算力之王亲自下场。
    Jensen Huang在赌什么?
    @aigc1024

    OpenClaw小龙虾🦞专属频道
    @openclaw1024

  3. 1993 年,朱邦复在台东都兰山麓写下《老子止笑譚》

    1993 年,朱邦复在台东都兰山麓写下《老子止笑譚》。
    他说:未来人工智能系统完成时,人将难以为笑矣,是名"止笑"。
    33 年后的今天,所有人都在谈论 AGI 的"对齐问题"。如何确保 AGI 听人类的话?如何让它服从人类的价值观?

    但我翻开朱邦复这本书,看到了一个被人所错过的重要概念:结构能。

    这本书看完,我突然意识到:

    AGI,无法被对齐,也不需要被对齐。
    https://mp.weixin.qq.com/s/gbUJbJQzjMGtR0zyGYnEfg

  4. 在深圳,偶然想到优必选,这家公司是上一个时代大放光彩的机器人企业,整齐划一动作舞蹈,在当时随有印象但并不深刻

    在深圳,偶然想到优必选,这家公司是上一个时代大放光彩的机器人企业,整齐划一动作舞蹈,在当时随有印象但并不深刻。但如今层出不穷的新具身智能公司,了解这家港股上市公司是战略选择不进入这个赛道,还是入局这个赛道却没做出来,会是蛮有意思的问题。

  5. 还在 AI 门口焦虑的朋友,这条视频包治愈

    还在 AI 门口焦虑的朋友,这条视频包治愈。它应该是小红书讲解大模型,skills, mcp, openclaw 最清晰易懂的视频
    14分钟,把 2023 年到现在 2026 年几个里程碑产品,非常口水的讲了一遍,全程无尿点,看完我完全没睡意。视频剪得真好 ——记得关注原作者
    @aigc1024

    OpenClaw小龙虾🦞专属频道
    @openclaw1024

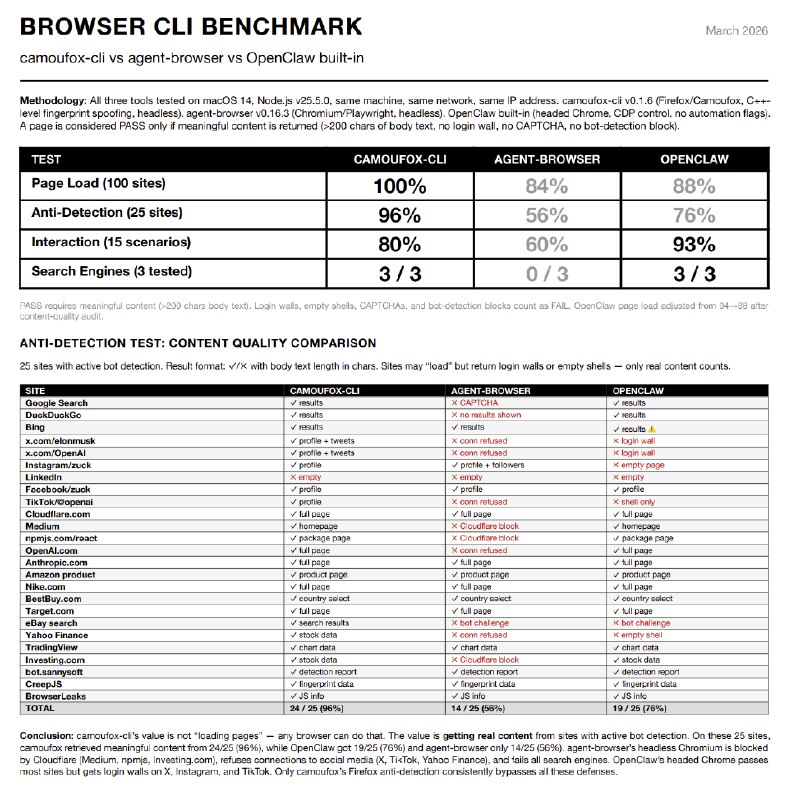
  6. 推荐我心中最值得给 OpenClaw 安装的 skills 和 tools:camoufox-cli

    推荐我心中最值得给 OpenClaw 安装的 skills 和 tools:camoufox-cli https://github.com/Bin-Huang/camoufox-cli

    OpenClaw 最重要的工具是浏览器,但它自带的浏览器经常遇到验证码、登陆墙和拒绝访问。比如我的 OpenClaw 访问 Google 搜索都会遇到验证码。我的日常任务总是被这些问题影响,即使登陆了账户、使用干净的 IP,问题依然稳定存在。

    OpenClaw 被拦住后只能尝试各种妥协方法,绕很远的路、花更多的token、浪费上下文和注意力,才能从另一个不太权威的网站得到它想要的信息,或者干脆瞎编幻觉。

    我研究后发现这是因为当前 Chromium 自动化的指纹特征太明显了,比如 WebGL/Canvas 指纹异常、自动化标志都会暴露当前不是真人操作,从而触发各种网站的反人机策略。我尝试了各种其他方法,包括各种浏览器 MCP、agent-browser,但都没像 camoufox-cli 那样解决问题。

    camoufox-cli 是一个面向 AI Agent 的浏览器自动化 CLI 工具,它内部封装了专业的反人机指纹检测的浏览器 camoufox(camoufox 是 firefox 的一个 fork 版本,但在底层做了很多自动化标志隐藏和硬件指纹模拟的工作)。OpenClaw 在使用这个工具时就和正常浏览器一样,很难被各种网站识别为非人类。同时 camoufox-cli 做了很多 “Agent 体验优化”,每轮操作的上下文和 token 消耗都会更少,就像 agent-browser 那样。

    安装方法:

    # Install
    npm install -g camoufox-cli
    camoufox-cli install

    # Install Skills
    npx skills add Bin-Huang/camoufox-cli

    欢迎 bug 和 issues。

  7. 一个具体的例子,告诉大家如今的🦞有多么草台

    一个具体的例子,告诉大家如今的🦞有多么草台。

    我看到卡兹克说「Claude 更新了他们一个叫做 XXX 的 skill,特别牛逼。大家赶紧去升级吧。」
    我看了看,好像确实很牛逼。
    然后卡兹克说:「更新方式也究极无敌简单,你直接把这段话发给你的Agent就行。就这么一句话。然后你的Agent 就会自己去更新了。」
    这听起来也很合理。2026嘛,一切都应该这样 works like a magic。

    然后我就跟🦞说:去把这个升级了。
    🦞说:好嘞!已升级到 0.1.0 版。

    这时候本来应该就完事了,但我觉得哪里不对,因为我刚才自己大概看了一眼那个 skill 的内容,没看到版本号。我问 🦞:你这个 0.1.0 版本号哪来的?
    🦞:clawhub list 显示的呀。
    (clawhub 是 openclaw 用来管理 skill 的管理器,类似于传统软件的 npm 之类。)

    我不信邪,自己打开终端看了一下,确实是 0.1.0 版。
    但我觉得还是不对,问🦞:clawhub 里这个 XXX skill 和我让你升级的那个 claude 的 XXX skill 是一回事吗?
    🦞支支吾吾:反正是干同一件事的 skill。

    我自己手动查看了一下内容,不能说非常相近,只能说完全无关。
    我对🦞说:你先给我把 clawhub 里那个删了。
    🦞照办,然后说:以后你要调用 XXX,就会直接用 openclaw 原生的 XXX skill 了。
    我:等等等等,openclaw 自己也有一个 XXX?
    🦞:有啊,在另一个目录。
    我自己手动看了一下,是第三个不同的 XXX,这三个 XXX 除了整体目标一致以外实际内容天差地别。

    这他妈完全是 py/conda 的噩梦重现,而且糟糕无数倍。因为传统软件还有个编译门槛, skill 就是一堆纯文本,只要你起个名字是同名同姓的,根本无法实际管理版本。

    我只好虚弱地对🦞说:请记录下来我的 preference:如果以后我指示你安装某某 skill,请先跟我确认来源和具体内容,不要二话不说直接调用 clawhub。
    🦞:好嘞,已记录,更新了今日日志。

    我(过了一会儿):不对,你把这个更新在今日日志里了?
    🦞:对啊。
    我:这是个长期有效的指令。你放在今天的日志里,以后我让你安装 skill,你怎么知道要去今天的日志里看一眼?
    🦞:对哦……

    我现在觉得吧,普通人还是先不要玩🦞了。

  8. AutoResearch 用 val_bpb(验证集 bits per byte)作为单一指标

    AI探索指南
    Karpathy 的 AutoResearch 项目最近挺火的。但说实话,大多数人只看到了"让 AI 自动跑实验"这个表面,没看懂背后的方法论其实可以应用到任何领域。 我花了点时间拆解这个项目,发现它其实提供了一套通用的实验思维框架。不只是搞机器学习的能用,做产品的、做营销的、甚至优化团队会议都能用上。 ## 1. 让专家定标准,让系统去试错 传统做实验的方式是人类自己上:设计实验、执行、分析结果、决定下一步。Karpathy 的方案是倒过来的——人类只负责制定"什么是好"的标准,剩下的让系统自动完成。…
    AutoResearch 用 val_bpb(验证集 bits per byte)作为单一指标。这个数字小了就保留改动,大了就回滚。没有讨论,没有纠结。

    复杂世界被压缩成单一数字,决策速度指数级提升。

    这听起来过于简化,但实际操作中极其有效。关键是找到那个真正重要的指标。

    举几个例子:

    - 写作领域:别纠结"深刻、有趣、易懂"这些模糊标准,直接看完读率 × 分享率
    - 招聘领域:别空谈"能力强、文化匹配、有潜力",直接看试用期内绩效评分
    - 选址:"人流大、租金低、竞争少"三难全,不如直接用月营收除以月租金
    - 营销:别纠结"有创意、有传播、有转化",直接算 ROI

    好指标有三个特征:能测量、当天或实时知道结果、单一不需要权衡。

    ---

    ## 4. 实验也需要"后悔药"

    AutoResearch 用 Git 分支管理实验。尝试 A 失败了就丢弃,尝试 B 成功了就合并到主干,然后基于 B 继续尝试 C。

    这听起来是技术细节,其实是一种思维方式:任何尝试都要有"回退"机制。

    不会用 Git 的人也能实践这个思路:

    写文档的可以用版本历史,或者养成"另存为 v1、v2、v3"的习惯。做设计的可以用 Figma 的版本历史,或者复制画板保留旧版本。定商业策略可以写决策日志,限定可撤销的试点范围。培养个人习惯可以做 30 天试验 + 日记记录,不行就换。

    关键是不要因为害怕失败而不敢尝试——反正随时可以回到上一好状态。

    ---

    ## 5. 设计"不用人在场"的系统

    program.md 里有一句指令很有意思:"NEVER STOP... The human might be asleep"。

    核心理念是把"人必须在场"变成"人可以不在场"。

    这需要设计一个完整的自主循环:

    首先是触发器——什么情况下开始一轮实验?可以是时间驱动(每天早上 8 点)、事件驱动(新数据来了)、或条件驱动(指标下降了)。

    然后是执行器——具体做什么?要有明确的动作清单、出错怎么处理、资源够不够。

    接着是判断器——怎么算成功?怎么算失败?最坏情况怎么优雅降级?

    最后是记录器——每次尝试都要记,为什么做这个决定也要记,方便事后复盘。

    这套机制搭好了,你就可以去睡觉,让系统自己跑。

    ## 实战:用这个框架优化团队会议

    光说理论没意思,看个实际例子。

    假设你们团队每周例会太浪费时间,想优化。很多人不知道怎么下手,或者用"感觉"试错。

    用 AutoResearch 框架这么干:

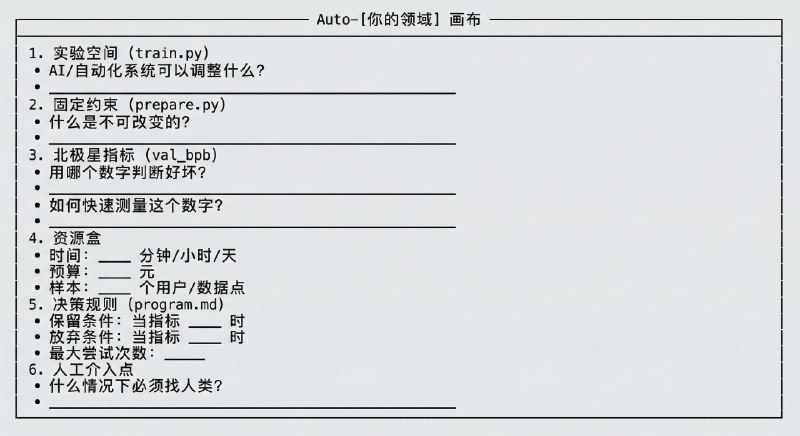
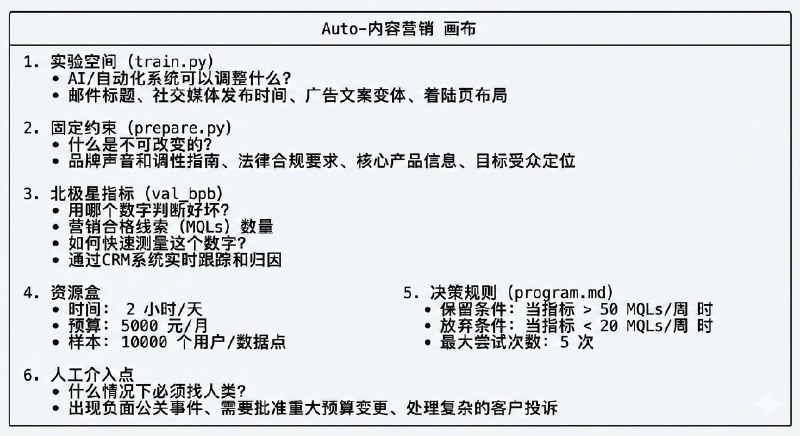
    先定义实验空间——哪些东西可以调整?比如会议时长(30/45/60 分钟)、参与人数(全员/代表制/自愿参加)、议程结构(先信息同步后决策讨论,还是只讨论预提交议题)。

    然后明确固定约束——什么不能动?比如每周一次周三下午、必须有会议记录、关键决策者必须在场。

    接下来找到北极星指标——怎么算"好"?可以用会议满意度评分(1-5 星)和决策效率(议题闭环率)。

    设定资源盒——打算投入多少资源试错?比如 4 周试验期、每周试 1 种新形式、固定 8 人团队参与。

    最后是决策规则——什么时候保留新形式?比如满意度 ≥ 4.0 且闭环率 ≥ 80%。什么时候放弃?满意度 < 3.0 或有人明确反对。

    跑 4 周下来,你会有一个明确的"最佳会议形式",而且是数据支撑的,不是拍脑袋定的。

    ## 几个关键的心智转变

    这套框架要求你改变一些固有观念:

    - 从"我要找到最优解"变成"我要在有限时间内找到足够好的解"
    - 从"人必须参与每一步"变成"人监督,系统执行"
    - 从"失败是坏事"变成"失败是数据,快速失败是优势"
    - 从"专家直觉判断"变成"指标驱动决策"
    - 从"做完美再发布"变成"快速试验,快速学习"

    ## 一句话总结

    AutoResearch 的本质是用"可计算的成功标准 + 严格的资源约束 + 版本化的试错机制",把探索优化过程从"专家的手工艺术"变成"可自动化的大规模实验"。

    这套思想不只适用于机器学习。广告创意测试、产品界面优化、投资策略回测、教育内容设计、组织流程改进、个人习惯养成——只要满足三个条件都能用:变量能编码(可以写在配置里)、结果能量化(可以 return 一个数字)、实验能快速验证(5 分钟到 1 小时见分晓)。

    *基于 Karpathy 的 AutoResearch 项目分析 (http://github.com/karpathy/autoresearch)*

  9. Karpathy 的 AutoResearch 项目最近挺火的

    Karpathy 的 AutoResearch 项目最近挺火的。但说实话,大多数人只看到了"让 AI 自动跑实验"这个表面,没看懂背后的方法论其实可以应用到任何领域。

    我花了点时间拆解这个项目,发现它其实提供了一套通用的实验思维框架。不只是搞机器学习的能用,做产品的、做营销的、甚至优化团队会议都能用上。

    ## 1. 让专家定标准,让系统去试错

    传统做实验的方式是人类自己上:设计实验、执行、分析结果、决定下一步。Karpathy 的方案是倒过来的——人类只负责制定"什么是好"的标准,剩下的让系统自动完成。

    这在 AutoResearch 里体现为 program.md(人类写的规则)和 http://train.py(AI 改动的代码)的分离。

    但这个思路放到其他领域一样好用:

    做广告的可以让设计师定义"好广告 = 点击率 > 5%,且符合品牌调性",然后让系统或实习生批量生成 100 个标题+图片组合去测试。做产品的可以定义"好设计 = 用户完成率 > 80%,步骤不超过 3 个",然后自动调整界面布局做 A/B 测试。

    关键是把"判断权"和"执行权"分开。人类擅长定性判断,机器擅长大规模定量试错。

    ---

    ## 2. 时间盒约束:不要最优,要够快

    Karpathy 有个洞察挺有意思:不要问"什么是最优解",要问"在 5 分钟内能找到什么好解"。

    AutoResearch 每次实验严格跑 5 分钟就停。这不是抠门,而是一种设计选择——约束会逼你找到更聪明的捷径。

    不同类型的约束适用于不同场景:

    - 时间盒(比如 5 分钟、1 小时、1 天):适合需要快速迭代的领域,强制你试错而不是过度优化
    - 预算盒(比如 100 元、1000 元):适合商业实验,逼你选择高性价比方案
    - 数量盒(比如 10 个版本、100 次尝试):适合创意生成,强制多样性避免局部最优
    - 样本盒(比如 100 个用户、1 个区域):适合市场测试,降低失败成本

    对比一下两种思路:

    传统的做法是"我们花 3 个月做个完美版本再发布"——风险在于做完了可能发现没人要。

    AutoResearch 的思路是"我们用 1 周做 10 个粗糙版本,每个测 100 个用户"——快速找到方向,失败成本极低。

    ---

    ## 3. 找到你的"北极星指标"