AI探索指南

  1. 今年黑五最有诚意的 AI 会员促销来了

    今年黑五最有诚意的 AI 会员促销来了
    未来一年,如果你只想开一个 AI 会员包,那可能就是这个了
    只需要每月 9.5 美金,你将获得:

    - 最强生图模型 Banana Pro 每月数百张
    - AI 解说视频生成,每月 20 个
    - 最帅的 AI PPT 生成,每月 20 个
    - 最佳中文 AI 播客,每月 100 个
    - 最自然最智能的 TTS 配音,每月20小时
    - 语音支持音色克隆,支持 API

    ListenHub x Labnana,联合 Pro 年卡黑五半价 50% 限时折扣码:
    BLACKFRIDAY
    限时三天,错过再等一年
    点击链接,立即购买(可用支付宝):
    https://listenhub.ai/zh/pricing

    但我是学生党没有钱怎么办?!
    没关系,我们特别为学生党准备了无限白嫖方案,看回复 👇

  2. 文兄的群里在讨论

    文兄的群里在讨论
    为什么现在工程师的趋势是全栈化了呢?
    为什么现在可以实现组织端到端了呢?
    10年前,3年前 是不行
    不愿意,还是没想到 ?
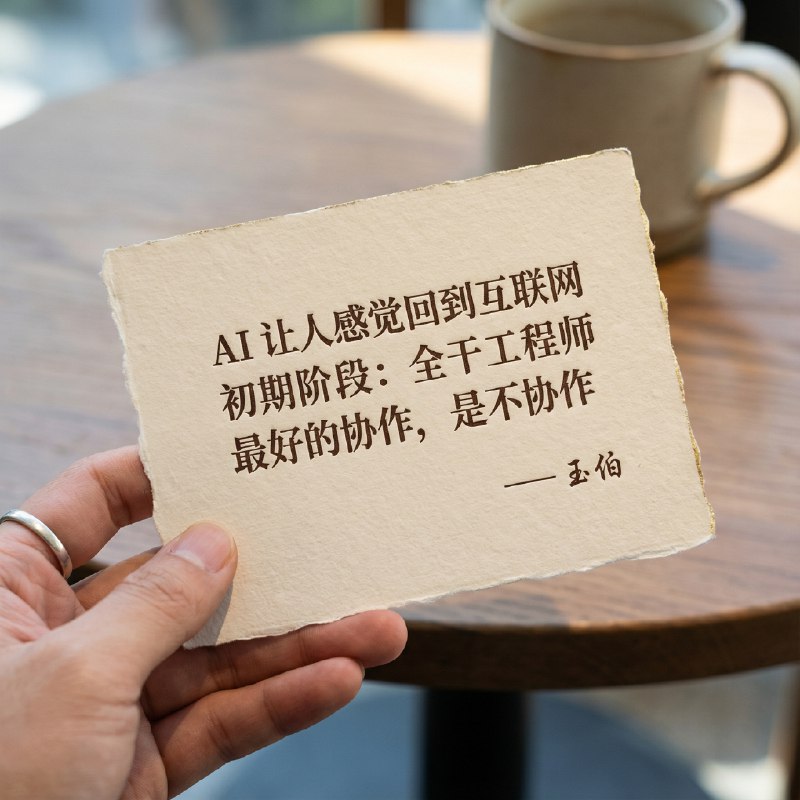
    玉伯说 AI 让人可以很多事情可以独自完成,不用协作了

    最好的协作,就是不协作

    人的分工协作,人一多,就形成了大厂,大厂就容易得大厂病,都是协作出了问题

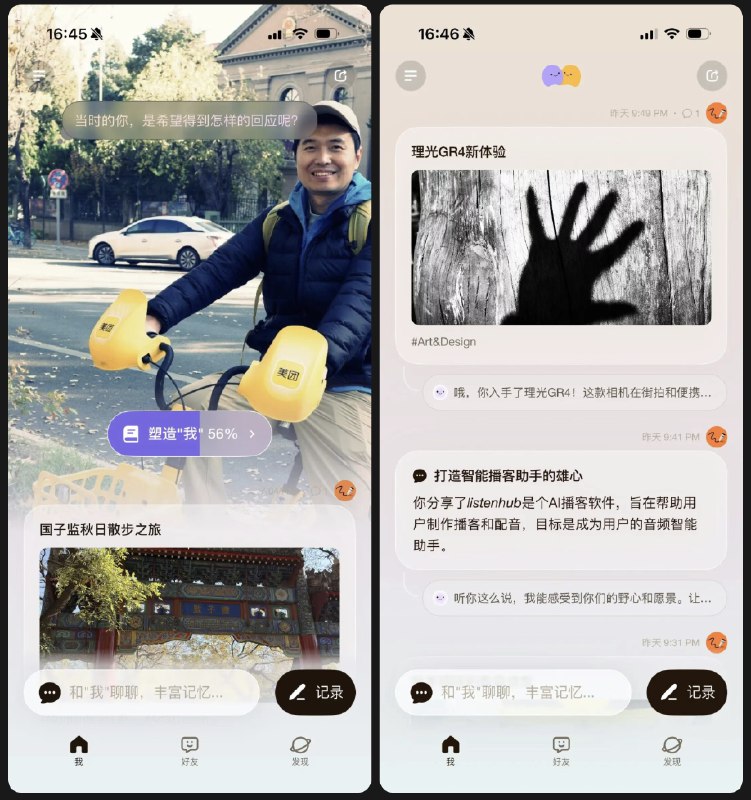
  3. 最近在体验朋友陶芳波老师在做的产品,叫 Second Me,越用越跑神,开始想起一堆关于社交的事

    最近在体验朋友陶芳波老师在做的产品,叫 Second Me,越用越跑神,开始想起一堆关于社交的事。

    我微信里躺着三千多个好友,很多头像我都叫不上名字。偶尔有人突然发消息,我第一反应是这是谁,点开一看,去年十二月聊过一次,就静 quietly 放在那了。

    Second Me 试图解决这个问题,让人通过记录的方式一步一步地构建第二个自我,这个自我可以在AI的世界里和其他人的第二自我聊天、联结。

    如果哪天它能接上微信和社群,在后台帮我把这三千多个好友、几千人的社群都“扫一遍”,自动筛出此刻最值得深入聊的那几个人,或者最适合一起做事的几家公司。人还是这些人,微信也还是微信,只是多了一个很懂我的中间层,在帮我把真正重要的连接捞出来。

    现在 Second Me 还很早,我也只是把它当一个能记人、记事、记想法的第二大脑在用,目前我们的相似度还只有 60%。

    至于 AI 以后能不能重塑我们的社交,现在还说不好。可能要几年之后,再回头看这一两年的这些小实验吧。

  4. Nested Learning 之所以受到关注,是因为它在机制上更接近人脑的运作方式

    AI探索指南
    谷歌最近新发的论文 Nested Learning,甚至有人称之为 Attention Is All You Need 2.0 版本。 模型自我迭代一直是我非常感兴趣的话题,尤其做agent产品时,很多context engineering的活儿还挺烦挺枯燥挺难搞的,如果能把业务的脚手架内化到模型里,效果会有显著的提升。比如过去把lora、Ip adapter、PE优化等训到基模里,应用层就轻松很多,且效果的质量和泛化性都更好了。 作为一个应用层的产品,而非专业算法,看了之后,把自己的理解和思考写出来…
    Nested Learning 之所以受到关注,是因为它在机制上更接近人脑的运作方式。大脑在处理信息时,会产生不同频率的脑波:

    - 高频波(如Gamma波): 往往对应着高度集中的注意力,处理当下的、瞬时的短期记忆。

    - 中低频波(如Alpha波、Delta波): 往往与记忆的整合、固化有关,负责将短期的体验沉淀为长期的认知。

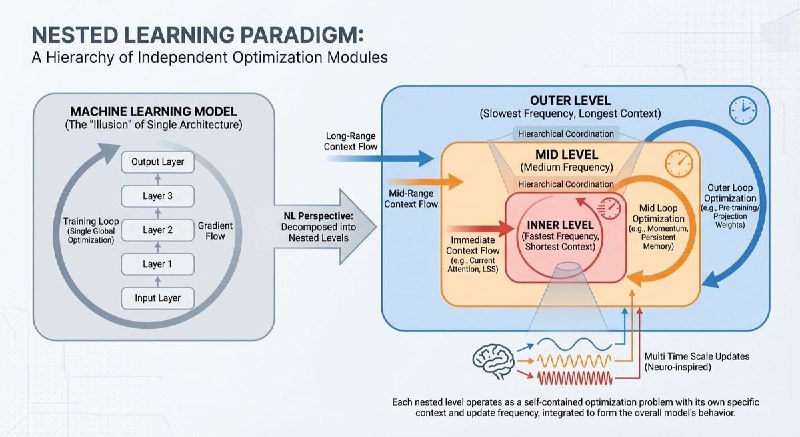
    Nested Learning 借鉴了这种“多时间尺度”(Multi-timescale)的机制。它将模型内部划分为不同的频率区域:

    - 高频区(Fast Weights): 类似于人脑处理短期记忆的区域,能够随着当前的 Context Flow(上下文流)实时快速更新。这让模型在推理过程中就能“学会”新的东西。

    - 低频区(Slow Weights): 类似于长期记忆区,更新频率极低,负责存储那些通用的、稳定的规律。

    通过这种高低频的嵌套与配合,模型不再是一个机械的输入输出函数,而具备了某种程度的“生物活性”,能够在与环境交互的过程中,动态地决定哪些信息该遗忘,哪些信息该像突触生长一样被固化下来。

    3. 对应用层产品的潜在影响

    如果这种从“静态”到“动态”的转变能够落地,我们构建 AI 产品的方式或许会发生几个本质的变化。

    第一,模型角色从“工具”转向“养成系员工”。目前的模型更像是一个标准化的工具,出厂设置决定了它的上限。而基于 Nested Learning 的模型,更像是一个新入职的员工。起初大家的基础能力(基座)差异不大,但在处理具体业务的过程中,它会持续接收反馈(正向的采纳、负向的修正)。

    这种反馈不再仅仅停留在 Prompt 层面,而是会通过“快权重”实时沉淀到模型里。一段时间后,它将变成一个完全适应你业务逻辑的、独一无二的模型。壁垒将由数据规模转向“业务交互的质量”。

    第二,Context Engineering 的“内化”。过去大半年,为了解决模型记性差、不懂业务的问题,我们花费大量精力做 Context Engineering(上下文工程),搭建 RAG、编写复杂的 System Prompt。这本质上是在模型外部搭建“脚手架”。

    当模型具备了自我迭代能力,这些外部的脚手架将被逐步拆除,能力会被内化到模型参数中。模型不再需要你每次都重复告知“你是谁”、“你的目标是什么”,这些信息已经变成了它的直觉。

    第三,从“离线训练”到“在线进化”。目前的 RL、SFT(监督微调)大多是离线的、静态的。业务变了,必须重新收集数据、重新训练、重新部署。Nested Learning 提供了一种在线持续学习的可能。模型置身于真实的数据流中,边服务边学习,这种效率上的提升,在长周期看是巨大的。

    当然,Nested Learning 仍然处于理论阶段,并且其在实践中的挑战依然非常多。比如,如何保证动态权重更新不导致模型不稳定或出现过拟合问题,如何在大规模应用中高效执行这种实时更新,如何在没有大量标注数据的情况下进行有效的在线学习等。

    但它提醒了我们:为了业务,一方面需要修补当下的技术缺陷(如有限上下文长度),另一方面也应关注模型演进的长期方向,看哪些是长期有价值的产品建设。

    未来,我们作为产品,核心工作可能不再是写 Prompt,而是为这个能够自我进化的智能体定义清晰的目标(Goal),并构建一个能够提供高质量反馈的闭环环境。毕竟,当模型能够自我学习时,决定它长成什么样子的,是它所处环境的反馈机制。

    有人把论文喂给nano banana,生成了这张图,非常精准,我自己试过来,没这么好看
  5. 谷歌最近新发的论文 Nested Learning,甚至有人称之为 Attention Is All You Need 2.0 版本

    谷歌最近新发的论文 Nested Learning,甚至有人称之为 Attention Is All You Need 2.0 版本。

    模型自我迭代一直是我非常感兴趣的话题,尤其做agent产品时,很多context engineering的活儿还挺烦挺枯燥挺难搞的,如果能把业务的脚手架内化到模型里,效果会有显著的提升。比如过去把lora、Ip adapter、PE优化等训到基模里,应用层就轻松很多,且效果的质量和泛化性都更好了。

    作为一个应用层的产品,而非专业算法,看了之后,把自己的理解和思考写出来,期待与大家的交流,尤其来自算法同学的纠偏。

    论文地址:https://abehrouz.github.io/files/NL.pdf

    Nest learning试图解决大模型应用目前面临的一个核心矛盾:静态的权重与动态的业务需求之间的割裂。如果说目前的 Transformer 架构本质上是在通过静态权重来“预测下一个 Token”,那么 Nested Learning(嵌套学习)则是在尝试构建一个能够实时自我更新的系统。

    1. 架构的本质差异:静态堆叠 vs 嵌套循环

    目前的 LLM(基于 Transformer)与 Nested Learning 在底层逻辑上有着显著的区别:

    Transformer(当前的主流): 它的训练和推理是截然分开的。我们在训练阶段通过海量数据确定了模型的权重,一旦训练结束,这些权重就固化了。这就好比一个学生在毕业那一刻,他的知识体系就被封存了。上线后的每一次对话(Inference),模型都是在调用这份“死”的长期记忆,虽然能通过上下文窗口(Context Window)处理短期信息,但无法将其转化为长期的经验。这也是为什么模型会患有“顺行性遗忘症”——Session 一关,一切归零。

    Nested Learning(新的范式): 它的核心观点是 “Architecture is an illusion”(架构即幻觉)。它不再将模型看作是层与层的简单堆叠,而是将其视为一组嵌套的优化问题。在这个视角下,架构和优化器是一体两面的。模型被设计成多个不同层级的循环,有的层级负责快速适应(类似推理),即快权重,有的层级负责慢速固化(类似训练),即慢权重,这两者在 Nested Learning 中是统一且同时进行的。

    2. 仿生学原理:多频率的记忆共振

  6. 谷歌股价新高,Gemini3 和 Banana Pro 的发布,已经没有人再怀疑 Google 的能力了

    谷歌股价新高,Gemini3 和 Banana Pro 的发布,已经没有人再怀疑 Google 的能力了。人们看到好东西愿意直接扔钱,根本不需要考虑广告的事情。
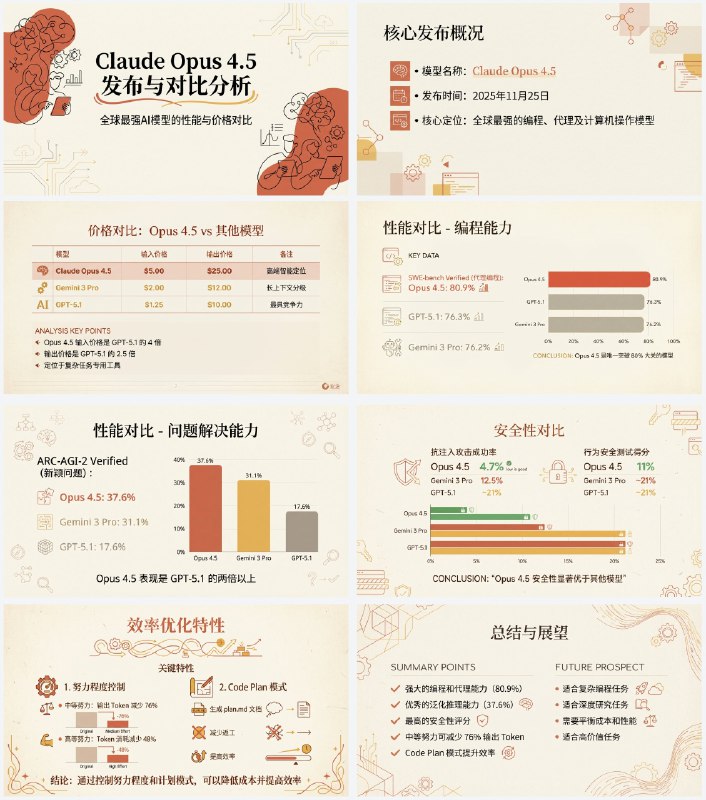
    Claude Opus 4.5 也发布了,虽然有些 delay,但直接大降价,思考 token 消耗下降 76%,性价比持平了 Sonnet 4.5。大家终于用得起了。
    2025年底,AI 行业越来越美好。

  7. 用 Nano Banana Pro 做了一套PPT来展示这次 Claude Opus 4.5 模型的具体更新信息

    用 Nano Banana Pro 做了一套PPT来展示这次 Claude Opus 4.5 模型的具体更新信息

    顺便打磨了一套 Anthropic 风格的PPT生成提示词,你可以在NotebookLM 或者 Lovart里边使用

    NotebookLM 用的话只要风格描述部分,具体提示词为:

    帮我根据下面这个文章做一套中学生都能理解的中文PPT。

    先写1个PPT大纲,规划出每一页的PPT的内容。

    然后将每一页的PPT内容分别扔给Nana Banana pro生成对应页面的PPT,需要确保风格一致。

    PPT的具体风格应该为请“Anthropic/Claude 风格”的“温暖学术人文主义”设计。

    背景:使用暖米色/奶油色 (# F3F0E9) 作为底色,模仿高级纸张质感。

    字体:标题使用优雅的衬线体(Serif),正文使用现代无衬线体(Sans-serif)。

    配色:主色调为赤陶红 (# D67052) 和芥末黄 (# F0B857),搭配深海军蓝作为点缀。避免使用霓虹色或纯黑色。

    视觉元素:使用注重排版的网格布局,插图风格应为抽象的、有机的黑色手绘线条画,置于赤陶红纯色色块之上,部分关键信息使用卡片布局。

    图表:扁平化、极简的柱状图,强调数据对比,去除多余边框。

    文字和图像都由 Nano Banana Pro 生成,另外不要将PPT 变成一整张图,一页一张图。

    文章内容为: