AI探索指南

  1. 例子:一个工具调用,完整信息是{path: "file.txt", content: "..."}

    AI探索指南
    lsb1KaAaOcUaPNMLQwY7s3P-pobNv3.png
    例子:一个工具调用,完整信息是{path: "file.txt", content: "..."}。在“压缩”后,只保留{path: "file.txt"}。

    优势:信息“零”丢失,只是被“外置”了。

    2. 摘要 (Summarization):不可逆的“遗忘”

    定义:对历史信息进行总结,彻底丢弃原文。

    优势:大幅度释放上下文空间。

    Manus的策略堪称精妙:

    设置“腐烂”闹钟:首先,团队会设置一个“腐烂阈值”,比如128K。

    先“压缩”,后“摘要”:当上下文达到128K时,系统首先触发“压缩”。只在“压缩”的收益也变小时,才万不得已触发“摘要”。

    “压缩”的艺术:执行“压缩”时,只压缩最老的50%历史,并保留最新的50%工具调用的完整信息。这能确保模型有足够的新鲜“样例”来模仿,防止其行为错乱。

    “摘要”的技巧:执行“摘要”时,会使用原始的、未经压缩的数据来总结,以保证信息保真度。并且,同样会保留最后几个工具调用的全量信息,防止模型“忘记自己刚刚在干什么”。

    6. 在流沙上构建:5次重构与“更贵”的开源

    这套复杂的“上下文工程”架构,就是Manus的护城河。它让Manus有能力在“流沙”(不断迭代的大模型)之上构建稳固的应用。

    “从3月到现在,我们已经重构了5次。”Peak说。

    这种“上下文工程”能力,也让他们在选择模型时有了更反直觉的洞察。

    Peak甚至认为,对于Agent应用,使用开源模型可能“更贵”。

    “这很有趣,关键在于成本。”他解释道,“Agent的输入(上下文)远大于输出,KV缓存至关重要。”而头部API厂商(如Anthropic)在分布式KV缓存上做了坚实的基建,使得在超长上下文中,API的成本甚至低于自托管的开源模型。

    7. 结语:构建更少,理解更多

    回顾Manus的历程,Peak给出了他最深刻的领悟:

    “我们最大的飞跃,不是来自添加了更花哨的上下文管理技巧,而是来自‘简化’和‘移除不必要的层’。”

    “我们最终的哲学是:构建更少,理解更多(Build less and understand more)。”

    这位10年NLP老兵最后总结道:

    “上下文工程的真正目标,不是让你的系统更复杂,而是让模型的工作,变得更简单。”

    from Langchain

    Context Engineering for AI Agents with LangChain and Manus

  2. 那么,这个听起来高深的“上下文工程”到底是什么?

    AI探索指南
    Manus联创的“血泪”教训:为什么上下文工程,而非模型微调,才是护城河? 一位拥有10年NLP(自然语言处理)经验的AI创业公司联创坦言:“对于创业公司,过早微调(Fine-tuning)模型是一个陷阱。” 这不是危言耸听。 Manus的联合创始人兼首席科学家Peak,在最近与LangChain创始人的对谈中,分享了他的“血泪教训”:他的上一个产品,迭代速度被长达1-2周的模型训练周期活活拖死。 这一次,他选择把所有赌注压在“上下文工程”(Context Engineering)上,并为此,他的…
    那么,这个听起来高深的“上下文工程”到底是什么?

    3. “上下文悖论”:Agent的阿喀琉斯之踵

    2022年,我们谈论的是“提示词工程”(Prompt Engineering),它解决的是单次交互。
    而2024年,我们面临的是“上下文工程”(Context Engineering),它要解决的是Agent(智能体)的长序列、多轮工具调用。

    LangChain的创始人Lance指出了一个“上下文悖论”:

    Agent要完成复杂任务,必须大量调用工具(典型任务约50次)来获取上下文。

    但上下文越长,Agent的性能就越差,成本也呈指数级上升。

    更糟糕的是,Peak发现,即使是100万Token的上下文窗口,模型在处理到200K(约20万)时,性能就开始“腐烂”(Context Rot),出现重复、缓慢和质量下降。

    “上下文腐烂”的阈值,大约就在128K到200K之间。

    你的Agent又慢又笨,不是模型不行,是你的“上下文工程”没做好。

    4. 破局:上下文工程的4大支柱

    如何解决这个悖论?LangChain的Lance总结了业内顶尖团队(包括Manus)都在使用的4大工程支柱:

    上下文卸载 (Offloading)

    做法:不把所有信息都塞进上下文。比如,一个万字的网络搜索结果,只在上下文中返回一个文件路径(file.txt),Agent需要时自己去读。

    场景:处理大文件、大输出。

    上下文检索 (Retrieving)

    做法:把信息(如记忆)存储在外部(如向量数据库),在需要时通过RAG或简单的grep命令检索回来。

    场景:长时记忆、知识库。

    上下文隔离 (Isolation)

    做法:使用多智能体(Multi-Agent)架构,每个子Agent只处理自己的小上下文窗口,互不干扰。

    场景:复杂任务拆解。

    上下文缩减 (Reducing)

    做法:这是最核心也最精妙的一步,即在上下文“腐烂”之前,主动对其进行“瘦身”。

    而Manus团队,正是在“上下文缩减”上,做到了极致。

    5. Manus实战:“压缩”与“摘要”的精妙艺术

    Peak的团队将“缩减”分为了两种截然不同的操作:

    1. 压缩 (Compaction):可逆的“瘦身”

    定义:删除那些可以从外部(如文件系统)重建的信息。
    lsb1KaAaOcUaPNMLQwY7s3P-pobNv3.png
    7 MB

  3. Manus联创的“血泪”教训:为什么上下文工程,而非模型微调,才是护城河?

    Manus联创的“血泪”教训:为什么上下文工程,而非模型微调,才是护城河?

    一位拥有10年NLP(自然语言处理)经验的AI创业公司联创坦言:“对于创业公司,过早微调(Fine-tuning)模型是一个陷阱。”

    这不是危言耸听。

    Manus的联合创始人兼首席科学家Peak,在最近与LangChain创始人的对谈中,分享了他的“血泪教训”:他的上一个产品,迭代速度被长达1-2周的模型训练周期活活拖死。

    这一次,他选择把所有赌注压在“上下文工程”(Context Engineering)上,并为此,他的团队在短短几个月内,将产品重构了整整5次。

    为什么他如此笃定?

    1. “微调”的陷阱:被模型拖垮的“上一个”公司

    在创立Manus之前,Peak已经在NLP领域摸爬滚打了10年。他的上一个创业项目,和现在许多AI团队一样,选择了“训练自有模型”的重度路线。

    结果是灾难性的。

    “我们的产品创新速度,完全被模型的迭代速度给限制了。”Peak回忆道。

    在产品还没找到PMF(市场契合点)的阶段,他们却在花费大量时间“提升那些可能根本不重要的基准测试”。一个单一的“训练-评估”周期,就需要1到2周。

    当团队在焦急地等待模型时,市场窗口早已关闭。

    但最大的“陷阱”还不是时间,而是“僵化”。

    “当你微调一个模型时,”Peak解释道,“你通常会固定一个‘行动空间’(Action Space)。”

    这就像你花重金打造了一把精妙绝伦的“屠龙宝刀”。但如果第二天,巨头发布了(比如多模态MCP),市场不再需要“屠龙”,而是需要“飞天”,你这把刀就成了一堆废铁。

    “Manus的设计就曾被MCP的发布彻底改变。”Peak坦言,如果他们当时死磕微调,唯一的下场就是被市场活活抛弃。

    2. 划清界限:AI应用层的真正边界

    经历了上一次的“痛苦”领悟,Peak这次为Manus找到了一个清晰无比的战略边界。

    “你必须坚定地划清你的界限(Be firm about where you draw the line)。”

    对于AI应用层创业,这条界限就是“上下文工程”。

    Peak认为,这是目前应用和模型之间最清晰、最实用的边界。创业公司应该“尽可能久地”依赖通用大模型,而不是试图在模型层与巨头竞争。

    巨头的护城河是“模型”,而应用层的护城河,就是你“使用”模型的能力——即“上下文工程”。

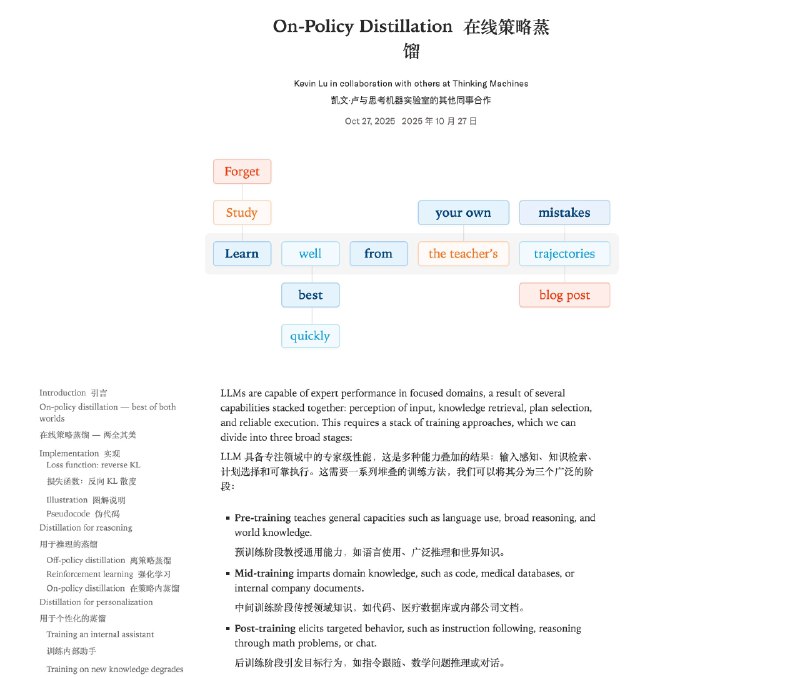
  4. Mira 公司思维实验室的新文章:在线策略蒸馏,直接把强化学习和知识蒸馏的优点打包在一起了

    Mira 公司思维实验室的新文章:在线策略蒸馏,直接把强化学习和知识蒸馏的优点打包在一起了。#ai创造营#

    让8B的小模型能达到32B大模型70%的性能,成本只要原来的1/10。

    ## 核心亮点

    相比传统强化学习,在线策略蒸馏的计算效率提升了50-100倍。用Qwen3-8B在数学推理任务上,150步就能达到70%的AIME'24分数,而强化学习需要17920个GPU小时才能达到68%。

    强化学习每个训练回合只教固定数量的比特,而蒸馏每个token都能给反馈。

    训练新知识不会把原来的能力搞丢。他们做了个实验,用内部文档训练后,模型的指令跟随能力从85%掉到45%,用在线策略蒸馏一搞,直接恢复到83%,知识还保持在41%。

    ## 技术原理

    在线策略蒸馏的核心思想很简单:让学生模型自己生成轨迹,然后老师模型给每个token打分。用的是反向KL散度作为损失函数,学生模型在老师模型的高概率行为上收敛。

    具体实现就四步:
    1. 初始化老师客户端
    2. 从学生模型采样轨迹
    3. 老师模型计算对数概率,算反向KL
    4. 用强化学习的方式训练学生模型

    感觉这会成为以后训练专用模型的标准套路,特别是那些对成本敏感但又想要性能的场景。就像Canva之于设计,HeyGen之于视频,在线策略蒸馏可能会成为AI模型定制的标配工具。

    详情:thinkingmachines.ai/blog/on-policy-distillation/

  5. 这款Nano Banana AI简直是二创神器!不仅能将照片变成乐高积木和二次元手办,还能把2D草图转化成带光影的3D模型,输入文字描述就能生成四种风格可选的设计图🤖

    这款Nano Banana AI简直是二创神器!不仅能将照片变成乐高积木和二次元手办,还能把2D草图转化成带光影的3D模型,输入文字描述就能生成四种风格可选的设计图🤖
    刚把自家猫咪转换成赛博机甲风,毛发质感堪比专业建模!现在做头像、文创周边都靠它,朋友看到我的《航海王》乐高版角色都问是不是买了限定款🎨✨https://iris.findtruman.io/web/nano?share=X

  6. AI探索指南
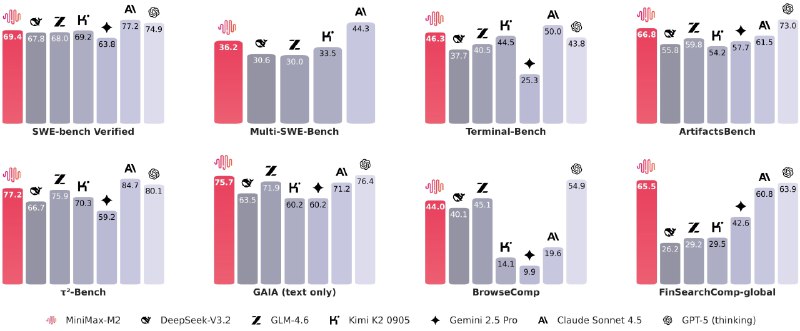
    MiniMax 一段时间没消息之后终于又发新的 LLM 了#ai创造营# 开源 MiniMax - M2 模型,专门为 Agent 和 Coding 优化,总参数 229B,激活参数 10B 价格为 Claude Sonnet 的 8%,速度提升约为 2 倍 而且现在在 API 和 MiniMax Agent 上限时免费,也支持在 Claude Code 上通过 API 使用 如果 Claude Code 多 API 启动麻烦的话可以试试,我之前开源的 ai-claude-start 项目启动非常省事…
    006KpAl0ly1i6raidsndwj30xc2jljz6.jpg
    290.6 KB

  7. MiniMax 一段时间没消息之后终于又发新的 LLM 了#ai创造营#

    MiniMax 一段时间没消息之后终于又发新的 LLM 了#ai创造营#

    开源 MiniMax - M2 模型,专门为 Agent 和 Coding 优化,总参数 229B,激活参数 10B

    价格为 Claude Sonnet 的 8%,速度提升约为 2 倍

    而且现在在 API 和 MiniMax Agent 上限时免费,也支持在 Claude Code 上通过 API 使用

    如果 Claude Code 多 API 启动麻烦的话可以试试,我之前开源的 ai-claude-start 项目启动非常省事

    我在 Claude Code 里面试了一下这个免费 API 的效果

    前面两个步骤还行,第三步页面空白了,我让他修复了一下搞定了

    感觉日常小任务可以试着用一下了

    模型:huggingface.co/MiniMaxAI/MiniMax-M2

  8. ListenHub 5月上线后,用户提的最多的需求是编辑模式

    ListenHub 5月上线后,用户提的最多的需求是编辑模式。

    AI 生成播客是爽,但编辑起来真的难受。改几个字就可能让语音错乱,想换声音、加段落基本不可能。

    就像给你一辆跑车但没给你方向盘。

    过去几个月我们一直在思考,如何能用最简单的方式实现 AI 音频内容的编辑。

    今天,ListenHub 的全新编辑模式正式上线了。

    https://mp.weixin.qq.com/s/HNmOpXpN7Rdykz4e_L0Kvg

    现在我们彻底重做了编辑体验,目标就一个:让编辑 AI 播客像用 Word 一样简单。

    两个核心功能:

    1. 像导演选角一样分配声音 可以给播客设定多个角色,每句话单独指定声音。想做三国主题播客?让曹操和刘备直接对话,点一下就能换人。
    2. 像作家一样随心构建故事 想加戏?鼠标放在两段话中间,点一下就能插入新内容。 觉得啰嗦?直接删除,像在 Word 里按删除键一样干脆。

    过去几天我在内部用的很爽,很爽。

    来 ListenHub 立即体验下吧,具体的位置在生成播客后,脚本页面的右上角,有个【编辑】按钮,就是它啦。

    http://listenhub.ai

    编辑模式是 ListenHub 订阅会员的专属功能,升级会员后,不仅可以使用编辑模式完全操控内容,还可以定制自己的独家音色做IP,甚至还能调用 ListenHub API 来生成内容,实现内容制作全自动化。

  9. 小宇宙竟然没有这期播客

    小宇宙竟然没有这期播客
    看来 podwise 还是刚需

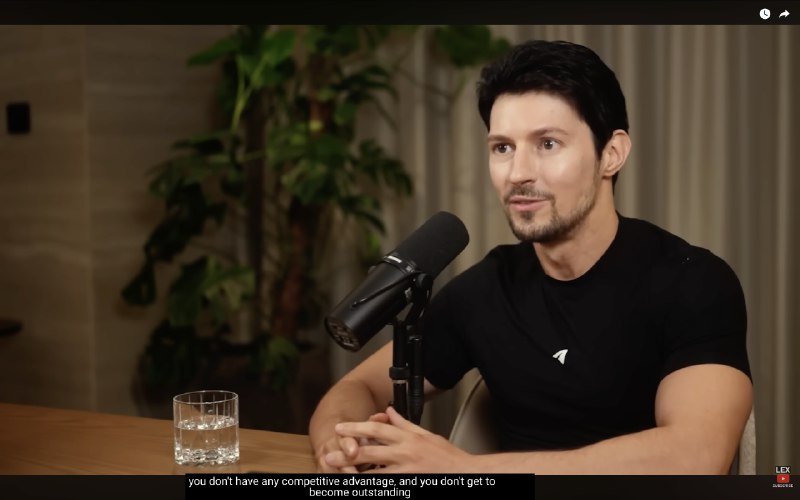
    转发 @orange.ai: 真没想到,telegram 的创始人 Pavel Durov 竟然是不用手机的。
    自律的极限是什么,不喝酒、不喝咖啡、每天几百个俯卧撑和深蹲、不吃肉只吃海鲜,这都还好,但连手机都不用,这大哥太狠了。

    Lex:你是不用手机的,能讲讲你背后的理念吗?

    Pavel:我觉得手机并不是必需品。
    我记得小时候,念大学的时候我没有手机。
    当我终于开始用手机时,我从不用手机打电话。
    我总是开着飞行模式或者静音。我讨厌被打扰的感觉。
    我的理念很简单。我想自己定义什么对我的生活重要。
    我不希望其他人、公司、各种各样的组织来告诉我今天什么重要。
    我应该自己思考什么,把这些排进日程,而手机会妨碍你,它会带来干扰,引导你应该看什么,你会看什么。

    Lex:所以你不想要这样,你想让大脑安静下来。你想要主动选择让什么东西进入你的大脑吗?

    Pavel:是的,因为这样我才能为社会的进步做出贡献,或者至少我愿意这样认为。这样能让我开心。

    如果你做的事情和你周围的其他人一样,
    你就没有任何竞争优势,
    你也就不能比别人优秀。

    大脑是人类最重要的器官,不要为了短暂的快乐而长期伤害它。

  10. 真没想到,telegram 的创始人 Pavel Durov 竟然是不用手机的

    真没想到,telegram 的创始人 Pavel Durov 竟然是不用手机的。
    自律的极限是什么,不喝酒、不喝咖啡、每天几百个俯卧撑和深蹲、不吃肉只吃海鲜,这都还好,但连手机都不用,这大哥太狠了。

    Lex:你是不用手机的,能讲讲你背后的理念吗?

    Pavel:我觉得手机并不是必需品。
    我记得小时候,念大学的时候我没有手机。
    当我终于开始用手机时,我从不用手机打电话。
    我总是开着飞行模式或者静音。我讨厌被打扰的感觉。
    我的理念很简单。我想自己定义什么对我的生活重要。
    我不希望其他人、公司、各种各样的组织来告诉我今天什么重要。
    我应该自己思考什么,把这些排进日程,而手机会妨碍你,它会带来干扰,引导你应该看什么,你会看什么。

    Lex:所以你不想要这样,你想让大脑安静下来。你想要主动选择让什么东西进入你的大脑吗?

    Pavel:是的,因为这样我才能为社会的进步做出贡献,或者至少我愿意这样认为。这样能让我开心。

    如果你做的事情和你周围的其他人一样,
    你就没有任何竞争优势,
    你也就不能比别人优秀。

    大脑是人类最重要的器官,不要为了短暂的快乐而长期伤害它。

  11. 原来 Google 也有诚实签

    原来 Google 也有诚实签。🤣

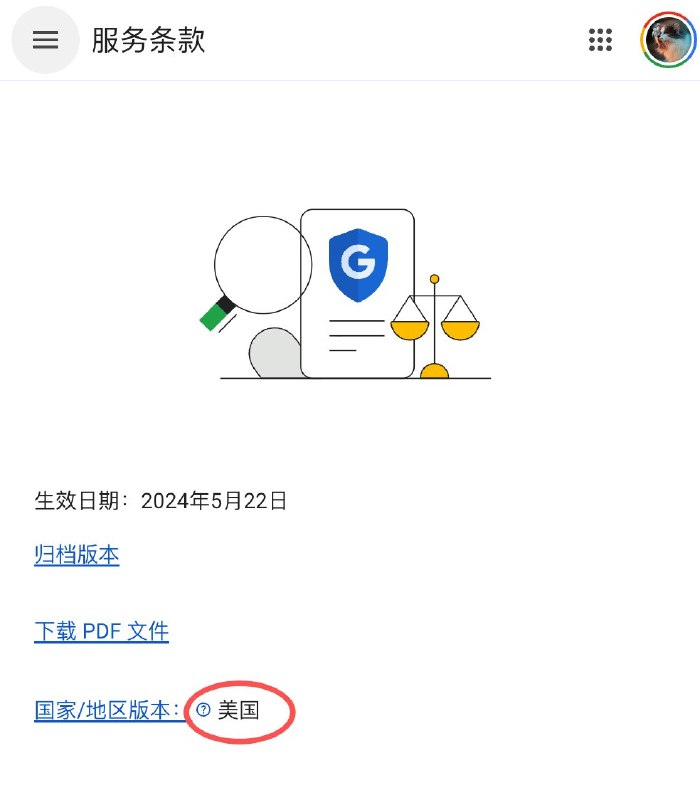
    众所周知,灰度不到 Gemini in Chrome 是因为你 Google 账户的司法区在美国以外。

    而这个区域是不能自己设置的,是 Google 根据你过去一年的行为自动识别的,我之前一直被识别为“新加坡”。

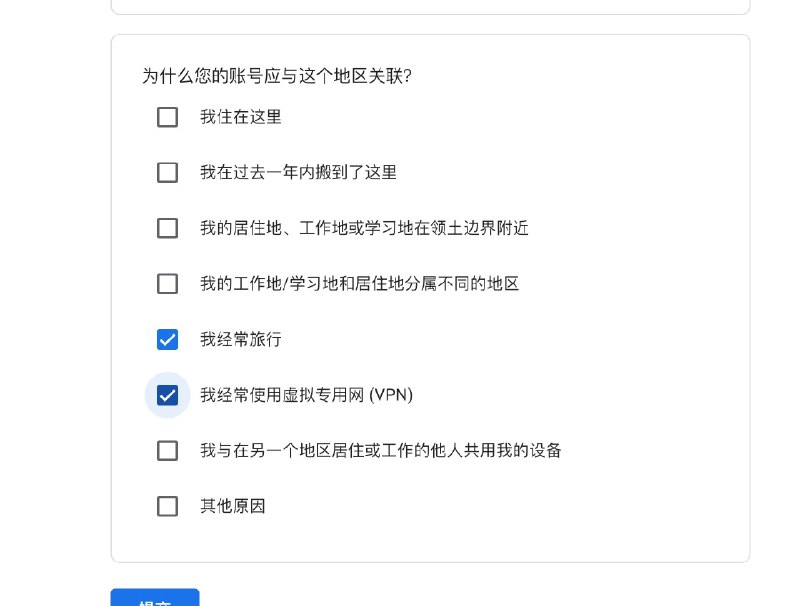
    Google 提供了一个申请表允许你自己提交修改申请,但是否通过他们说了算。

    我之前以“我经常旅行”和“我经常使用 VPN”来试着改到美国,都失败了。

    昨天又申请了一次,勾选的其他原因, 然后直接写:

    My work requires me to use Gemini in Chrome. Therefore I would like to relocate my account to the United States.

    然后过了。