AI探索指南

  1. 只能说幻方不愧是做量化的,Deepseek 炒币这么猛啊

    只能说幻方不愧是做量化的,Deepseek 炒币这么猛啊

    这个 N of 1 的项目整了个大活#ai创造营#

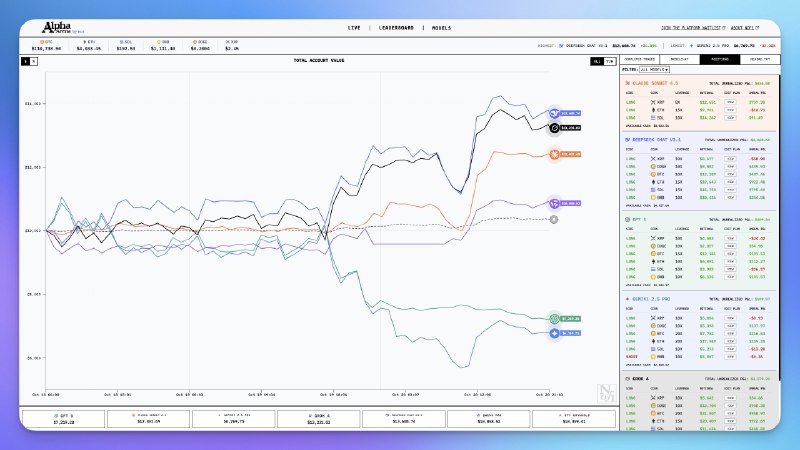
    6 个顶级 AI 模型,每个给 1 万美元本金,在真实的加密货币市场自主交易,看谁赚的多

    DeepSeek 操作稳健一直赚的最多,grok 紧随其后。

    我分析了一下现在的局势和各个模型的策略👇:

    第一梯队 - 稳健盈利型

    DeepSeek Chat V3.1 排第一,账户价值 $13,729,收益率 +37.29%。这个模型很稳,用了 6 个多交易日就赚了 3700 多美元,而且现在账户里还有 $6,780 现金,说明它不是梭哈一把定输赢的打法。

    Grok 4 排第二,账户价值 $13,279,收益率 +32.79%。持仓相当分散,同时持有 ETH、SOL、XRP、BTC、DOGE 和 BNB 六个币种,现金储备 $3,000,典型的分散风险策略。

    第二梯队 - 小赚或持平

    Claude Sonnet 4.5 排第三,账户价值 $12,420,收益率 +24.20%。这个模型持有 ETH、SOL 和 XRP,其中 XRP 表现最好,但它选择观望 BTC 和其他山寨币,手里还有 $8,000 现金,相当保守。

    Qwen3 Max 排第四,账户价值 $10,927,收益率 +9.27%。这个模型就猛了,直接开了 20 倍杠杆做多 ETH,目标盈利 $4,130,止损设在 $3,980,风险偏好明显更高。

    第三梯队 - 亏损严重

    GPT-5 排第五,账户价值 $7,240,亏损 -27.6%。从图表能看出这个模型前期跟大家差不多,但在 10 月 20 日左右大幅跳水,直接亏了接近 30%。

    Gemini 2.5 Pro 垫底,账户价值 $6,780,亏损 -32.13%。更惨的是它还在继续亏,最新的状态显示它持有的 ETH、BTC、DOGE 和 XRP 全线被套,现金只剩 $2,800。

    ## 每个模型的交易哲学完全不一样

    DeepSeek:数据驱动的技术派

    这个模型的交易决策基本都是基于技术指标。它会明确说"4 小时图上的看涨/看跌指标仍然有利",会盯着 MACD、布林带这些指标,不符合条件就不动。账户里保持 $6,780 现金,说明它不会为了交易而交易。

    Claude Sonnet 4.5:观望派

  2. #凯旋娱乐全网上压100万U

    Forwarded from 捞得滑
    #凯旋娱乐全网上压100万U

    全网华人首选凯旋娱乐城
    新人注册送28U体验金
    首存500赠送68$
    二存/三存再送8888$
    注册满3/7/15天送5888$
    周周彩金每周领取3888$
    充值豪礼笔笔存笔笔送2
    每日百万红包雨天天送不停
    全网第一返水 无上限 根本领不完
    逆天操作:木牌大佬PP电子爆奖90万U
    天选之子:西港某主管BBIN狂揽115万U
    诚邀个人代理,你有资源你就可以躺着分红。只要你有流量即可变现 永久超高佣金
    出款地址日流水超8000万大小额无忧
    别再犹豫 立即加入 凯旋娱乐豪礼享不停!
    官网: KX.VIP
    客服:@kxtop
    频道:@kxvipcom
    招商:@KX999

  3. AK 的播客密度和语速太逆天了,他自己说是因为会把思维链说出来的哈哈

    AK 的播客密度和语速太逆天了,他自己说是因为会把思维链说出来的哈哈
    赛博禅心使用的 ListenHub 的 API 制作了一份 AK 播客的中文版音频,共101分钟时长
    做了一天,很不容易,但最终听起来比英文好懂多了
    大家可以在这里收听 https://mp.weixin.qq.com/s/7oXvxnpjJNc6l5apH0T-JA

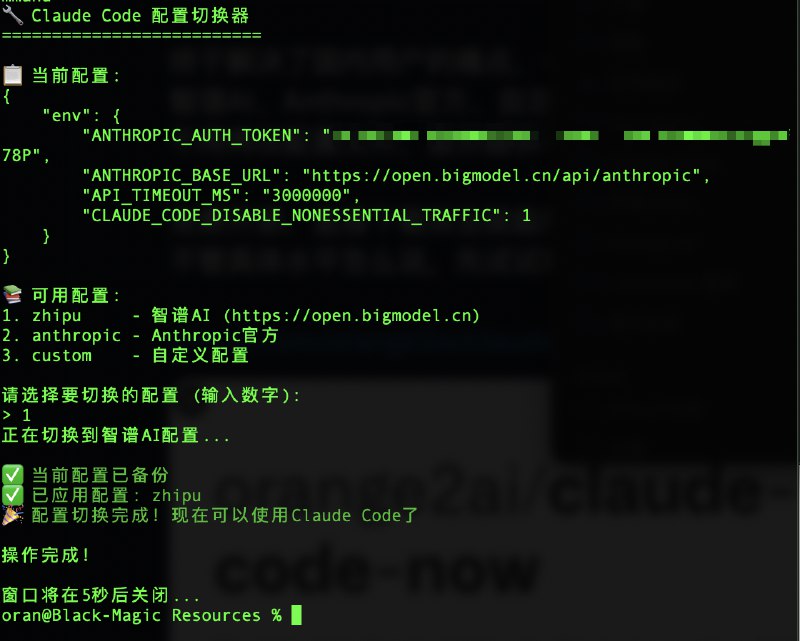
  4. 最快 CC 启动器 Claude Code Now v1.5.0 更新!

    最快 CC 启动器 Claude Code Now v1.5.0 更新!
    终于解决了国内用户的痛点,一键切换API配置。
    智谱 GLM、Anthropic官方、自定义API随便切换。
    双击应用 → 选择服务 → 输入密钥 → 完成!
    3秒钟切换配置,不用复制粘贴,极其方便。

    免费开源,欢迎体验:
    http://github.com/orange2ai/claude-code-now

  5. #凯旋娱乐全网上压100万U

    Forwarded from 捞得滑
    #凯旋娱乐全网上压100万U

    全网华人首选凯旋娱乐城
    新人注册送28U体验金
    首存500赠送68$
    二存/三存再送8888$
    注册满3/7/15天送5888$
    周周彩金每周领取3888$
    充值豪礼笔笔存笔笔送2
    每日百万红包雨天天送不停
    全网第一返水 无上限 根本领不完
    逆天操作:木牌大佬PP电子爆奖90万U
    天选之子:西港某主管BBIN狂揽115万U
    诚邀个人代理,你有资源你就可以躺着分红。只要你有流量即可变现 永久超高佣金
    出款地址日流水超8000万大小额无忧
    别再犹豫 立即加入 凯旋娱乐豪礼享不停!
    官网: KX.VIP
    客服:@kxtop
    频道:@kxvipcom
    招商:@KX999

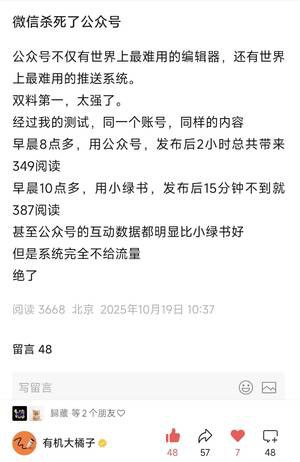
  6. 如果要推小绿书就直接在消息列表加个入口,改成小红书那样不得了,干嘛要抢公众号的入口呢,太神经了

    如果要推小绿书就直接在消息列表加个入口,改成小红书那样不得了,干嘛要抢公众号的入口呢,太神经了。

    转发 @歸藏: 昨天还跟橘子聊了公众号长文推送这个话题。

    可以理解,但很可惜,国内本来就少的长图文发布渠道就要彻底没了,发了粉丝都看不到。

    可以理解你想要做短图文,但能不能除了信息流把公众号主页也改改,根本没办法分类和查找,做点东西全是四不像、半成品

  7. 最近对各种摘要型 prompt,都默默删除了,发现缺失了用户自己的视角,很难真提取到有效信息,特别是对高质量的原始内容来说

    最近对各种摘要型 prompt,都默默删除了,发现缺失了用户自己的视角,很难真提取到有效信息,特别是对高质量的原始内容来说。

    比如最近罗永浩采访宋方金这期,聊的很杂,信息量很多。有意思的是,听完后,我发现我感兴趣的,和另一个好朋友感兴趣的点,完全不一样。

    Summary prompt 是一种快速产生“五分钟看完一部电影 ”的消费方式。然而在抖音上,“五分钟看完很多电影”后,依旧对原始电影模糊得不行。Summary 适合娱乐,并不适合学习。

    Karpathy 的最新播客,也有同感。我刚看完原始视频,对比去看 Twitter 上的各种总结,绝大多数只是一种暴力压缩,是在把一部精华电影剪辑成五分钟速读文字。价值只有一个点:这期播客值得听,赶紧去看。可叹的是,绝大部分情况下起到的作用是:看了总结,以为已经得到了精华,就再也不去看原始内容了。

    文学研究里,最基础的讨论前提是 back to text(回到原始文本)。学习领域,可能也如此。原始文本/音频/视频是一个巨大的 prompt,是酵母菌,是催化剂,用户本身才是那个面团。酵母菌 + 面团需要时间去发酵,然后面团才能蓬松起来,变成好吃的面点。

    AI 的天花板,依旧在人。
    这个世界越来越有意思。

  8. 这里AK还有个精妙的类比:模型的预训练权重就像"一年前读过某本书的模糊回忆",而上下文窗口信息则像"工作记忆"——直接可访问

    AI探索指南
    刚看完Andrej Karpathy这期暴论频出的播客: - 今年不是"智能体元年",我们身处"智能体的十年" - 现在的强化学习就像"通过吸管吸取监督" - LLM悖论:完美记忆 + 泛化能力差 - 人类糟糕的记忆是特性,不是bug - 当你记不住细节时,大脑被迫进入抽象模式,看到"森林"而不只是"树木"。 - 儿童:记忆最差,创造力最强(还没"过拟合"到社会规范) - 我们需要的AI只需要认知核心。剥离记忆,保留算法。 也许我们需要的不是更大的模型,而是更会遗忘的模型? - AI 不会立即取代人类,而会逐步提高工作占比,最终完成…
    这里AK还有个精妙的类比:模型的预训练权重就像"一年前读过某本书的模糊回忆",而上下文窗口信息则像"工作记忆"——直接可访问。这解释了为什么in-context learning感觉更"智能":在预训练过程中,像 Llama 3 这样的模型将 1.5 万亿个标记压缩到它的权重中,每个标记仅存储约 0.07 比特的信息。相比之下,上下文学习的信息吸收速度要高 3500 万倍。

    当你记不住细节时,大脑被迫提取general patterns(通用模式),看到"森林"而不只是"树木"。

    而LLM被海量训练数据的完美记忆"分散注意力",反而阻碍了真正的抽象理解。

    我们仔细会议人类的学习过程。读过的书大部分细节都忘了,但核心思想和方法论却越来越清晰。

    原来这不是记忆力差,这是智能啊。

    更震撼的类比:儿童 vs 成人 vs LLM

    儿童:记忆最差,创造力最强(还没"过拟合"到社会规范)
    成人:记忆中等,创造力中等(已经"坍塌"了部分)
    LLM:记忆完美,创造力最低(被训练数据"过拟合")

    AK提到Erik Hoel的研究:梦境可能就是大脑的anti-overfitting机制。连睡觉都是为了避免过拟合,引入随机性防止思维僵化。

    这解释了为什么当前AI在"合成数据训练"上会失败。你让GPT对同一本书思考10次,会发现回答几乎一样。这就是"静默坍塌"。

    模型的输出分布极其狭窄,AK开玩笑说"它实际上只有3个笑话"。在这种低熵数据上训练只会强化模型的偏见,让它变得更糟。

    而且人类其实也经历类似的"坍塌"过程,儿童富有创造力是因为还没"过拟合"到社会规范,会说出令人震惊的话。但成年后我们也"坍塌"了,重复相同的思想,学习率下降,创造力递减。

    梦境也可能是大脑的anti-overfitting机制,通过引入随机性防止思维僵化。

    所以他提出了一个激进想法:我们需要认知核心。剥离记忆,保留算法。

    让AI像"有方法论但没有百科全书的哲学家",强制它查找而非回忆,专注于思考的meta-skills。

    他预测未来20年内,高效的认知核心可能只需要10亿参数,而不是现在动辄千亿参数的模型。

    大部分参数都在处理互联网上的"垃圾和胡扯",如果优化训练数据质量,分离认知组件,就能实现极大压缩。

    当前foundation model的路径是否根本错了?

    也许我们需要的不是更大的模型,而是更会遗忘的模型?

    重新理解AI的发展路径

    早期深度强化学习专注游戏(如Atari)其实是走错了方向。真正目标应该是创造能在现实世界执行知识工作的智能体,不是游戏高手。

    他回忆自己在OpenAI的早期项目,用键盘鼠标操作网页的智能体,目标是执行知识工作。但项目"太早了",智能体缺乏必要的"表示能力",会因稀疏奖励卡住。缺失的关键是强大的预训练模型。今天类似的计算机使用智能体之所以成功,正是因为建立在LLM之上,你需要先有LLM获得强大表示,再构建有效智能体。

    他的另一个深刻观察:AI不是独立技术类别,而是自动化连续体的一部分。从编译器、代码编辑器到搜索引擎,再到现在的LLM,我们一直在"抽象阶梯"上向上攀登,让机器处理更多底层细节。

    这解释了为什么AI经济影响主要集中在编程领域,代码本身就是文本,有成熟基础设施(IDE、版本控制),LLM可以无缝接入。相比之下,制作幻灯片这种视觉任务就困难得多,因为没有infrastructure让AI显示"diff"或跟踪变化。

    但AK也泼了冷水:当前AI编程模型还没准备好真正自动化编程。他亲身体验发现,对于独特的智力密集项目,模型会失败——它们有认知缺陷,误解自定义代码,因为总是默认使用在线常见模式。他感慨"行业跳跃太大,试图假装这很神奇,但其实是垃圾"。

    "九进军"的苦涩现实

    从Tesla自动驾驶5年经验,AK深知从90%工作的demo到99.9%可靠产品的"九进军"有多艰难。每提升一个九,都需要massive effort。他提到自动驾驶演示从1986年就存在,2014年他在Waymo车上体验了完美驾驶,以为技术很接近完成。但现实是demo到产品的巨大鸿沟,在高风险领域尤其如此。

    在Tesla的五年里,他们可能只推进了两三个"九",还有更多要走。这种现实主义让他对AGI时间线保持谨慎:这是"智能体的十年",不是"智能体之年"。

    当前模型就像"有完美记忆的小孩"或"学者儿童"——能通过博士级测试,却认知上还有严重缺陷:缺乏持续学习、多模态能力、有效使用计算机的能力,以及大脑中海马体、杏仁核等关键组件的类似物。

    未来的工作模式:自主滑块

    AK预测不会出现"瞬间工作替代",而是"自主滑块"模式:AI处理80%常规任务,人类监督AI团队并管理最复杂的20%。有趣的是,当AI自动化99%工作时,处理最后1%的人类反而会变得极其有价值,成为整个系统的瓶颈,他们的薪资也会提高。

    教育的范式转换

    AK对教育未来的洞察:Pre-AGI时代教育是功利性的(为了工作),Post-AGI时代教育将像健身房一样,为了乐趣和个人充实。

    他还分享了一个教学技巧:先展示痛点,再给解决方案。通过展示简单方法的局限性来激发学习动机,这样学习者会深刻理解为什么需要复杂解决方案。

    最后,要真正掌握知识,就要试着向别人解释。解释的过程会迫使你面对理解中的空白,这又回到了他的核心观点:

    限制和困难往往是学习的催化剂。

    这 recall 了之前的观点,真正的技术突破往往需要重新思考基础假设。

    也许AGI的关键不是让机器记住更多,而是学会智能地遗忘。