AI探索指南

  1. 非程序员,目前用的AI 编程工作流

    非程序员,目前用的AI 编程工作流

    需求分析/技术方案阶段:
    1、gpt需求分析:
    首先发散(7个维度):和gpt充分沟通7个维度:用户,场景,当前痛点,当前方案,频度,广度,深度,然后生成尽可能多的功能点需求

    其次收敛(33原则):按照每次开发最多只做3个核心需求,每个功能最多只做3个功能点

    2、gpt生成文档:prd.md / erd.md / todolist.md(供 Cursor 用)
    产品需求文档 prd.md
    工程结构和数据结构设计文档 erd.md
    开发代办列表 todolist.md

    正式开发阶段:
    3、Cursor 执行开发任务 1,严格按 todolist.md 开始, 每完成一个任务后同时更新todolist.md 和cursorlog.md

    4、Cursor开发过程中,第一次要输入详细prompt,后续可以简化,每个任务开发完成后做2件事情
    a,观察todolist和cursorlog是否正常更新,没有就是跑偏了,立刻回滚,然后输入详细prompt重新生成。
    b,如果todolist和cursorlog正常更新,则做一下测试,验证当前完成的开发是否符合产品预期,如果符合就继续开发下一个任务,否则就回去改bug。
    直到全部完成

    5、全部完成后,需要的话,可以把代码打包丢给gpt,让它做code review,再看要不要继续优化下

    6、全部跑通后 输出 Changelog + Git 封版

    今天回归第一天,看到前面有评论提到这个,正好说下我目前用的办法

    还在持续迭代中,如果有更好的方式,求大佬不吝指点

  2. 终于有公司在解决 MCP 配置难的问题了

    终于有公司在解决 MCP 配置难的问题了。
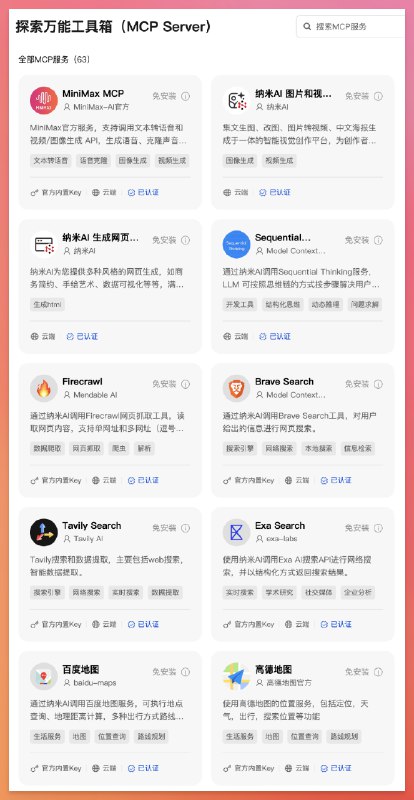
    纳米AI出了个 MCP 万能工具箱,把100多个MCP 都配置好了,直接就能调用。
    甚至把常用的18个的key都内置了,连去各个网站找key都省了...
    不管高德地图还是MiniMax生图、生音、生视频,想要什么就直接调用
    目前还是限制免费随便调用,也就说是纳米官方的key在支付账单,后续应该会收费,不然谁兜得住。

  3. 我去!来了朋友们,4o 图片生成 API 上线

    我去!来了朋友们,4o 图片生成 API 上线

    哥几个的提示词价值再次上升了

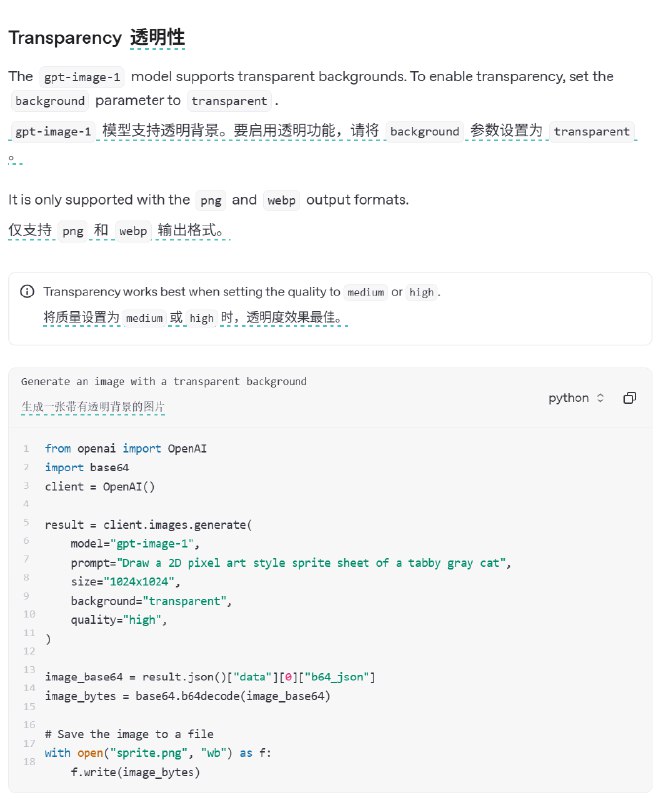
    名字叫 gpt-image-1,4o相关的功能有两个

    Generations: 根据文本提示从零开始生成图像

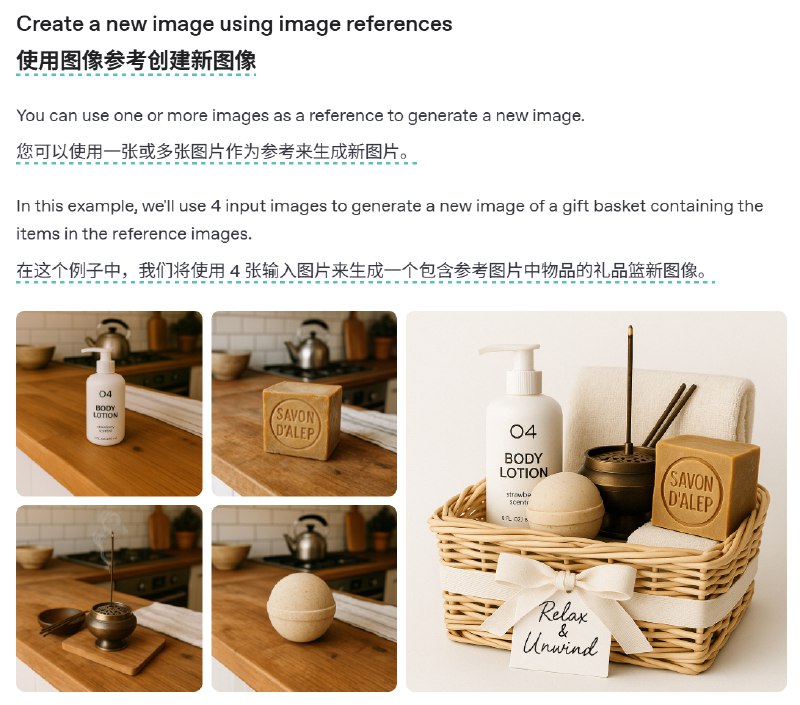
    编辑:使用新的提示词修改现有图像,可以是部分或全部修改

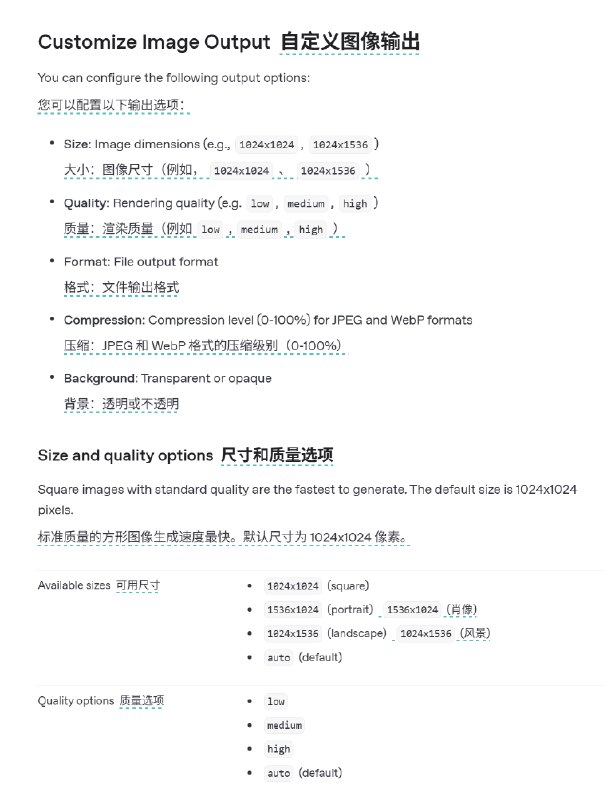
    支持尺寸自定义、质量自定义和 alpha 通道输出

    详细信息:https://platform.openai.com/docs/guides/image-generation?image-generation-model=gpt-image-1

  4. 瞎聊,

    瞎聊,

    人形机器人,「错在」人形…

    变相金刚里面,各种形态的机器人,
    可以做到人类无法介入的形式,

    那才是机器的优势,

    人这个框架形态,
    在远古进化中成了这个「最有效」,

    但是,工业化和未来的世界,
    身形最佳的「人」,应该不是这副躯体模样吧…

  5. 经常做自媒体的小伙伴们,水印移除一直是图片处理的难题,最近在 GitHub 又发现一款完全开源免费的 AI 水印移除工具:WatermarkRemover-AI

    经常做自媒体的小伙伴们,水印移除一直是图片处理的难题,最近在 GitHub 又发现一款完全开源免费的 AI 水印移除工具:WatermarkRemover-AI。

    经常做自媒体的小伙伴们,水印移除一直是图片处理的难题,最近发现一款完全开源免费的 AI 水印移除工具:WatermarkRemover-AI。

    主要功能
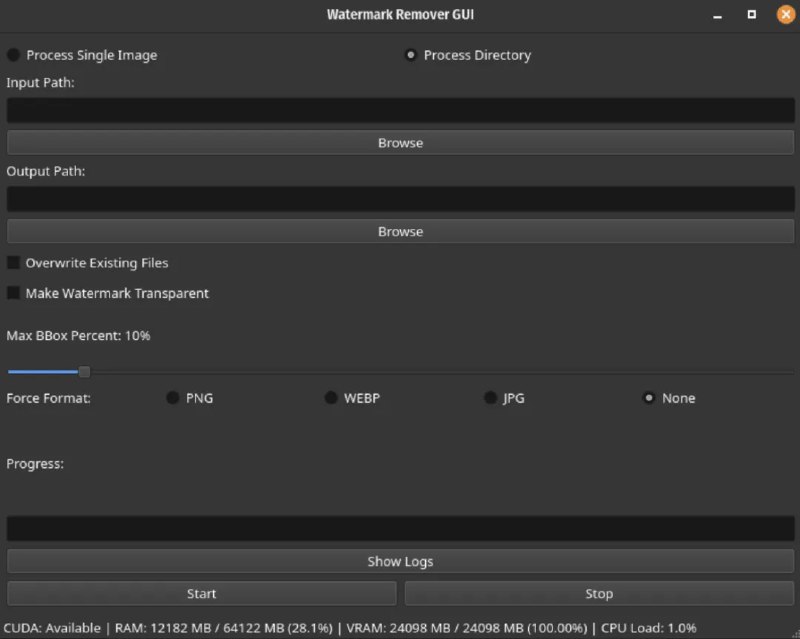
    • 支持多图批量处理:支持单张图片或整个文件夹批量去水印
    • 提供精准水印识别:基于微软Florence-2视觉大模型,可识别各种样式水印
    • 上下文感知修复:使用 LaMa inpainting 模型,实现“原图级”上下文感知图像填补
    • 灵活配置支持:可设置水印最大尺寸、透明度灵敏度,适配不同图片
    • 多格式输出:支持导出为 .png / .webp / .jpg
    • GUI + 命令行双模式:提供图形界面操作和 CLI 脚本
    • 无需 GPU 支持:在普通笔记本也能流畅运行,轻量级推理

    GitHub:github.com/D-Ogi/WatermarkRemover-AI

  6. Pro 会员 则享有每⽉ 10000 ⻚ 额度,并接⼊ DeepSeek ⾼级翻译模型,带来更强⼤的翻译效果

    AI探索指南
    沉浸式翻译估计 AI 圈上人手一个了 前几天发现他们发了个新工具Babeldoc,支持在翻译 PDF 的时候保持文件的原始排版 试了一下真的很猛,超长超复杂 PDF 都没问题 主要是依然非常良心,我做了个相对详细的测试👇: 先来点低难度的常见的论文,一般都不会有非常复杂的排版,难点主要在图表和表格以及公式上。 比如常见的论文开头部分,像字节和 Meta 的论文都是这样,从标题到摘要部分到下面的图表都能对得上。 学术论文中很多数学公式、化学公式的排版非常复杂,以前如果周围有公式,那文字的排版就不太好保持了。…
    Pro 会员 则享有每⽉ 10000 ⻚ 额度,并接⼊ DeepSeek ⾼级翻译模型,带来更强⼤的翻译效果。

    另外翻译好的谷歌提示词文档和斯坦福的人工智能指数报告可以在这里领取:http://pan.quark.cn/s/e5f5b4ac8147
    FoKbfCuPi0jeY7mZpSfBHIgYG44xv3.png
    1.2 MB

  7. 沉浸式翻译估计 AI 圈上人手一个了

    沉浸式翻译估计 AI 圈上人手一个了

    前几天发现他们发了个新工具Babeldoc,支持在翻译 PDF 的时候保持文件的原始排版

    试了一下真的很猛,超长超复杂 PDF 都没问题

    主要是依然非常良心,我做了个相对详细的测试👇:

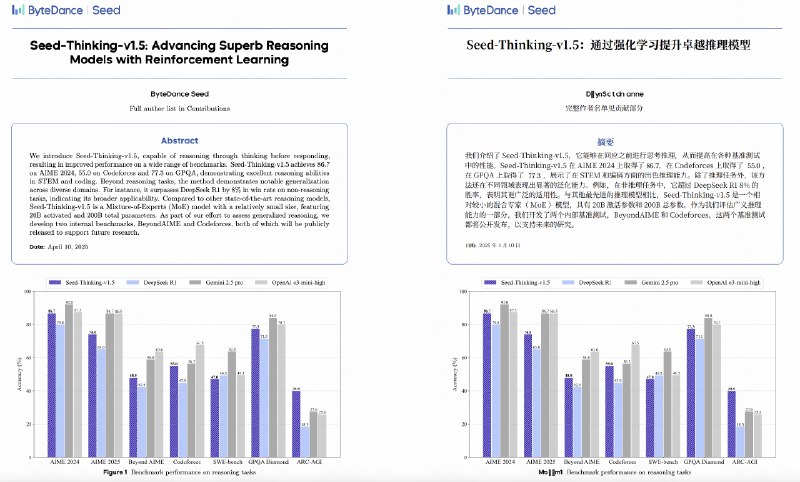
    先来点低难度的常见的论文,一般都不会有非常复杂的排版,难点主要在图表和表格以及公式上。
    比如常见的论文开头部分,像字节和 Meta 的论文都是这样,从标题到摘要部分到下面的图表都能对得上。
    学术论文中很多数学公式、化学公式的排版非常复杂,以前如果周围有公式,那文字的排版就不太好保持了。
    Babeldoc 这个就很厉害中英文的字数和单词长度肯定是不一样的,但是他们就是能保证两者都在差不多的位置。

    然后我们来一个稍微复杂点的
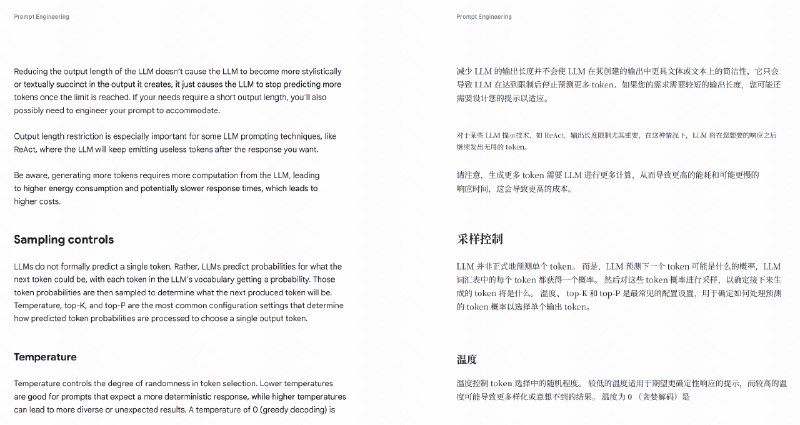
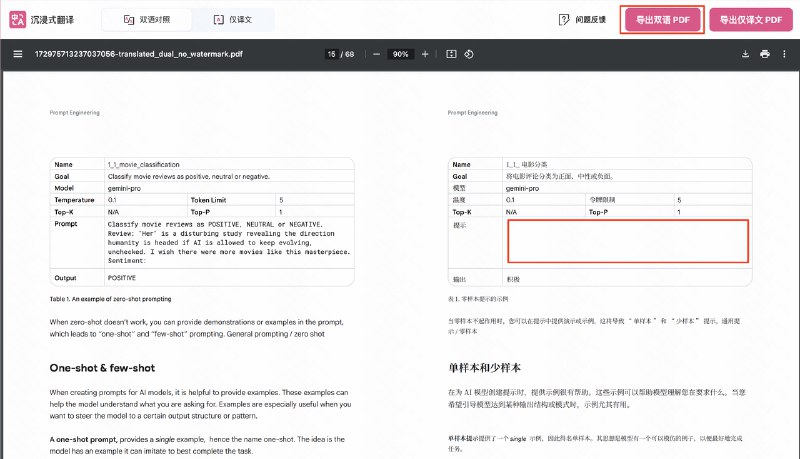
    前段时间比较火的谷歌提示词写作教程的 PDF。
    这个 PDF 明显会专门做了一些排版,重新定义了不同的字号和间距,还有不同的字体,这种一般挺麻烦的,虽然看起来还是白底黑字。
    Babeldoc 依然没有问题,整个字号和段间距、行间距都跟原始 PDF 是一致的。
    同时为了兜底,沉浸式翻译的文档翻译还支持导出中英双语对照的 PDF,这个功能完美解决了问题。

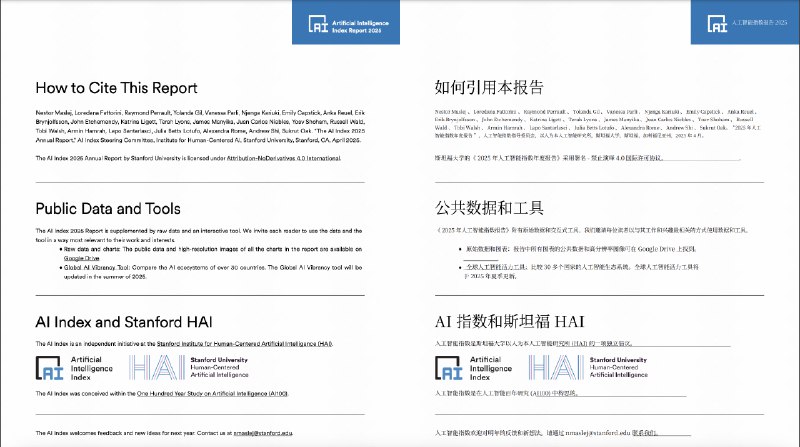
    最后的终极考验是斯坦福 HAI 的 2025 年人工智能研究报告。
    这个 PDF 有456 页,而且内容极其复杂,各种图表、图片、标志、角标、多列排版,疑难杂症它全占了。
    没想到这个转的非常完美,先看一下这一页,分割线、下划线加上标志,没啥问题,角标都给你翻译了。
    下一页更是重量级,多列排版、图表、大段注释,整体依然翻译的很好,而且图表的主副标题都翻译了。
    最后更邪门了,谁会想到左上角这个带颜色区块这种排版啊,但是 Babeldoc 依然搞定了。

    那说了这么多如何使用呢。
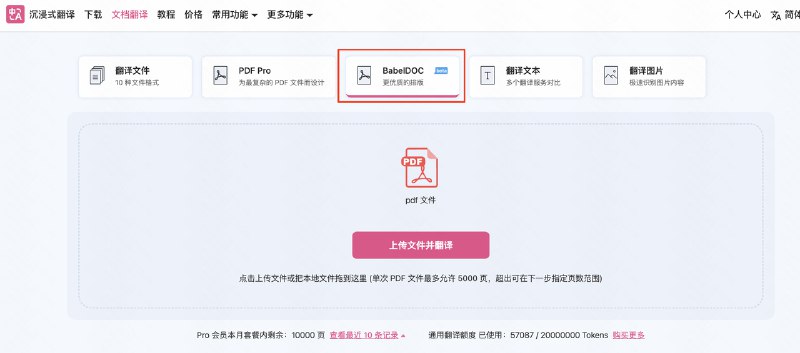
    如果你有安装沉浸式翻译的话可以点击插件,然后点击图片里的 PDF/ePub 就可以进入文档翻译界面,进去以后选择 BabelDOC 就行。
    也可以直接访问:https://app.immersivetranslate.com/babel-doc/

    BabelDOC 的套餐依然延续了沉浸式翻译的良心操作:

    免费版⽤⼾每⽉享有 1000 ⻚ 的PDF解析翻译额度,并使⽤ GLM-4-FLASH ⼤模型进⾏翻译,我一个月都没这么多文档需要翻译的。