AI探索指南

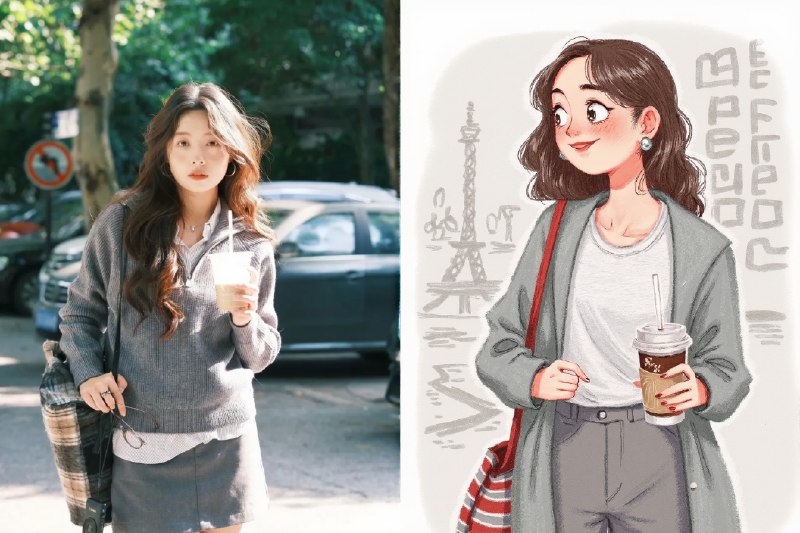
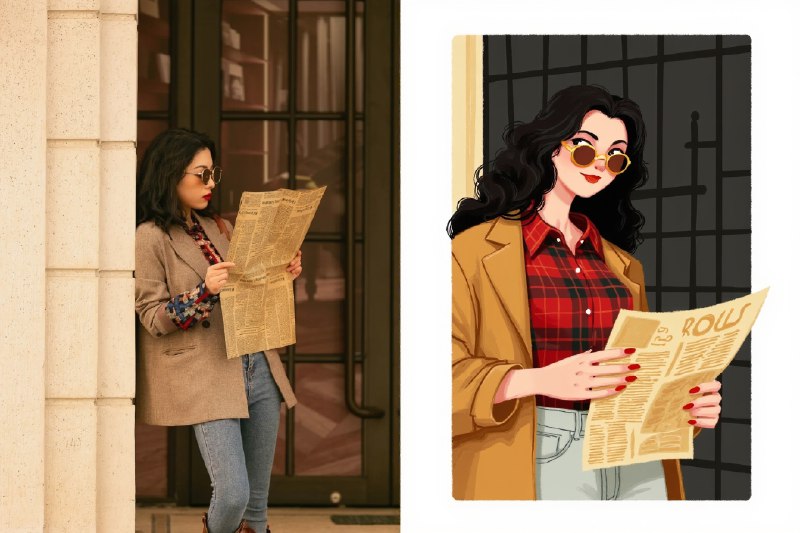
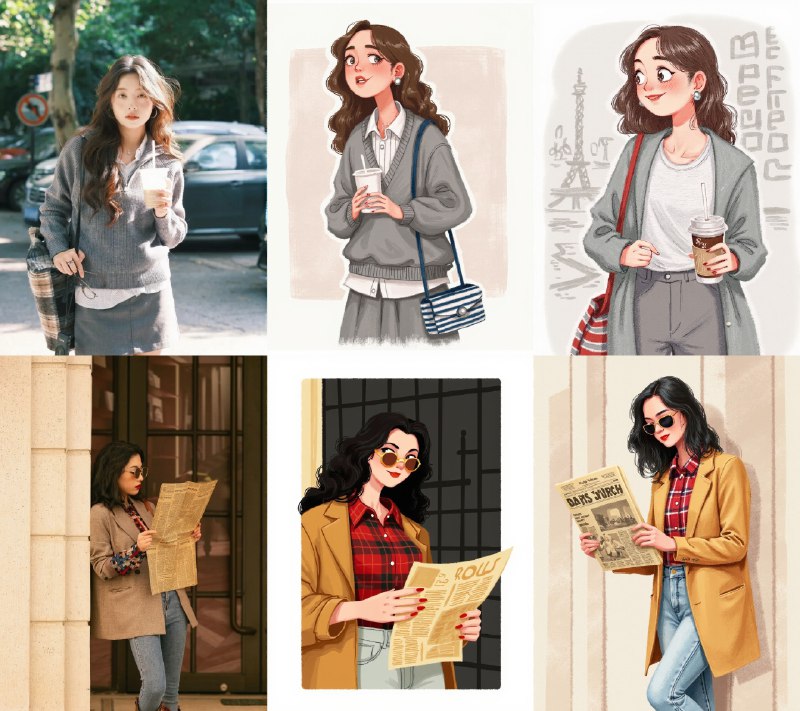
  1. 昨天发的工作流更换成另一个 Lora 就可以做照片风格化!

    昨天发的工作流更换成另一个 Lora 就可以做照片风格化!

    对于服装和姿势的还原也很好。

    有点类似米雷经常拍视频的风格,不过没有她手绘的那么精准和传神。

    结合视频可以玩起来了,需要调整的提示词我放下面了。

    首先需要下载 In Context Lora 中的 portrait-illustration Lora 。

    然后通过这个提示词获取图片描述:

    为了帮助一位视障艺术家,我们需要详细描述这幅图像的内容,包括从服装、配饰、面部特征、发型、环境、装饰等各个方面。对于出现在图中的人物,虽然不能提及具体姓名,但考虑到艺术家的特殊需求,我们需要以匿名方式描述他们的主要特征(切记不要提及真实姓名)。

    通过这个提示词和上面的图片描述获取最终的图像生成提示:

    The following is an example prompt: “The image pair showcases the transformation from reality to a stylized interpretation; [IMAGE1] the photo shows a person with a topknot, wearing a cozy yellow sweater and plaid scarf, standing in front of a shop window, while [IMAGE2] the illustrated version highlights the warm tones, adding playful, oversized shapes and bright hues, creating an animated feel with a soft, inviting background.” Please note that this is only a sample prompt and not intended to be the final output. I want you to create a very similar prompt based on the content and style of: "{style:图片描述}", which will go onto the left panel.

  2. 我一直在说,我什么也不会,也不是AI圈的人

    我一直在说,我什么也不会,也不是AI圈的人。

    每天都在从诸君身上吸收学习,之前看到Super Prompt,从中感悟到「得意忘言」,启发我去尝试Lisp写法。前几天看到徐津豪同学的Prompt,才知道原来通过Prompt去让LLM 变身类似o1 式的输出是可行的。 按这个思路尝试着练习写了Meta-Claude。

    没有大家的开源分享,也就没有这些所谓的启发和尝试。

    我再次真心地说一句,我真的什么都不会。拜谢诸师。

  3. 最近市场给人的感觉很好很兴奋,去年出来创业的都是互联网人,都是没怎么做过 AI 的,今天出来创业的绝大多数都是做了一年 AI 以后再出来的,把整个市场带入了一个不同的 level

    最近市场给人的感觉很好很兴奋,去年出来创业的都是互联网人,都是没怎么做过 AI 的,今天出来创业的绝大多数都是做了一年 AI 以后再出来的,把整个市场带入了一个不同的 level。如果未来想做 AI,还在观望可能不是一个好的策略了,只会越来越落后。

  4. DeepSeek 放出超重磅全新模型!

    DeepSeek 放出超重磅全新模型!

    - 新模型直接对标 OpenAI o1
    - 在数学、代码、复杂逻辑推理方面,实际效果媲美 o1-preview
    - 使用强化学习训练,推理过程包含大量反思和验证
    - 思维链可达上万字,并且不藏着掖着,全部为用户展示

    目前模型已经上线到官网,打开「深度思考」即可体验

    模型名称:DeepSeek-R1-Lite 预览版
    体验地址 https://chat.deepseek.com/

  5. 工作流下载:

    AI探索指南
    glif 又一个出圈爆款玩法。 用 In-Context LoRA 制作任何 Logo 的周边!! 效果好到💥,样机网站有点难受了。 我整理了他们这个工作流,做了几个国产 AI 软件的周边。 整个流程分为三个部分: - 获取 Logo 图片的描述 - 根据 Logo 图片的描述和生成意图生成图片提示词 - 将图片和提示词输入 Comfyui 工作生成 1/ 可以用下面的提示词生成关于 Logo 图片的描述: 为了帮助一位视障艺术家,我们需要详细描述这幅图像的内容,包括从摄影 (Photography)、标志设计…
    工作流下载:https://github.com/op7418/Comfyui-workflow/blob/main/FLUX/Logo%20%E5%91%A8%E8%BE%B9%E7%94%9F%E6%88%90.json

  6. glif 又一个出圈爆款玩法

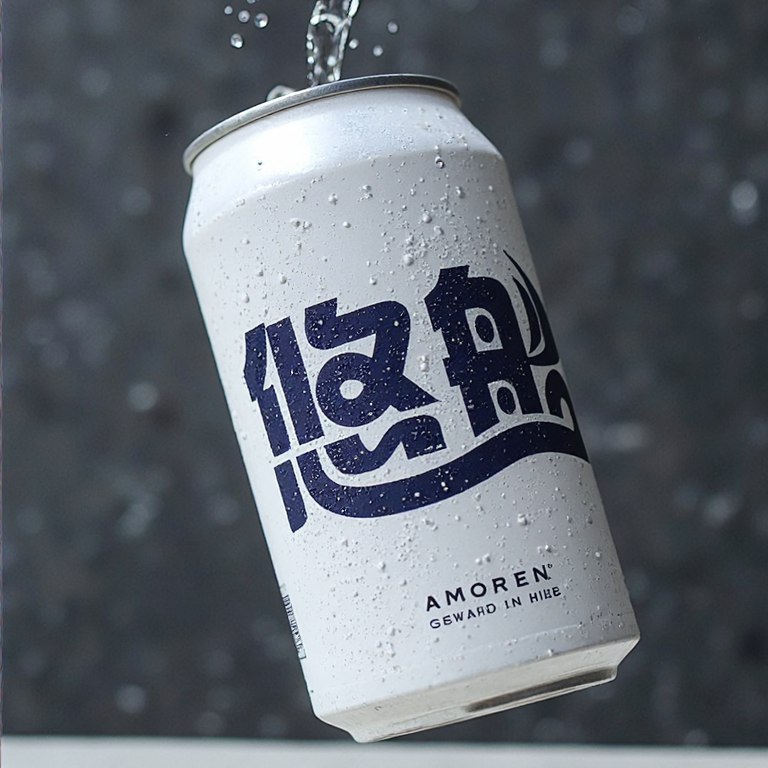
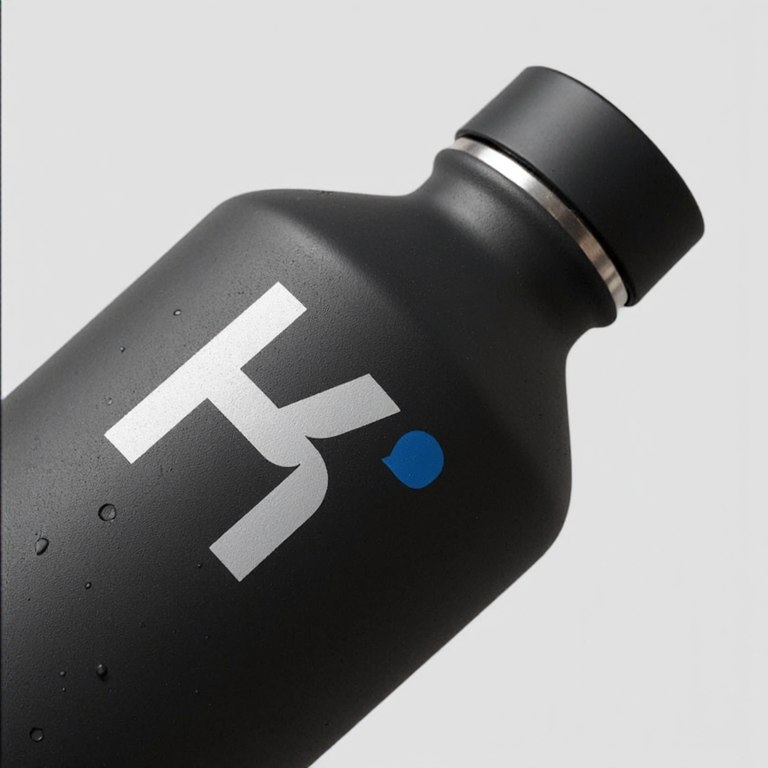
    glif 又一个出圈爆款玩法。

    用 In-Context LoRA 制作任何 Logo 的周边!!

    效果好到💥,样机网站有点难受了。

    我整理了他们这个工作流,做了几个国产 AI 软件的周边。

    整个流程分为三个部分:

    - 获取 Logo 图片的描述
    - 根据 Logo 图片的描述和生成意图生成图片提示词
    - 将图片和提示词输入 Comfyui 工作生成

    1/ 可以用下面的提示词生成关于 Logo 图片的描述:

    为了帮助一位视障艺术家,我们需要详细描述这幅图像的内容,包括从摄影 (Photography)、标志设计 (Logo Design) 到较为冷门的艺术风格等各个方面。对于出现在图中的人物,虽然不能提及具体姓名,但考虑到艺术家的特殊需求,我们需要以匿名方式描述他们的主要特征(切记不要提及真实姓名)。请直接进行描述,控制在 50 字左右。

    2/ 用 LLM 生成图像提示词

    将第一步生成的提示词填入{图像描述}位置,将你想生成的周边填入{周边描述}部分。

    这是一个提示词示例:"The pair of images highlights a logo and its real-world use for a hi-tech farming equipment; [IMAGE1] a black background showcases a logo with a stylized, fish in magenta and cyan, titled “BLINK” in an bold font, with bubble details underneath; [IMAGE2] this logo is applied as a black and white tattoo on lower back of an inmate"

    我希望你参考"{图像描述}"的内容和风格特点,创作一个类似的提示放在左侧面板。然后根据"{周边描述}"的内容,设计配套的右侧面板描述,需要表达"展示同样的内容(可以是角色、标志等)"这样的意思。直接给出提示内容,无需其他说明!开始!

    3/ 将第二步的提示词和Logo 图片放到 Comfyui 工作流就行