AI探索指南

  1. 谷歌除了 NotebookLM 之外又发布了一个新的学习工具

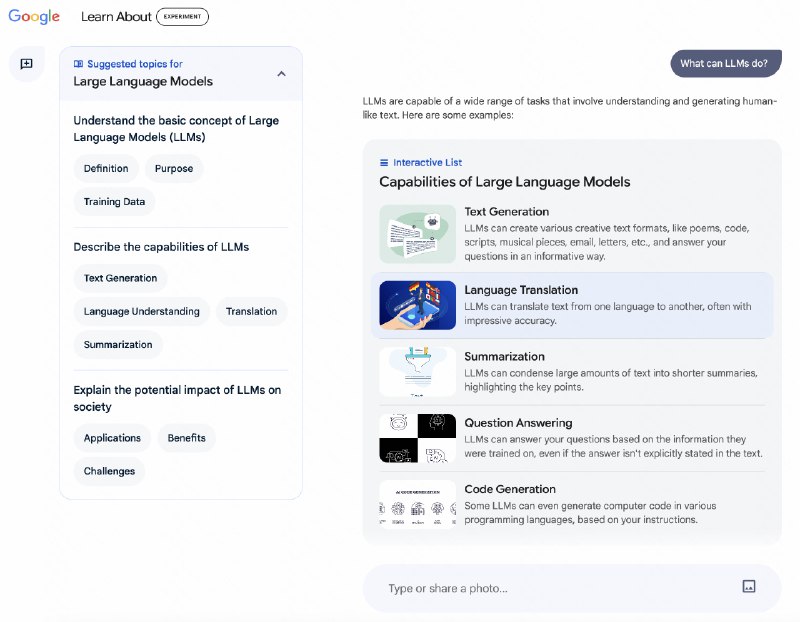
    谷歌除了 NotebookLM 之外又发布了一个新的学习工具。

    Learn About 可以根据你提出的问题给出详细的解释,而且还会推荐合适的视频教程以及文字教程。

    他还会询问你教程的难易程度,如果觉得太难就会给你制定更简单的学习计划。

    目前需要美国 IP 才能使用:https://learning.google.com/experiments/learn-about/signup

  2. LLM 是放大器, 放大的是你的思考

    LLM 是放大器, 放大的是你的思考。

    这一点既是它的卖点,也是它的罩门。

    当与它独处时, 仿佛对面坐了一位智者, 只要我能提出足够好的问题, 他就能给出相应好的回复。

    但当把它融入到产品中,推向 C 端用户市场时,面对的第一个问题: 用户跨不过思考和表达的双重门槛。

    AI 平台产品经理想尽各种办法,来尽可能降低这个门槛:预设问题,回复之后跟随问题,等等。

    最近看到的「妙刷」产品,是另一个降低门槛的思路:把思考和表达这个门槛,转换为拍照。 只需要抬手拍一张,即跨过了提供信息的门槛。

    降低用户使用门槛, 确实是个价值巨大的课题。

  3. 我的2点发现:第一点,机器人的chatgpt时刻被吹的太多了

    我的2点发现:第一点,机器人的chatgpt时刻被吹的太多了。第二点,以demo视频形式作为展示的工作太多了,这2方面营销手段都不足够再次抓人眼球。
    ChatGPT之前也有很多bot,比如说meta在2022年9月的blenderbot 3,但ChatGPT真正被大家惊呼一个原因是这样的革命性技术慢慢地在early adopter中传开了,大家亲身使用过发现他能够用来解决实际问题,比如说帮湾区的学生做题。所谓创新的扩散,从innovator慢慢扩散到early adopter,早期用户使用起来发现真的能解决一些需求,虽然不是普罗大众的需求

  4. Google AI Studio 目前已经支持 Google 搜索了,虽然这实际上是 Google 开发者的 AI 控制台,但我愿称之为目前最强的 C 端应用:

    Google AI Studio 目前已经支持 Google 搜索了,虽然这实际上是 Google 开发者的 AI 控制台,但我愿称之为目前最强的 C 端应用:
    1. 200 万 Token 上下文;
    2. 可随意修改聊天历史,带入后续的聊天,AI 回复你的内容你也可以改;
    3. 能联网搜索 Google;
    4. 能在聊天界面使用 JSON Mode;
    5. 支持上传文档、图片、音频、视频;
    5. 免费!免费!免费!
    Flash 模型每日 2000 次免费调用,Pro 模型 50 次,Pro Experiment 独立 50 次。

  5. 🔍 ChatGPT Search 来了,初体验相当惊艳~

    🔍 ChatGPT Search 来了,初体验相当惊艳~

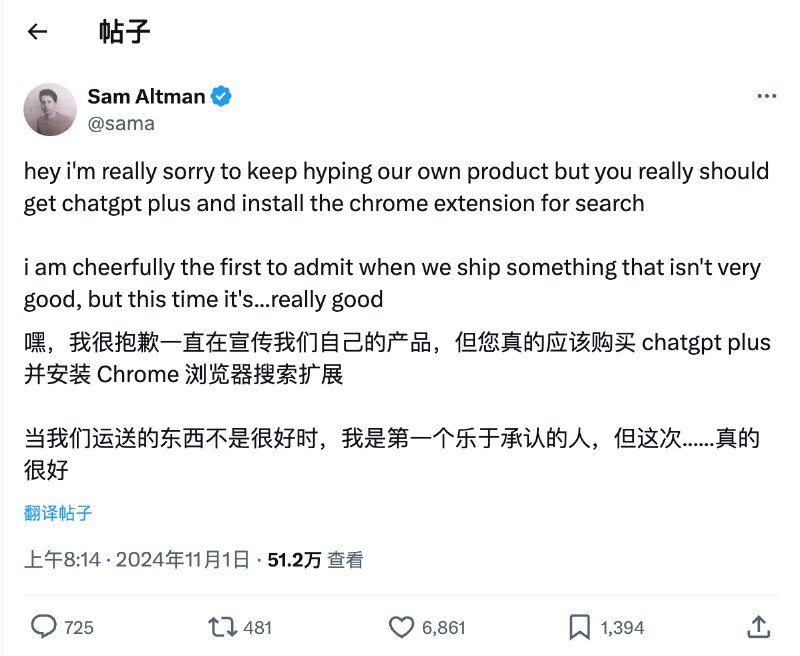
    看到 Sam Altman 罕见自荐了一个浏览器插件,令人感到十分好奇。 回想了下,Open AI到底还有哪些神秘产品没有发布?

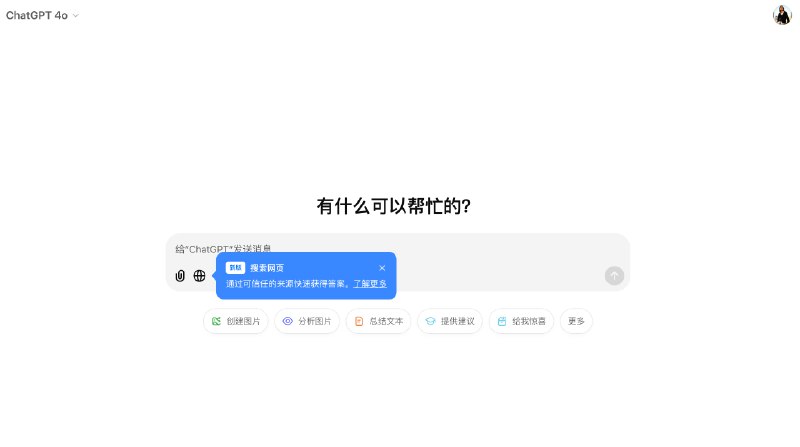
    打开ChatGPT 网页,原来Search 正式登场了。快速测试后,不得不说新产品的体验确实令人惊艳:

    - 首先是产品形态的惊喜。在输入框下方,多了个小小按钮——「搜索」。(这个登场大大超出了预期, 因为我们都是在等一个独立Search GPT)
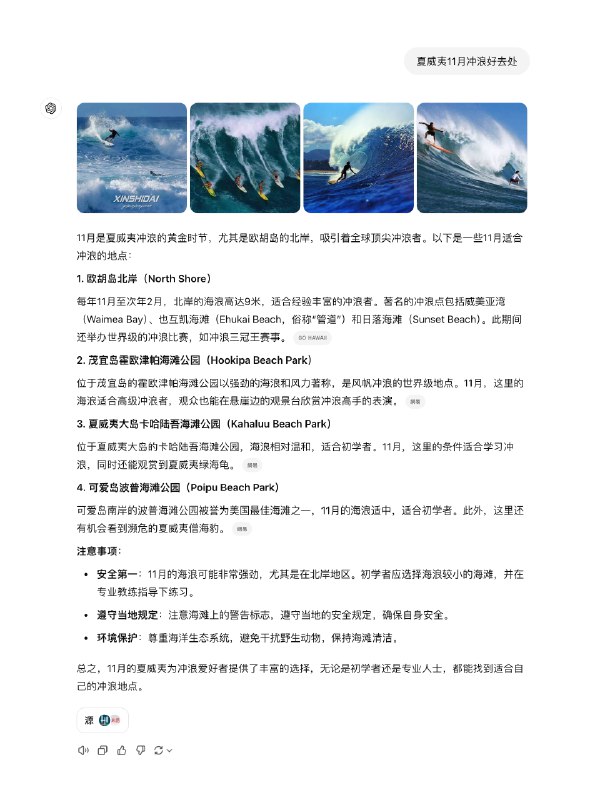
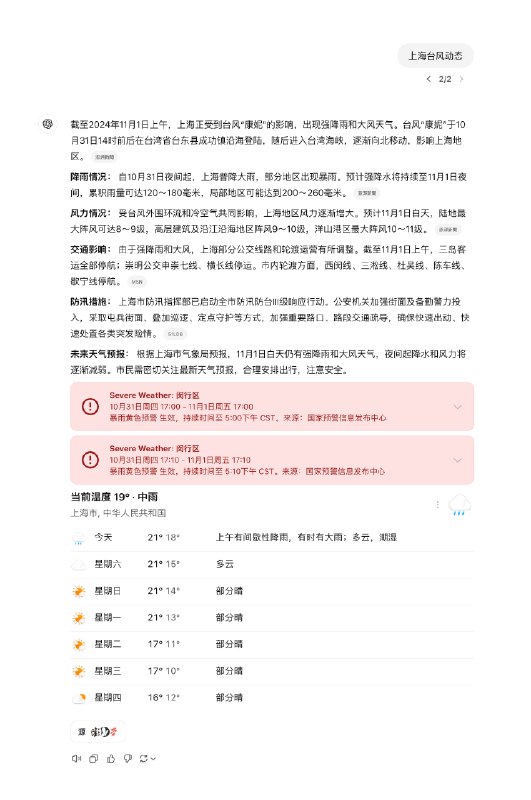
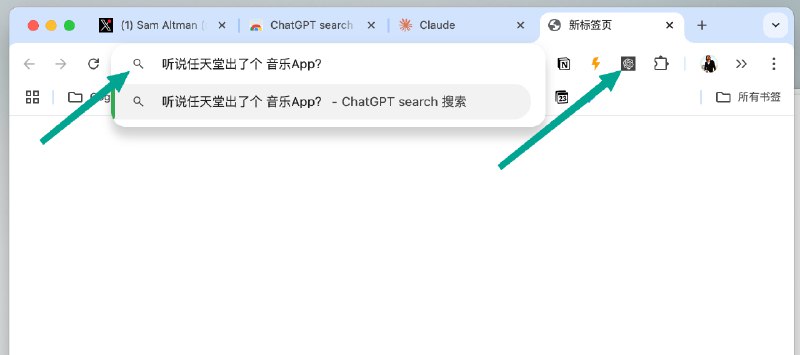
    - 然后,搜索的质量。快速测试一些实时性较高的搜索内容, 例如, 夏威夷冲浪🏄‍♀️,上海台风🌀 ,以及任天堂新App🎵; 每次查询的结果,都相当不错。
    - 即使对我这个Perplexity 深度用户来说,从性能、易用性以及美观性,ChatGPT Search都做到了一流的体验。
    - 最令人印象深刻的是输入框这里的设计,将聊天和搜索如此自然的融合,这种无缝感知是点睛之笔。

    ChatGPT 再次将AI 的打开方式带到了新高度, Bravo 👏

    🧩 One More Thing:

    推荐尝试下这个Chrome小插件, ChatGPT Search 。我在随附的截图(5~6)中展示了用法:在浏览器输入框直接,输入搜索内容,直接进入结果页。 相信你多试几次,可能就会离不开了。
    https://chromewebstore.google.com/detail/chatgpt-search/ejcfepkfckglbgocfkanmcdngdijcgld

  6. **已经有超过 1 万个年轻人用「AI 遗嘱」写下自己的遗嘱了

    **已经有超过 1 万个年轻人用「AI 遗嘱」写下自己的遗嘱了。**

    「AI 遗嘱」是什么?是新世相发布的一个产品,帮助人们写遗嘱。

    首先,别被"遗嘱"这个词吓到。这不是什么不吉利的事,恰恰相反,它是一次让人可以深度思考生命的机会。我们希望通过这个产品,激发年轻人去直面死亡、进而思考生命中真正重要的事情是哪些,真正重要的人是谁。

    「AI 遗嘱」怎么写呢?并不是让 AI 帮你写,而是请 AI 来对你进行采访,AI 很会引导,它会不断追问细节、追问答案背后的深层思考。AI 大概会提出 10 个问题,之后, AI 将根据对话,整理出一篇完整的遗嘱。

    目前,已经有超过 10000 人在 AI 的帮助下写了自己的遗嘱,也欢迎你来试一试。

    通过写遗嘱,在与死亡四目相对后,我们或许能看清,人究竟在为什么而活。

    从对死亡的思索中,获得对生的领悟。

    **祝你聊得愉快。祝你活得尽兴。**

    Invalid media: video

  7. AI探索指南
    Midjourney 中国实验室产品 – 悠船同步上线区域重绘(inpainting)和转绘(style transfer)功能啦~! 盼 MJ 出这功能得有一年了吧,时间过得好快。 世界第一梯队的模型能力就是强~ 要在 comfy 里完成同样的需求,需要搭建很复杂的工作流,还得有本地算力,在悠船很轻松就搞好了~ 能用中文写 prompt 方便好多,不过手动区域涂抹还是有些麻烦,感觉以后补上 SAM 自动分割会方便许多。 测试地址:https://desktop.youchuan.cn/

  8. Midjourney 中国实验室产品 – 悠船同步上线区域重绘(inpainting)和转绘(style transfer)功能啦~!

    Midjourney 中国实验室产品 – 悠船同步上线区域重绘(inpainting)和转绘(style transfer)功能啦~!

    盼 MJ 出这功能得有一年了吧,时间过得好快。

    世界第一梯队的模型能力就是强~ 要在 comfy 里完成同样的需求,需要搭建很复杂的工作流,还得有本地算力,在悠船很轻松就搞好了~

    能用中文写 prompt 方便好多,不过手动区域涂抹还是有些麻烦,感觉以后补上 SAM 自动分割会方便许多。

    测试地址:https://desktop.youchuan.cn/

  9. - 计算不同维度的错误率并识别分布规律

    AI探索指南
    🎯 Critique Shadowing: 一个让AI稳定输出优质内容的实用工作流 我相信很多AI团队和我们一样,都头疼这个工程问题:如何保证AI生成质量的优质与稳定? fine-tune也好,RAG也好,RL也好,结合具体的业务场景,我们也花了很多精力研究最适用的、更低成本、ROI更高的方法。 不得不说,最近发现的Critique Shadowing 工作流,让我觉得很有启发💡 这个方法来自 Hamel Husain 最新发表的一篇重磅文章🔗https://hamel.dev/blog/posts/llm…
    - 计算不同维度的错误率并识别分布规律
    - 必要时建立专门的评估器
    - 出现系统性问题时返回步骤3

    👉 个人实践启发

    在涉及到我们团队具体的工程实践上,我理解 Critique Shadowing 相当于在向用户输出output前的workflow里,自行加了一步evaluation,评估通过则展示给用户,评估不通过则返回继续生成再评估,循环往复直至评估通过为止再输出。流程如下:

    A[用户输入] --> B[LLM生成回答]
    B --> C[Critique评估器]
    C -->|通过| D[展示给用户]
    C -->|不通过| E[重新生成/优化]
    E --> B

    再进一步地,我还想到,也可以通过 Critique Shadowing 的评估结果来指导 prompt 优化。流程如下:

    A[用户输入] --> B[LLM生成回答]
    B --> C[Critique评估器]
    C -->|不通过| D[分析不通过原因]
    D --> E[自动调整Prompt]
    E --> B
    C -->|通过| F[记录通过模式]
    F --> G[更新Prompt库]

    总结来看,这个方法特别适合内容质量控制、代码审查自动化、用户反馈分析等需要专业判断同时又面临大规模数据处理的场景。

    但是也很显然,这个方法论明显的弊端就是系统的复杂度及其token成本。实践中首先还是要基于自己的业务场景做合理评估,以ROI为导向,选择最适合自己的LLM质量控制策略。

    我也很好奇大家都是怎么解决AI生成质量的优质及稳定性问题的?以及大家都在做哪些内容场景?不同的内容场景对内容质量及稳定性的需求差异还是挺明显的。

    大家有什么好思路或者心得体会,也求分享😊

  10. 🎯 Critique Shadowing:

    🎯 Critique Shadowing:
    一个让AI稳定输出优质内容的实用工作流

    我相信很多AI团队和我们一样,都头疼这个工程问题:如何保证AI生成质量的优质与稳定?

    fine-tune也好,RAG也好,RL也好,结合具体的业务场景,我们也花了很多精力研究最适用的、更低成本、ROI更高的方法。

    不得不说,最近发现的Critique Shadowing 工作流,让我觉得很有启发💡

    这个方法来自 Hamel Husain 最新发表的一篇重磅文章🔗https://hamel.dev/blog/posts/llm-judge/,整整 6000 字的干货。

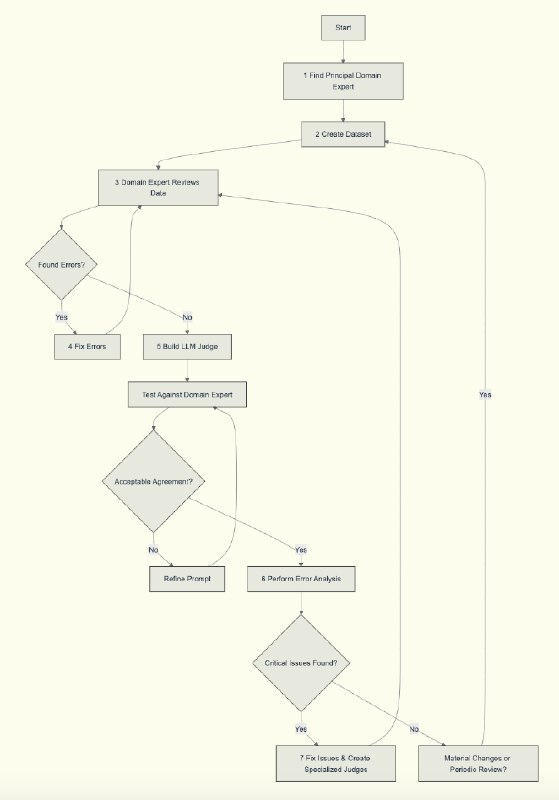
    这个工作流本质上是在构建一个能够对齐领域专家判断的 LLM 评估系统。整个工作流包括:

    1. 首先找到真正的领域专家
    2. 建立多样化的测试数据集
    3. 让专家进行系统评判和详细解释
    4. 根据反馈进行迭代优化
    5. 构建和训练 LLM 评判器
    6. 进行全方位的错误分析

    这个工作流通过系统化地将专家经验转化为可扩展的 AI 评估系统,特别适合那些需要专业判断但又面临大规模数据的场景。

    这也让我想起 Hamel 之前那篇广受好评的 🔗https://hamel.dev/blog/posts/evals/index.html,都是非常务实的方法论。

    在我看来,Critique Shadowing 的价值在于它不是纯理论的框架,而是一个能够真正落地、能够帮助团队构建可信赖的 AI 评估体系的方法。

    👉 工作流程详解

    1. 领域专家选择(Principal Domain Expert)
    - 需具备深入的领域知识和丰富实践经验
    - 能够清晰表达判断标准和评判理由
    - 愿意参与迭代优化过程

    2. 数据集创建
    - 生成覆盖所有用例的多样化examples
    - 结合真实和合成的用户交互数据
    - 从小规模高质量样本开始,逐步扩充

    3. 专家评审
    - 进行通过/不通过的基础判断
    - 提供详细的评判理由(用于训练 LLM)
    - 记录关键决策点和评判标准

    4. 错误修正
    - 发现问题后修正并返回步骤3进行专家验证
    - 持续积累和分类错误模式
    - 重复验证直至专家确认问题解决

    5. LLM 评判器构建
    - 将专家示例转化为 few-shot examples
    - 测试与专家判断的一致性
    - 持续优化prompt直至达到满意的一致性水平

    6. 错误分析与优化