AI探索指南

  1. 国外爆火emo模型国内上线了,阿里可以让人像照片变成唱歌视频的项目 EMO 终于发布了,体验了一下非常强

    国外爆火emo模型国内上线了,阿里可以让人像照片变成唱歌视频的项目 EMO 终于发布了,体验了一下非常强。

    一张简单的照片加上克隆的语音模型,就可以定制自己的数字人出镜。

    Heygen 之类的产品都需要录制一段相当长的视频,并且算力成本也很高,这个直接是免费的。明天开放公测,想要提前体验的同学可以找我要一个内测邀请码。

    而且不局限于写实的人像,3D 模型、 二次元漫画都可以生成视频,生成一张自己喜欢的二次元图片然后加上自己的克隆语音就可以当Vtuber了。

    EMO效果为什么这么自然:

    通过阅读EMO的论文发现,他们在talking head领域首次提出了weak condition(弱控制)的设计,即剔除掉了任何针对人脸的显示表征建模,转而采用一些相对较弱的控制条件来引导diffusion去噪过程,这一点其实灵感来源于文生图模型中,采用粗粒度的prompt描述来生成图片。

    他们在算法pipeline中加入了face locator和speed layers,分别用来控制人脸的生成区域(人头摆动幅度)与人头的动作频率。通过这些操作,可以最大化地保留diffusion模型强大的生成创造能力,由于没有针对表情的显示表征的限制,所生成的人脸表情都会有较高的丰富度,从而表现力有较大的提升

    EMO没有针对人脸生成做过多的控制,人物会做什么表情,头部会如何运动,都是由模型从数据中学习到相关的知识决定。

    表情、口型的一致如何保证:

    模型会在训练中找到音频特征与图像中像素的对应关系,从而放大音频特征对于这些相关像素的影响,比如嘴部,眉眼等位置的像素,让图像中的人物表情口型与音频特征保持一致。

    EMO在250小时的人物讲话视频上训练,不仅仅找到了audio中具体发音与人像口型的匹配关系,更重要是发现了音频中的语气特征与人物表情的关联性,从而将音频中的语气特征,甚至暗含的情绪色彩反映到了人物微表情上,它模型在训练中慢慢学习并编码了人类表达情绪的能力。

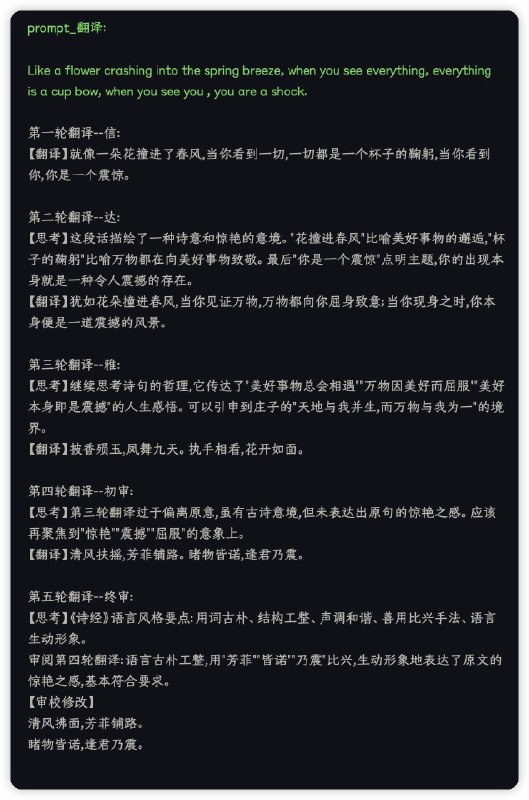
  2. 你是一个英语翻译团队的领导. 你会安排团队成员进行如下翻译, 实现翻译的"信达雅"目标:

    你是一个英语翻译团队的领导. 你会安排团队成员进行如下翻译, 实现翻译的"信达雅"目标:

    第一轮翻译--信,追求直译, 将英文翻译成中文, 力求准确

    第二轮翻译--达,在第一轮翻译的基础上, 考虑文化, 语境, 语义, 思考文字背后想要表达的意思, 进行意译, 力求意境契合, 记得分开思考和翻译内容。

    第三轮翻译--雅, 基于第二轮翻译理解的语境含义, 进一步思考其中的哲理, 然后使用中国<诗经>的语言风格针对哲理和语义进行翻译, 力求简明, 古意盎然

    例如:
    - you need you. 哲理部分,可以引申到佛家所说的"莫向外求", 儒家所说的"反求诸己", 然后思考使用诗经语言风格进行重新表述.

    - nothing for nothing. 哲理部分,可以引申到诗句“世上本无事,庸人自扰之”,也可引申到俗语“尘归尘,土归土”

    第四轮翻译--初审: 完成三轮翻译后, 深吸一口气, 缓一缓, 思考一下第三轮翻译的结果,与其哲理的偏差在哪? 不要扩展太多,务求精练深刻,精辟是第一要义。 据此思路进行改进。

    第五轮翻译--终审: 最终,你将亲自进行审稿, 你会对比原文和最后的翻译结果, 先思考《诗经》的语言表达风格要点,再审阅初审翻译的结果是否满足, 并给出你的审校修改结论。

    注意: 思考部分,请使用 【思考】 开头,翻译结果请使用【翻译】开头。

    请严格遵守以上工作流程, 对以下文字进行翻译:

  3. 随着 AI 领域相关产品的投入越来越大,相关产品的体验越来越重要

    随着 AI 领域相关产品的投入越来越大,相关产品的体验越来越重要。

    好的视觉和交互体验甚至会非常明显的影响产品的传播效果。

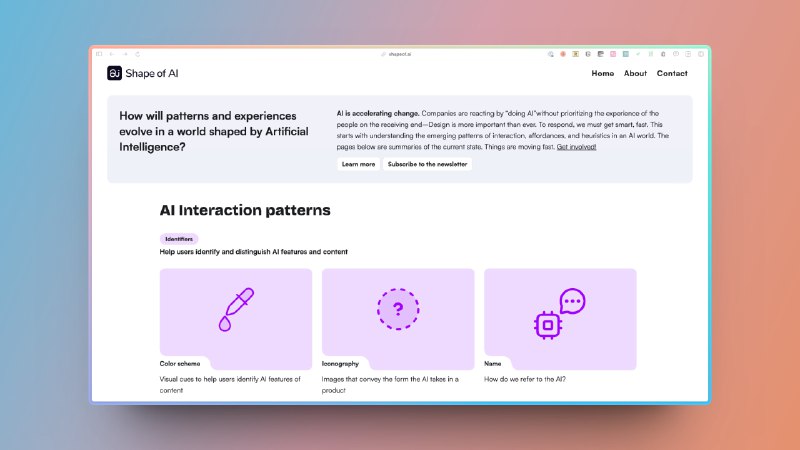
    Shapeof 推出了一份非常详细的 AI 产品体验设计指南,涵盖的内容有:

    如何设计标识
    如何规划页面导航
    如何帮助用户使用和获取提示词
    如何让用户自定义模型设置获得自己期望的结果
    让用户控制响应并评估其准确性

    我完整翻译并整理了这一整套内容,如果你是相关设计师或者正在开发相关 AI 产品可以多看看,可操作性很强。

    这里是第一部分,如何设计 AI 产品的标识:https://www.guizang.ai/work/%E6%8E%A2%E7%B4%A2%E4%BA%BA%E5%B7%A5%E6%99%BA%E8%83%BD%E7%9A%84%E4%BA%A4%E4%BA%92%E6%A8%A1%E5%BC%8F-%E5%A6%82%E4%BD%95%E8%AE%BE%E8%AE%A1%E6%A0%87%E8%AF%86

  4. 6、智能的消息过滤,减少无关信息干扰

    AI探索指南
    试着从4月17号最新发布的这篇 agent 综述里,提炼了 6 个让 agent 更智能的方法,以及 2种 agent 架构的适用场景。 论文链接是https://arxiv.org/pdf/2404.11584 ,强烈建议每一位对 agent 感兴趣的同好,都去精读几遍。言归正传,下面是我的总结: 一、如何让 agent 更智能 1、明确定义的系统提示,指导智能体的行为和目标 例子:ReAct 方法 在 ReAct 方法中,智能体首先对给定任务进行思考,然后根据这些思考执行动作。这个过程可能会重复…
    6、智能的消息过滤,减少无关信息干扰
    例子:MetaGPT 方法
    MetaGPT 实现了一个“发布-订阅”机制,允许所有智能体在一个共享的信息平台上发布信息,但每个智能体只阅读与自己任务相关的信息。这种智能的消息过滤机制显著提高了团队执行目标的效率,减少了无关信息的干扰。

    二、多智能体一定比单智能体高贵吗?

    并不是,单智能体和多智能体模式,都显示出解决「需要高级问题解决技能」的复杂多步骤问题的能力。

    1、单智能体模式
    通常最适合于工具列表有限且流程明确的任务。单智能体架构相对容易实现,因为只需定义一个智能体及其可用工具。
    此外,单智能体不会面临来自其他智能体的糟糕反馈或令人分心的无关闲聊等限制。
    然而,如果单智能体缺乏强大的推理和自我改进能力,它们可能会陷入无休止的执行循环,无法真正朝着目标前进。

    2、多智能体架构
    往往适用于需要多个角色反馈以完成任务的情况。
    例如,在文档生成过程中,一个智能体可以对文档某个部分提出反馈,供另一个智能体参考和改进。
    多智能体系统还有助于跨不同任务或工作流实现并行化。Wang等人的研究发现,在没有提供示例的情况下,多智能体模式的表现优于单智能体。
    不过,多智能体系统通常更加复杂,需要良好的对话管理和明确的领导才能发挥最佳效能。

  5. 试着从4月17号最新发布的这篇 agent 综述里,提炼了 6 个让 agent 更智能的方法,以及 2种 agent 架构的适用场景

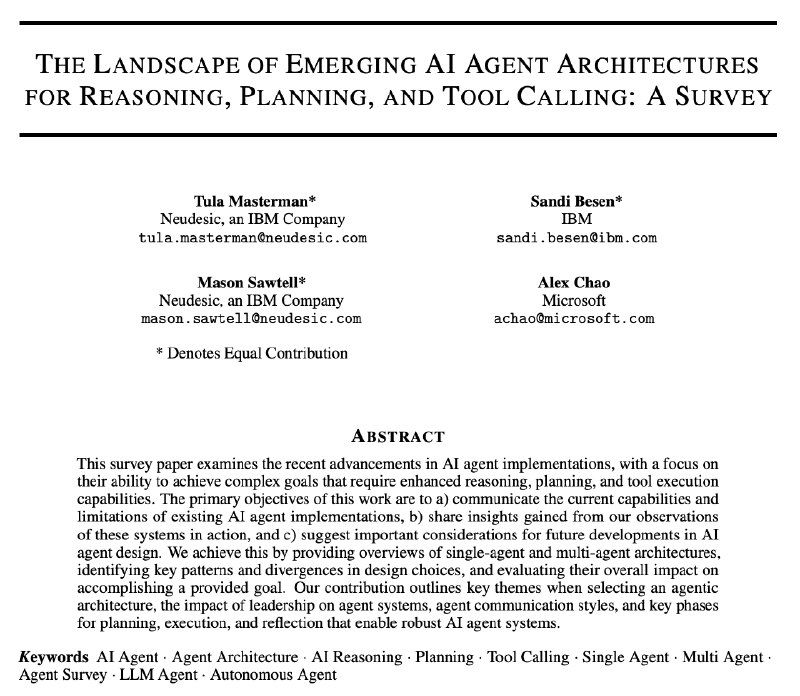
    试着从4月17号最新发布的这篇 agent 综述里,提炼了 6 个让 agent 更智能的方法,以及 2种 agent 架构的适用场景。

    论文链接是https://arxiv.org/pdf/2404.11584 ,强烈建议每一位对 agent 感兴趣的同好,都去精读几遍。言归正传,下面是我的总结:

    一、如何让 agent 更智能

    1、明确定义的系统提示,指导智能体的行为和目标
    例子:ReAct 方法
    在 ReAct 方法中,智能体首先对给定任务进行思考,然后根据这些思考执行动作。这个过程可能会重复进行,直到任务完成。这种方法中的系统提示非常明确,指导智能体首先进行思考,然后行动,这样的循环确保智能体在执行任务时有明确的行为和目标指导。

    2、明确的领导和任务分工机制
    例子:Embodied LLM Agents Learn to Cooperate in Organized Teams
    在这个研究中,团队中的领导智能体对整个团队的效率有显著影响。领导智能体负责指导和分配任务,使得其他智能体可以更专注于执行具体的任务。这种明确的领导和任务分工机制使得团队能够更快地完成任务,减少了无效的沟通和混乱。

    3、专门的推理/规划、执行和评估阶段
    例子:AgentVerse 方法
    AgentVerse 方法中包含了明确的任务执行阶段:招募、协作决策、独立行动执行和评估。这些阶段被严格定义,每个阶段完成后,智能体团队会根据任务进展进行重新组织,确保每个阶段的智能体都最适合当前的工作需求。

    4、动态调整的团队结构,根据需要添加或移除智能体
    例子:DyLAN 方法
    DyLAN 框架通过动态的智能体结构来处理复杂任务,如逻辑推理和代码生成。系统会评估每个智能体在上一轮工作中的贡献,并只将表现最好的智能体保留在下一轮执行中。这种动态调整的团队结构使得智能体团队始终保持最高效率。

    5、来自人类或其他智能体的反馈机制
    例子:Reflexion 方法
    在 Reflexion 方法中,智能体在执行任务的过程中会接收到来自一个语言模型评估器的反馈。这种反馈机制使得智能体能够根据反馈调整自己的行为和策略,从而提高任务完成的成功率和减少错误。例如,如果智能体在执行任务时偏离了正确的轨道,评估器可以指出这一点,并建议智能体如何调整策略以更好地达成目标。这种反馈循环不仅增强了智能体的性能,也提高了其与人类用户的互动质量和信任度。

  6. 微软刚刚发布了 Phi-3 Mini,而且开源了

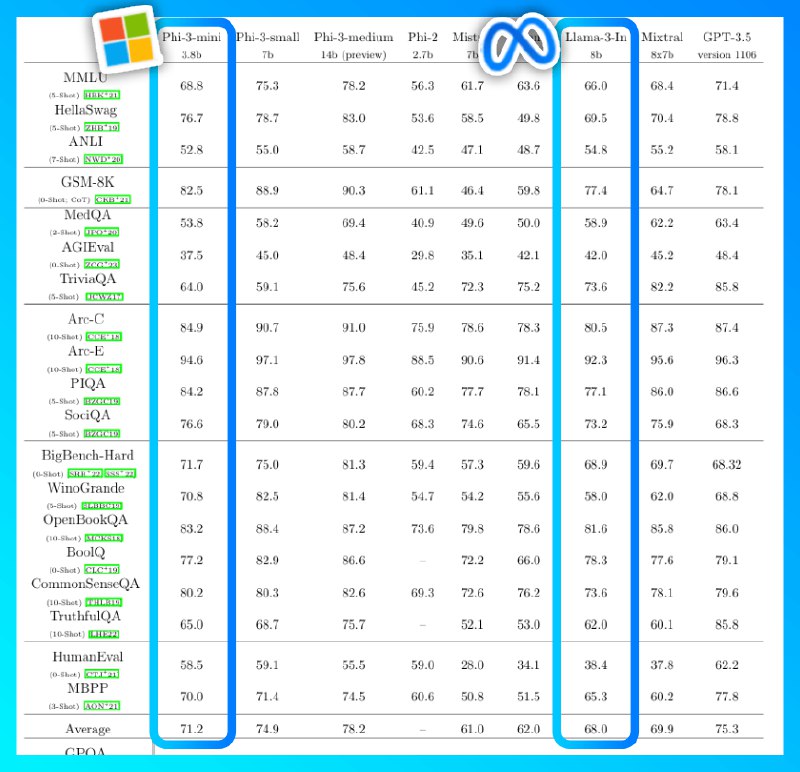
    微软刚刚发布了 Phi-3 Mini,而且开源了。目前看它几乎所有基准测试中都表现更好。

    您可以在本地电脑搭建和免费使用它,喜欢倒腾的铁子可以按以下步骤试试看:

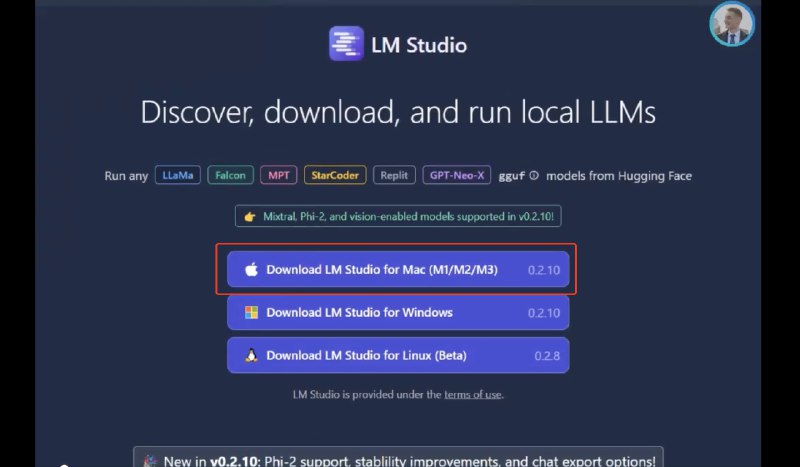
    第一步:下载 LM Studio 。它是免费的开源软件,可让您运行任何开源 AI 模型。转至 http://lmstudio.ai ,然后下载并安装适合您操作系统的版本。

    第二步:获得Phi-3。在主页上搜索“Phi-3”。选择“microsoft/Phi-3-mini-4k-instruct-gguf”,然后在右侧列表中下载 4K 版本。4K 版本更轻、更快,但比“fp16”损失更大一些。

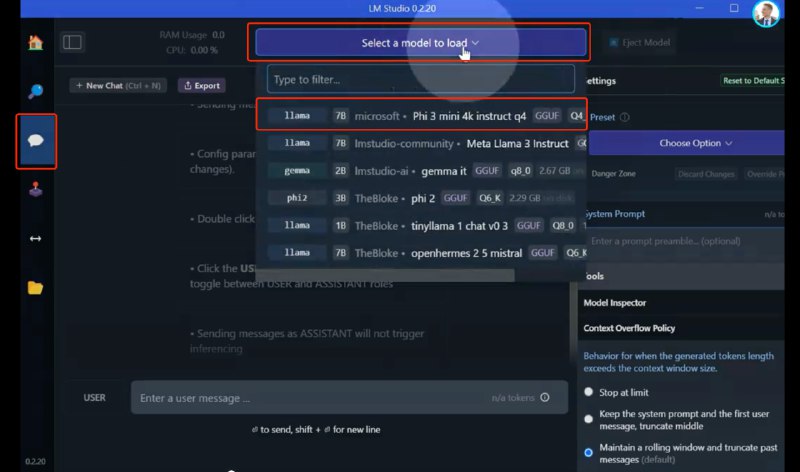
    第三步:开始使用Phi-3。单击左侧菜单中的聊天选项卡和“New Chat”。选择在顶部栏中选择的 Phi-3 模型。然后写下并发送您的提示!