AI探索指南

  1. Prompting 的核心技能可能只有一个……

    Prompting 的核心技能可能只有一个……

    启动效应,是大脑最有趣的认知活动之一。每当一段旋律、一个拼图或一段故事出现,大脑就开始疯狂运算,猜测整个景观;不直觉的开始分析因果、构建起一个个可能的解释。

    不信的话,试着放松下来,聆听我这唱一首小曲:一闪一闪亮晶晶……(请接龙)

    启动效应的本质之一是基于先验的预测,它是多模态和多感官的。简单类比的话,Prompting 就是你如何激活大模型知识结构的「启动」。

    一旦能深刻意识到这一点,如何提升你与 AI 对话的技能、有效 激活 LLMs 效能的方法就会涌现出来了。

    通过成百上千小时的反复练习,你将意识到:真正提升 Prompt 核心技能在于,持续深化于你的认知体系。

    你无法提出你不知道的问题。

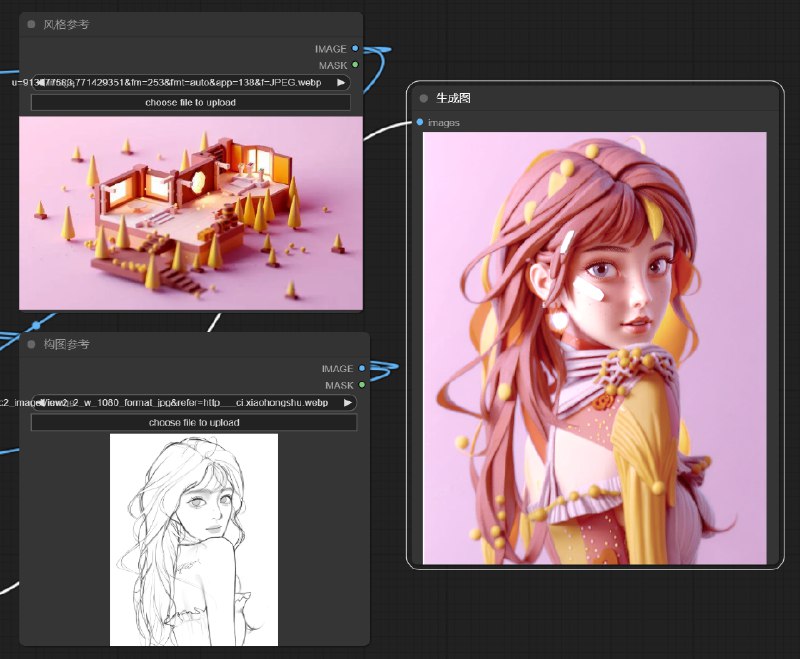
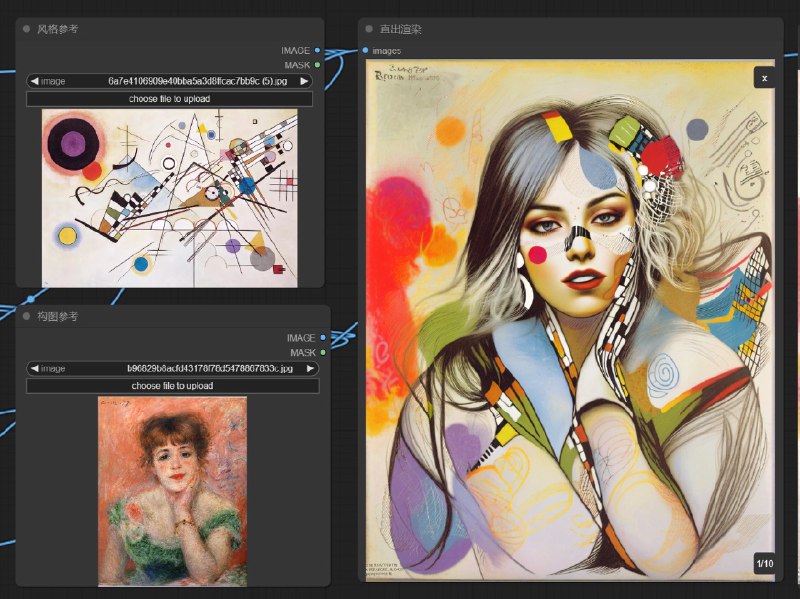
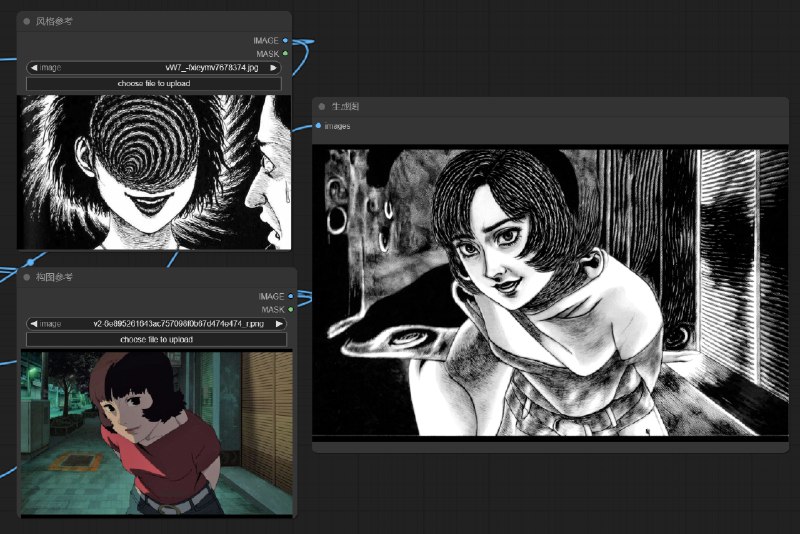
  2. 更新后的 IPAdapter 可以风格和构图分别参考了,感觉风格LoRA越来越不需要了👁️

    更新后的 IPAdapter 可以风格和构图分别参考了,感觉风格LoRA越来越不需要了👁️

    btw 图二我真的好喜欢,把头发改成了五线谱+琴键,让我觉得 AI 真的好懂康定斯基

    项目地址:https://github.com/cubiq/ComfyUI_IPAdapter_plus

    InstantX 的团队和 ComfyUI 的插件作者 Matteo Spinelli 联名发了关于 InstantStyle 的 Paper!也开源了!

    🔸Code: github.com/InstantStyle/InstantStyle
    🔸Project Page: instantstyle.github.io/

  3. ❇️❇️目前工程实践上,大家把优化的重点基本都放在了retrieve环节里,这里面涉及三个重要的问题:

    AI探索指南
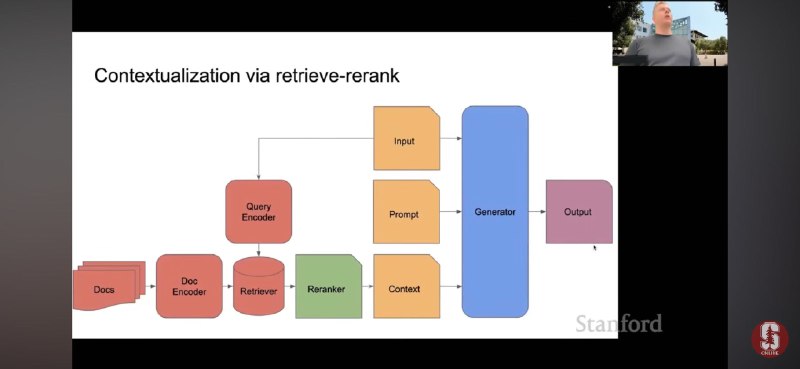
    斯坦福这节课讲清楚了LLM做RAG所有最重要的问题。 这节课就是传说中的Stanford CS25中的一节讲座。授课人就是RAG论文的作者之一Douwe Kiela,课程中他分享了一个检索增强语言模型的架构图。 这张图重要到让我觉得,做RAG只要记住这一张图就够了。所有相关概念和工程实践中的权衡,全都涵盖在这张图的架构和问题中了。 这个架构主要包括input、prompt、通过retriever检索增强生成的context,然后把这三部分一起输入给generator即模型,最终输出output作为结果。…
    ❇️❇️目前工程实践上,大家把优化的重点基本都放在了retrieve环节里,这里面涉及三个重要的问题:
    1️⃣how and what do I retrieve:从传统的相似性检索、文本检索,到目前最常用的依托于embedding的语义检索,大家在实践中仍在不断迭代。Kiela后面也提到有研究希望把整个retriever过程做成一个模型,他也在课程中构想未来应该把retriever的训练也纳入到LLM的训练架构中。
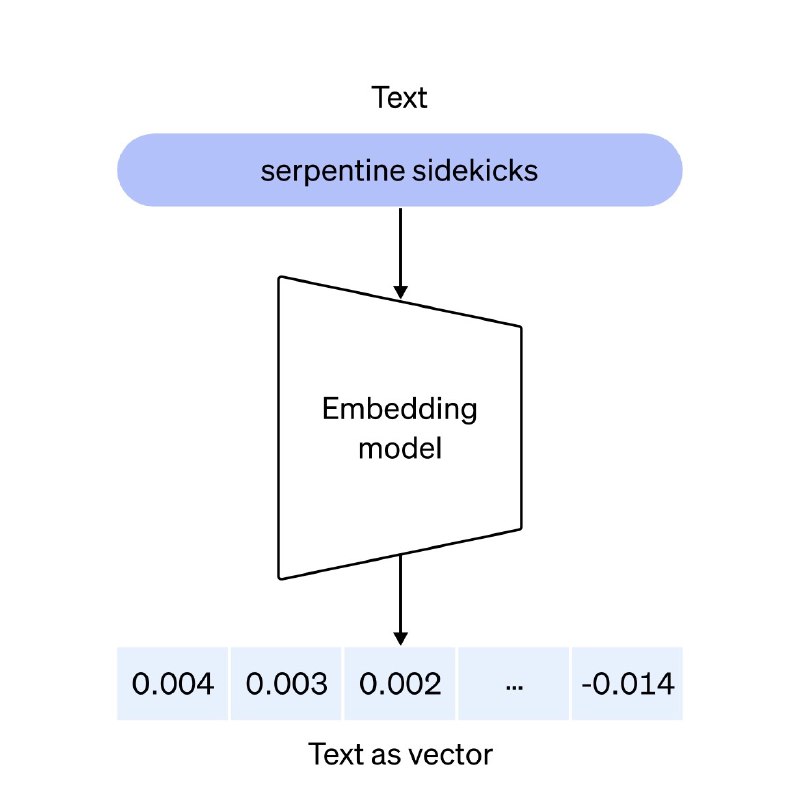
    🌟文本的embedding可简化理解为文本的向量化表达,并且可根据不同文本的向量化表达,判断出文本之间语义的远近亲疏关系。
    🌟目前的文本emebedding也都是通过模型来实现的,这类模型也在不断迭代。OpenAI在今年1月份推出了text-embedding-3(small和large两版),相比其2022年12月推出的ada-002模型,在性能上获得了显著提升。
    🌟用于多语言检索的常用基准(MIRACL)平均分数已从 31.4%(ada-002)增加到 44.0%(3-small)和54.9%(3-large)。
    🌟附图之一是OpenAI对其text emebedding模型作用机制的示意。
    2️⃣When to retrieve: 一般就两种思路。一种是在获得检索范围后即retrieve,另一种是让模型判断何时retrieve。
    3️⃣How to encode: 如何编码也直接影响了如何检索的过程。

    ❇️❇️其他问题:
    1️⃣how to pre-process: 实际上强调就是input要包含system prompt,可设定角色、技能、任务、工作流、限制条件等。
    2️⃣how to prompt: 涉及提示词工程的方法论。
    3️⃣how to pass context: 可以把context作为prompt的一部分以文本形式输入,也可通过代码的方式代入。
    4️⃣how to post-process: 比如格式化输出的处理,如固定输出json格式,或固定在末尾输出reference列表等。
    5️⃣how to verify: 指的是如何验证output的效果或质量,比如验证output与知识库的相关性、准确性等。

    ❇️❇️最后,还有关于RAG整体架构的审视框架:
    1️⃣How to optimize: 各环节哪些地方可以优化。架构中已经列出的问题都是思考的重点。
    2️⃣How to learn: 这里的learn应该指的是机器学习的learn,探讨各环节从software 1.0的静态架构向机器学习和software 2.0的演进。
    3️⃣how to scale: 如何应对规模化的问题。
    🌟比如关于知识库如何chunk、何时编码,在知识库过大时就不适合提前预处理好chunk和编码。或者大量用户同时prompt该如何应对。

    ❇️❇️前段时间判断过2024年会是RAG应用爆发的一年https://m.okjike.com/originalPosts/6602dca712ed2fda687ec0a3?s=ewoidSI6ICI2M2VlMjQ0NjhhMGY3NzVjODQyMmY1NzEiCn0=,自己在2B业务中也涉及RAG工程的落地,所以花了些精力来学习这节课。以上内容夹杂了不少自己的个人理解,欢迎批评指正,一起交流学习~

    ❇️❇️links:
    🌟Stanford CS25 V4 2024春季课程(面向公众开放,有人想一起学习搭子么?) https://web.stanford.edu/class/cs25/
    🌟Stanford CS25 V3: Retrieval Augmented Language Models https://www.youtube.com/watch?v=mE7IDf2SmJg
    🌟RAG论文原文 https://arxiv.org/abs/2005.11401
    🌟OpenAI text-embedding-3 models https://openai.com/blog/new-embedding-models-and-api-updates?t
    🌟OpenAI text-embedding-ada-002 model https://openai.com/blog/new-and-improved-embedding-model?t
    🌟Software 2.0 by Andrej Karpathy https://karpathy.medium.com/software-2-0-a64152b37c35
    🌟 Kiela在讲这节课几个月后在其创立的Contextual AI正式推出RAG 2.0 https://contextual.ai/introducing-rag2/

  4. 斯坦福这节课讲清楚了LLM做RAG所有最重要的问题

    斯坦福这节课讲清楚了LLM做RAG所有最重要的问题。

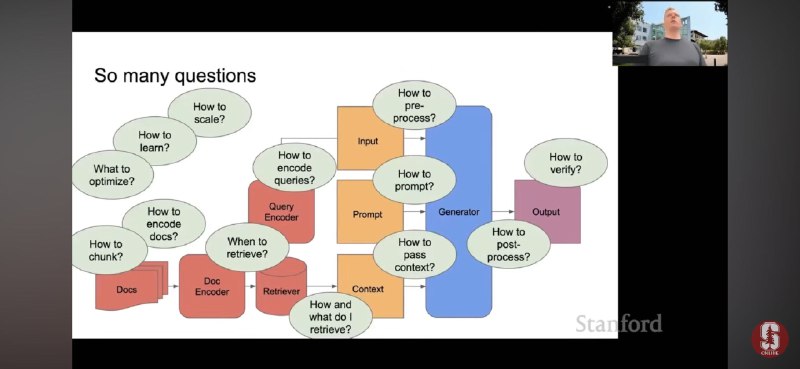
    这节课就是传说中的Stanford CS25中的一节讲座。授课人就是RAG论文的作者之一Douwe Kiela,课程中他分享了一个检索增强语言模型的架构图。

    这张图重要到让我觉得,做RAG只要记住这一张图就够了。所有相关概念和工程实践中的权衡,全都涵盖在这张图的架构和问题中了。

    这个架构主要包括input、prompt、通过retriever检索增强生成的context,然后把这三部分一起输入给generator即模型,最终输出output作为结果。

    ❇️❇️关于这几个核心概念,值得注意的是:
    1️⃣input和prompt的区别和联系在于,input可理解为既包含system prompt,又包含用户输入的检索范围的指向,而prompt则强调用户输入的指令。
    🌟以公司知识库RAG举例,比如用户输入chatbot的内容为"检索公司2023年的财务数据并生成总结报告",其中"公司2023年的财务数据"是对公司知识库检索范围的指向,应理解为input的一部分,而"检索并生成总结报告"则是指令,应理解为prompt。
    2️⃣retriever的作用机制,我理解类似于在图书馆借书的过程,提供书名(query)-系统查找图书编号(query编码)-对应书架书籍编号(docs编码)-找到并借出图书(context)。
    🌟接着上文公司知识库的例子,从input获取query(如"2023年资产负债表, 2023年利润表, 2023年现金流量表"),对应的query编码("2023年资产负债表, 2023年利润表, 2023年现金流量表"的向量化表达)在docs编码(公司知识库所有文本的向量化表达)中检索匹配,提取匹配的部分作为context(涉及公司2023年财务数据的文本)。
    🌟其中query和input的关系,我想到两种可能性,一种是直接把input作为query,另一种是模型基于input生成的query,架构图简化表达了。
    3️⃣retriever和context之间可加一步reranker架构,对检索结果按特定规则进行重新排序。reranking的机制既可通过模型判断,也可在模型基础上预设特定规则。
    🌟比如根据员工职级限制其可获取的企业知识库信息范围。

  5. 如果中国多一些猴米这样的营销公司

    如果中国多一些猴米这样的营销公司

    那两年后 美国的智能机器人蹦蹦跳跳走到中国机器人前面 用普通话骂人 转头弯腰放个屁

    还拍拍屁股的时候

    中国的机器人估计还站在原地

    说

    你好 我是你的智能助理 你可以叫我小美

    然后颤巍巍的举起手 要握手

    我不明白 请再说一次

    我的电机全自研 走路速度世界第一

    采用高通最新....

  6. 吴恩达谈 Agent 4个模式:Agent 工作流可实现 GPT-3.5 >GPT-4

    吴恩达谈 Agent 4个模式:Agent 工作流可实现 GPT-3.5 >GPT-4

    吴恩达对AI Agent的这个分享,真的很有价值,这可能才是AI Agent未来的打开方式,我自己体验了一下效果确实很好。

    大多数人使用语言模型的方式是非 Agent 式的工作流,即输入提示,生成答案;而Agent 式工作流是这样的:让 AI 编写文章大纲,看是否需要做一些研究,然后写初稿,阅读初稿并思考哪些部分需要修改,然后修改草稿,如此反复。

    多Agent协同很有SaaS 里协同带来的价值那种感觉,我觉得协同在 AI 时代或许仍然非常重要,只不过是将人与人之间的协同更多换成了 AI Agent 而已,而我猜测 AI+Human 协同可能会是未来长期的一个状态。

  7. 继续,福利还持续发,想要做副业搞钱的朋友关注一下

    Forwarded from 副业赚钱探索指南
    继续,福利还持续发,想要做副业搞钱的朋友关注一下

    没想到上面帖子( 关于生财有术,https://t.me/text1024/8726 )这么热,看来大家对搞钱搞副业很感兴趣,联合大佬给大家送福利
    记得一定回复暗号

    【新人想了解生财朋友】进群回复444👈
    可以领取生财有术体验卡3天,七年历史所有积累的东西都可以过目。

    【想要加入的朋友】进群回复555👈
    1、可以领取【生财有术体验卡3天】+【生财有术门票优惠券1张】
    2、加入后3天后可领取超额12套额外权益礼包,进群了解。

  8. Haiper - AI Video Generator

    Haiper - AI Video Generator

    介绍一款免费的 AI 视频工具,对比目前市面上诸如 pika、runway、SVD等视频工具,今天这款 AI视频工具应该是性价比最高的。

    首先,他免费;不需要积分不需要订阅就可以使用,生成完毕没有限制就可以下载。

    其次,效果稳定;可以说是最接近 Sora 的存在。

    最后,操作简单;不仅可以文生视频,还可以图生视频,可以延长视频时间,还可以更改视频。

  9. 作者展示了几张用自己训练好的 LoRA 模型生成的图像作为成果展示

    AI探索指南
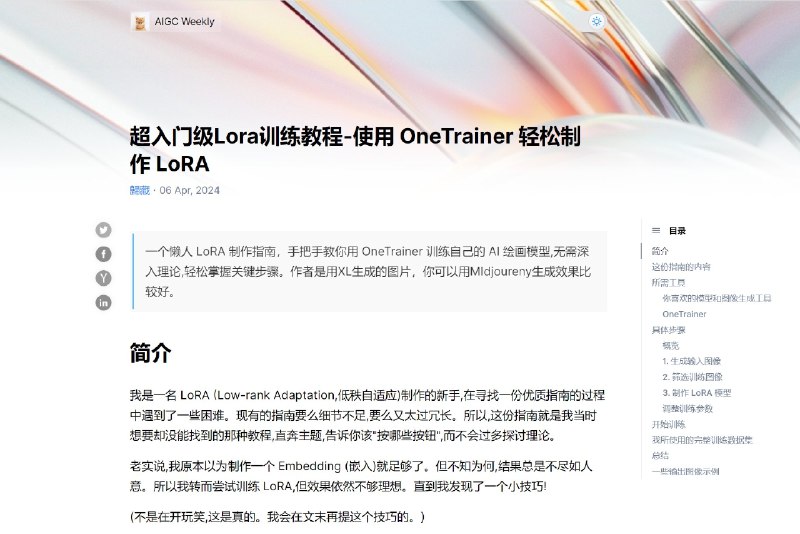
    一个懒人 LoRA 制作指南,手把手教你用 OneTrainer 训练自己的 AI 绘画模型,无需深入理论,轻松掌握关键步骤。 作者是用XL生成的图片,你可以用MIdjoureny生成效果比较好。 我完整翻译了内容,并且重新整理了适合推特阅读的版本,或者你可以在下面看完整翻译的内容: ----------------------------- 1️⃣ LoRA 模型制作教程 作者作为一名 LoRA 模型制作的新手,通过自己的学习实践,总结了一份简明扼要的制作教程。 这份教程不涉及太多理论知识,而是直奔主题…
    作者展示了几张用自己训练好的 LoRA 模型生成的图像作为成果展示。这些图像的质量相当不错,证明作者的训练过程是成功的。作者表示,训练好的模型可以根据输入的提示词和参数,生成特定风格和效果的图像。

    完整教程:https://quail.ink/op7418/p/lazy-lora-making-with-onetrainer-and-ai-generation

  10. 一个懒人 LoRA 制作指南,手把手教你用 OneTrainer 训练自己的 AI 绘画模型,无需深入理论,轻松掌握关键步骤

    一个懒人 LoRA 制作指南,手把手教你用 OneTrainer 训练自己的 AI 绘画模型,无需深入理论,轻松掌握关键步骤。

    作者是用XL生成的图片,你可以用MIdjoureny生成效果比较好。

    我完整翻译了内容,并且重新整理了适合推特阅读的版本,或者你可以在下面看完整翻译的内容:

    -----------------------------

    1️⃣ LoRA 模型制作教程

    作者作为一名 LoRA 模型制作的新手,通过自己的学习实践,总结了一份简明扼要的制作教程。

    这份教程不涉及太多理论知识,而是直奔主题,手把手教初学者如何训练自己的 LoRA 模型。

    作者坦诚分享了自己从最初尝试 Embedding 和 LoRA 时遇到的问题,以及后来找到的解决方法,为读者提供了宝贵的经验参考。

    所需工具介绍 要制作 LoRA 模型,需要准备一些必要的工具。作者推荐使用自己喜欢的模型和图像生成工具,他个人使用的是 StableSwarmUI 和 GhostXL 模型。

    此外,还需要一个训练工具,作者选择了 OneTrainer,因为有人说它比另一个常用的工具 Kohya 更易用。作者还提到,训练时如果需要将 SDXL 格式的图像转换为 SD 格式,需要在设置中开启分辨率覆盖选项。

    2️⃣ LoRA 模型制作步骤

    作者将 LoRA 模型的制作过程分为三个主要步骤:

    第一步是用现有的模型生成大量高质量的图像作为训练数据;

    第二步是人工检查挑选图像,剔除所有质量不合格的;

    第三步是使用 OneTrainer 进行训练,调整必要的参数设置。

    作者还特别提到,在训练时如果需要将 SDXL 格式的图像转换为 SD 格式,一定要记得开启分辨率覆盖选项,否则训练会出问题。

    训练参数调整心得 作为一名新手,作者在调整训练参数时主要参考了一份网上的指南。

    他尝试调整了 Lora 设置中的 rank 参数,将其从默认的 16 改为 32,解决了模型训练中遇到的问题。作者分享了这份参数调整指南的链接,供其他学习者参考。

    3️⃣ 作者的训练数据集分享

    为了帮助更多学习者,作者慷慨地分享了自己完整的训练图像数据集,其中还包含了他使用的 OneTrainer 配置文件。这些数据可供其他 LoRA 制作人下载参考和使用。数据集已经过作者的筛选,图像质量有保证。

    4️⃣ 训练成果展示

  11. AI探索指南
    万字解析AI视频《Devices》工作流全网浏览2k+啦! 工作流在OpenArt上有600views+140+下载啦! 感谢AJ收录通往AGI之路! 全文:https://mp.weixin.qq.com/s/tkcvmtybmj2xHkIaeIQypw 工作流下载:https://openart.ai/workflows/pXkm6GZX8G19I22Odeo4 Blender建模动画 + ComfyUI转绘 + 剪映剪辑 是一条很强大的工作流 如果你是想原创实验艺术、还是测试动画转绘,都可以去按照我分享的思路去试试。…
    lkU-n97qKb3eQ_Ccey7M5H9F5HXmv3.jpg
    7 MB