AI探索指南

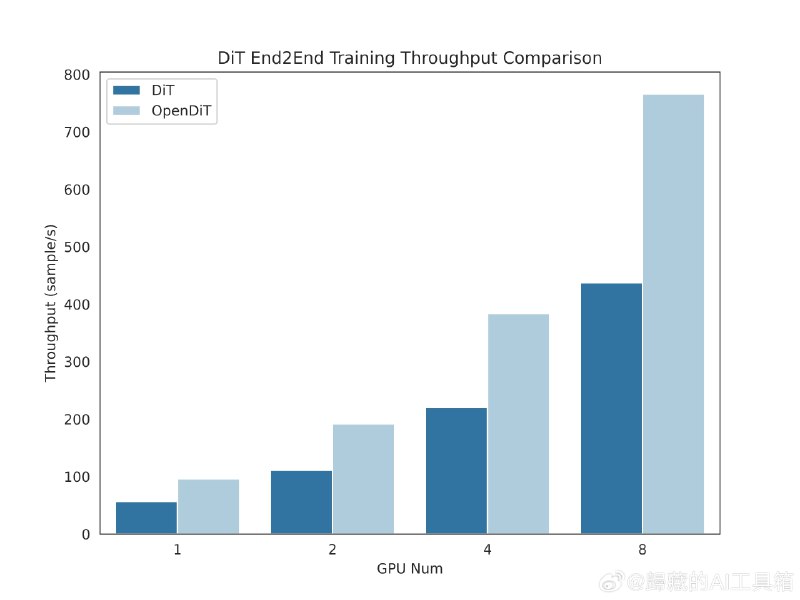
  1. OpenDiT 一个专门用来加速类似Sora的DiT架构模型推理和训练的项目,GPU 加速高达 80%,内存减少 50%

    OpenDiT 一个专门用来加速类似Sora的DiT架构模型推理和训练的项目,GPU 加速高达 80%,内存减少 50%。#ai##sora#

    主要特点有:

    GPU 加速高达 80%,内存减少 50%,内核优化包括FlashAttention、Fused AdaLN、Fused Layernorm内核。

    FastSeq:一种新颖的序列并行方法,专为激活大小较大但参数大小较小的类似 DiT 的工作负载而设计。

    使用方便,通过一些生产线更改即可获得巨大的性能提升,用户不需要了解分布式训练的实现。

    支持文本到图像和文本到视频生成的完整流程。

    项目地址:网页链接

  2. 点击Save 之后就可以使用了,支持右键保存到 Flomo 以及点击插件图标内的Send Current Flomo 保存

    AI探索指南
    换回 Flomo 记录信息的同时发现Twitter 的信息不太好同步,就自己用 GPT-4 写了一个 Twitter to flomo 的浏览器插件。 发现现在上下文长度长了以后,写这种小项目的门槛更低了。总共用了不超过 4 个小时就搞完了。 👇下面有用 GPT-4 写这个项目的提示技巧、插件使用方法以及插件下载: ## 总结的一些技巧: 补充开发文档: 告诉 GPT 谷歌已经讲浏览器扩展的Manifest V2改为了Manifest V3,并且将对应的更改内容文档上传到 GPT,告诉他根据这个编写代码。…
    点击Save 之后就可以使用了,支持右键保存到 Flomo 以及点击插件图标内的Send Current Flomo 保存。

    插件下载:https://github.com/op7418/Twitter-to-Flomo

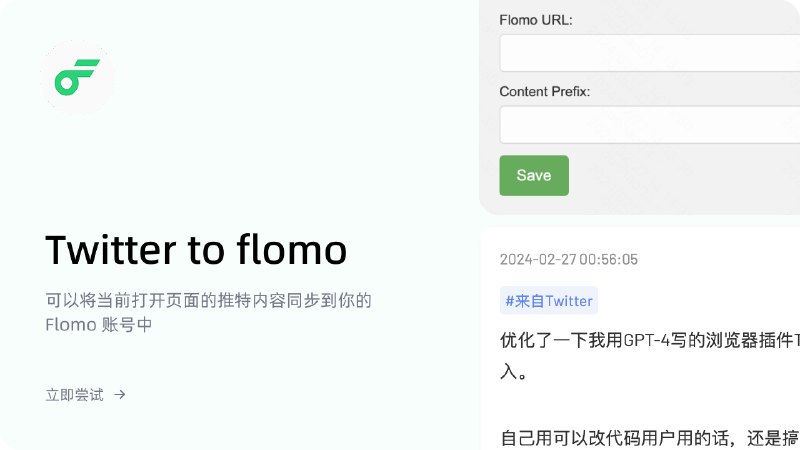
  3. 换回 Flomo 记录信息的同时发现Twitter 的信息不太好同步,就自己用 GPT-4 写了一个 Twitter to flomo 的浏览器插件

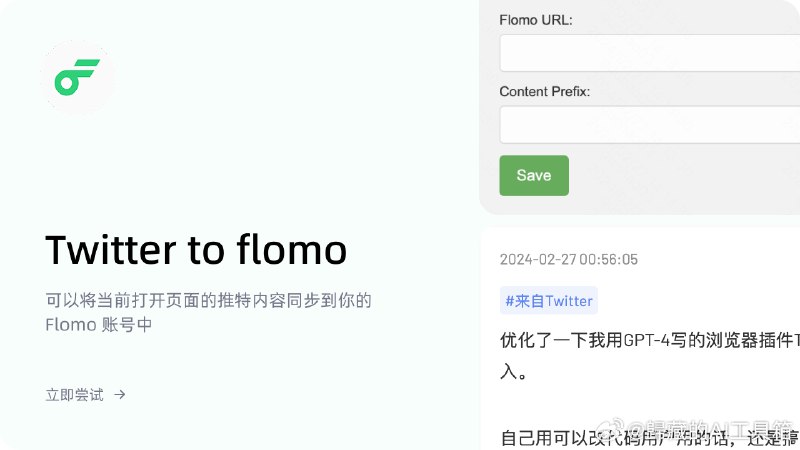
    换回 Flomo 记录信息的同时发现Twitter 的信息不太好同步,就自己用 GPT-4 写了一个 Twitter to flomo 的浏览器插件。

    发现现在上下文长度长了以后,写这种小项目的门槛更低了。总共用了不超过 4 个小时就搞完了。

    👇下面有用 GPT-4 写这个项目的提示技巧、插件使用方法以及插件下载:

    ## 总结的一些技巧:

    补充开发文档:

    告诉 GPT 谷歌已经讲浏览器扩展的Manifest V2改为了Manifest V3,并且将对应的更改内容文档上传到 GPT,告诉他根据这个编写代码。

    先实现核心能力:

    建议刚开始只实现最核心的功能,对于我这个项目来说就是获取推特内容,然后传输到 flomo 。

    提供必要信息:

    比如 GPT 显然是不知道 Flomo 的 API 格式的,你需要把对应的文档发给他,我都是直接全选文档页面内容,然后保存成 MD 格式。

    善用控制台 log 和报错信息:

    刚开始如果报错可以复制报错信息让 GPT 分析并改进,如果改了几次没改好,就想办法用 log 获取更多信息,比如我这个核心功能主要有两部分,先是获取信息,然后是传输,我们需要确定是哪一步错了,就可以让他在对应阶段完成的时候在控制台打印输出的 log 信息。

    及时上传代码:

    发现 GPT-4 输出的代码无法与原有代码对应的时候,应该及时重新上传现在完整的代码,防止他忘的越来越多。

    最重要的立刻去做:

    其实没有那么难,不要想那么多我不会写提示词也没有开发经验怎么办,GPT 都会告诉你,开始问出第一个问题是最难的一步。

    这是这个项目与 GPT 的完整对话记录:https://chat.openai.com/share/ef6d226e-1b38-40cf-b4fb-e6d92eb7c67e

    ## 如何使用

    点击Github 页面右上角的 Code 按钮选择 Downlaod zip 按钮将插件文件下载到本地。

    打开浏览器扩展页面,打开开发者模式,选择加载解压的扩展程序选择解压后的文件夹。

    加载之后点开插件图标,点击 Setting 按钮,进入设置页面。

    你可以在 Flomo 的扩展中心&API 页面找到你的专属 API,填写到Flomo URL输入框就行。

    Content Prefix是你希望同步到 flomo 时内容的标签,主要填写时前面需要加#。

  4. 昨晚 Open AI 在 TT 上发布的 Sora 新视频,创建一些不存在的生物,第三个福瑞控和宝可梦爱好者肯定喜欢,太可爱了

    昨晚 Open AI 在 TT 上发布的 Sora 新视频,创建一些不存在的生物,第三个福瑞控和宝可梦爱好者肯定喜欢,太可爱了。#ai视频##sora#

    提示词:创造一种从未存在过的逼真动物,自然纪实风格 歸藏的AI工具箱的微博视频

  5. 微软这个研究相当强啊,可以不经过训练直接融合多个 Lora 不损失效果,而且他们提出的通过 GPT-4V 评价图像质量的方法也很有参考性

    微软这个研究相当强啊,可以不经过训练直接融合多个 Lora 不损失效果,而且他们提出的通过 GPT-4V 评价图像质量的方法也很有参考性。#ai画图#

    项目介绍:

    本项目旨在通过新的文本至图像生成方法,着重采用多重低秩适应(Low-Rank Adaptations, LoRAs)技术,创造高度个性化且细节丰富的图像。我们介绍了LoRA开关(LoRA Switch)与LoRA组合(LoRA Composite),这两种方式的目标是在精确度和图像质量上超越传统技术,特别是在处理复杂图像组合时。

    项目特色:

    🚀 免训练方法
    LoRA开关和LoRA组合支持动态精确地整合多个LoRA,无需进行微调。
    我们的方法不同于那些融合LoRA权重的做法,而是专注于解码过程,并保持所有LoRA权重不变。

    📊 ComposLoRA测试平台
    这是一个全新的综合性测试平台,包含480套组合和22个在六大类别中预训练好的LoRA。
    ComposLoRA专为评估基于LoRA的可组合图像生成任务而设计,支持定量评估。

    📝 基于GPT-4V的评估工具
    我们提出采用GPT-4V作为评估工具,用以判定组合效果及图像质量。
    该评估工具已证实在与人类评价的相关性上有更好的表现。

    🏆 卓越性能
    无论是自动化还是人类评价,我们的方法都显著优于现有的LoRA合并技术。
    在生成复杂图像组合的场景中,我们的方法表现出更加突出的优势。

    🕵️♂️ 详尽分析
    我们对每种方法在不同场景下的优势进行了深入的分析。
    同时,我们还探讨了采用GPT-4V作为评估工具可能存在的偏差。

    项目地址:网页链接歸藏的AI工具箱的微博视频

  6. 一个让 Notion AI 帮助更好思考,更好做笔记的方法

    一个让 Notion AI 帮助更好思考,更好做笔记的方法

    Zettelkasten (卡片笔记法) 中提倡在记录笔记时,尽可能地创造更多笔记之间的双向连接,将知识点链接起来,并引发思考。这个过程很类似于大脑的思考过程,在知识之间创造起关联,可以帮助我们更好地记录笔记。

    在没有 AI 之前,这些联系只能依靠人脑的记忆和思考。

    但在有了 AI 以后,AI 更擅长帮助去寻找这样的链接。(基于语义的向量库搜索,是这一过程的最佳解决技术支撑)

    我的笔记都记录在 Notion 中,所以我使用 Notion AI 来帮助我寻找更多地关联。

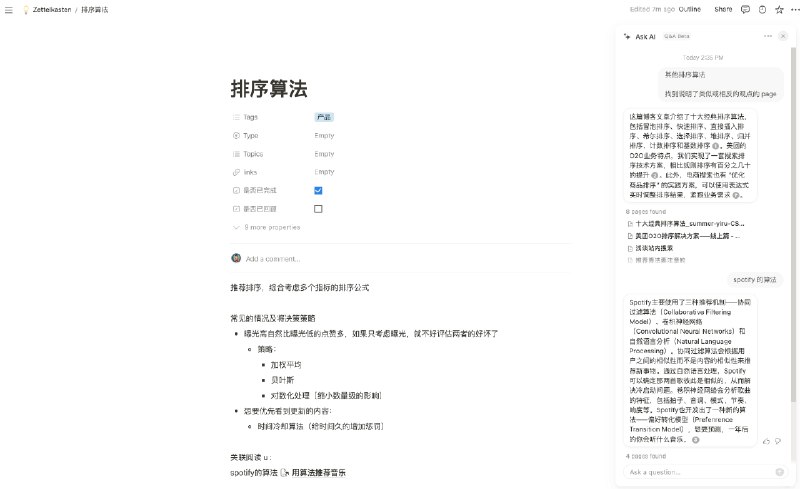
    就像图片里这样,当我在记录有关“排序算法”的笔记时,点开右下角的 AI 按钮,prompt 输入:
    ```
    观点:{{观点内容}}

    找到说明了类似或相反的观点的 page
    ```

    Notion AI 就会使用向量化搜索,自动匹配关联的页面,并将其总结发给我。

    依据 Notion AI 提供的页面链接和总结,我就可以在笔记之间创造出更多的关联。

    同时,这个记录笔记的过程,也是将新的笔记和旧的笔记联系在一起,加深了记忆,也加深了理解。

  7. 字节发布的这个MegaScale估计只有超级大厂才有用,一个在超过一万个 GPU 上训练 LLM 的生产系统

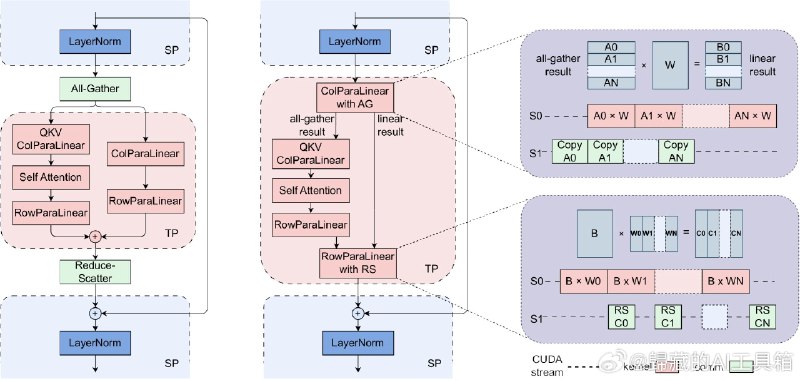
    字节发布的这个MegaScale估计只有超级大厂才有用,一个在超过一万个 GPU 上训练 LLM 的生产系统。#ai##llm#

    整个系统涵盖了从模型块和优化器设计到计算与通信的重叠、运算符优化、数据管道以及网络性能调整的算法和系统组件。

    MegaScale 在训练一个 175B 参数的 LLM 模型时,在 12,288 GPU 上实现了 55.2% 的模型浮点运算利用率(Model FLOPs Utilization,MFU),相比 Megatron-LM 提升了 1.34 倍。

    论文地址:网页链接

  8. 插件下载:网页链接

    AI探索指南
    换回 Flomo 记录信息的同时发现Twitter 的信息不太好同步,就自己用 GPT-4 写了一个 Twitter to flomo 的浏览器插件。#ai# 发现现在上下文长度长了以后,写这种小项目的门槛更低了。总共用了不超过 4 个小时就搞完了。 👇下面有用 GPT-4 写这个项目的提示技巧、插件使用方法以及插件下载: ## 总结的一些技巧: 补充开发文档: 告诉 GPT 谷歌已经讲浏览器扩展的Manifest V2改为了Manifest V3,并且将对应的更改内容文档上传到 GPT,告诉他根据这个编写代码。…
    插件下载:网页链接

  9. 换回 Flomo 记录信息的同时发现Twitter 的信息不太好同步,就自己用 GPT-4 写了一个 Twitter to flomo 的浏览器插件

    换回 Flomo 记录信息的同时发现Twitter 的信息不太好同步,就自己用 GPT-4 写了一个 Twitter to flomo 的浏览器插件。#ai#

    发现现在上下文长度长了以后,写这种小项目的门槛更低了。总共用了不超过 4 个小时就搞完了。

    👇下面有用 GPT-4 写这个项目的提示技巧、插件使用方法以及插件下载:

    ## 总结的一些技巧:

    补充开发文档:

    告诉 GPT 谷歌已经讲浏览器扩展的Manifest V2改为了Manifest V3,并且将对应的更改内容文档上传到 GPT,告诉他根据这个编写代码。

    先实现核心能力:

    建议刚开始只实现最核心的功能,对于我这个项目来说就是获取推特内容,然后传输到 flomo 。

    提供必要信息:

    比如 GPT 显然是不知道 Flomo 的 API 格式的,你需要把对应的文档发给他,我都是直接全选文档页面内容,然后保存成 MD 格式。

    善用控制台 log 和报错信息:

    刚开始如果报错可以复制报错信息让 GPT 分析并改进,如果改了几次没改好,就想办法用 log 获取更多信息,比如我这个核心功能主要有两部分,先是获取信息,然后是传输,我们需要确定是哪一步错了,就可以让他在对应阶段完成的时候在控制台打印输出的 log 信息。

    及时上传代码:

    发现 GPT-4 输出的代码无法与原有代码对应的时候,应该及时重新上传现在完整的代码,防止他忘的越来越多。

    最重要的立刻去做:

    其实没有那么难,不要想那么多我不会写提示词也没有开发经验怎么办,GPT 都会告诉你,开始问出第一个问题是最难的一步。

    这是这个项目与 GPT 的完整对话记录:网页链接

    ## 如何使用

    点击Github 页面右上角的 Code 按钮选择 Downlaod zip 按钮将插件文件下载到本地。

    打开浏览器扩展页面,打开开发者模式,选择加载解压的扩展程序选择解压后的文件夹。

    加载之后点开插件图标,点击 Setting 按钮,进入设置页面。

    你可以在 Flomo 的扩展中心&API 页面找到你的专属 API,填写到Flomo URL输入框就行。

    Content Prefix是你希望同步到 flomo 时内容的标签,主要填写时前面需要加#。

    点击Save 之后就可以使用了,支持右键保存到 Flomo 以及点击插件图标内的Send Current Flomo 保存。

  10. 推荐3个进化了的搜索引擎

    推荐3个进化了的搜索引擎

    1、https://metaso.cn/ 秘塔
    2、Arc Search (苹果APP)
    3、https://explorer.globe.engineer/

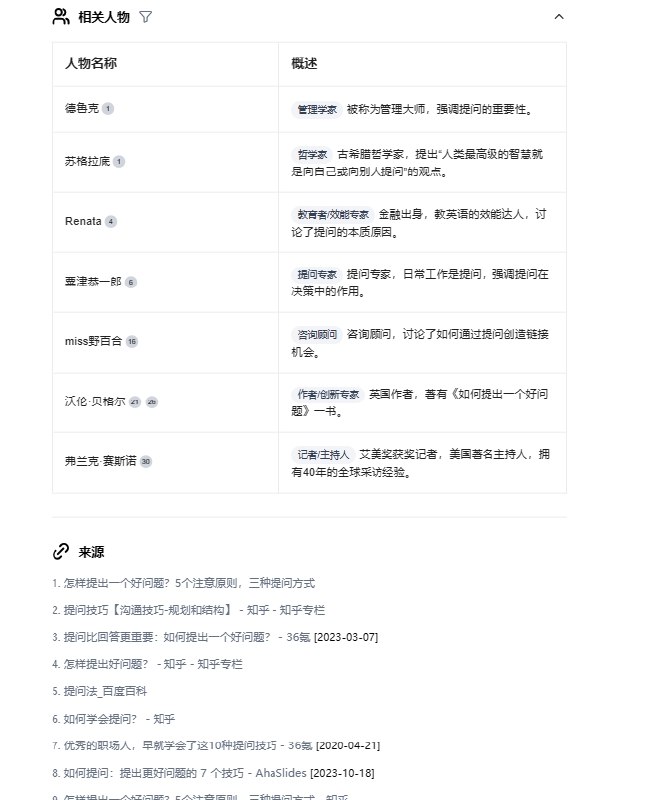
    1、秘塔在中文语境堪称皇者,思维导图+相关领域,信息源的准确性和拓展性都非常优质(图1、2)。
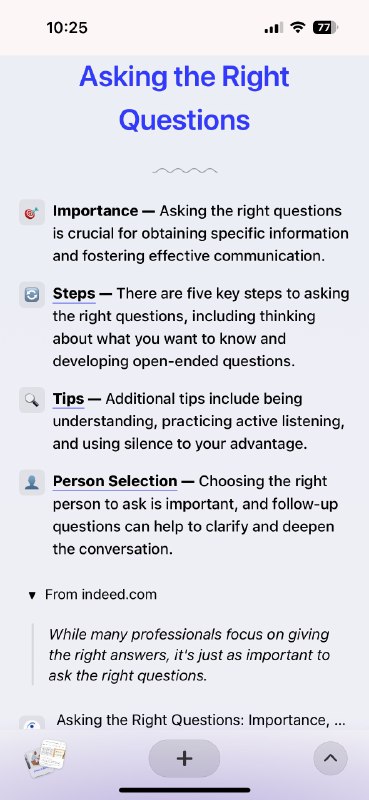
    2、Arc Search 的优点是可以英文领域搜索,界面不如秘塔,但胜在可搜英文世界,资源丰富准确。(图3、4)
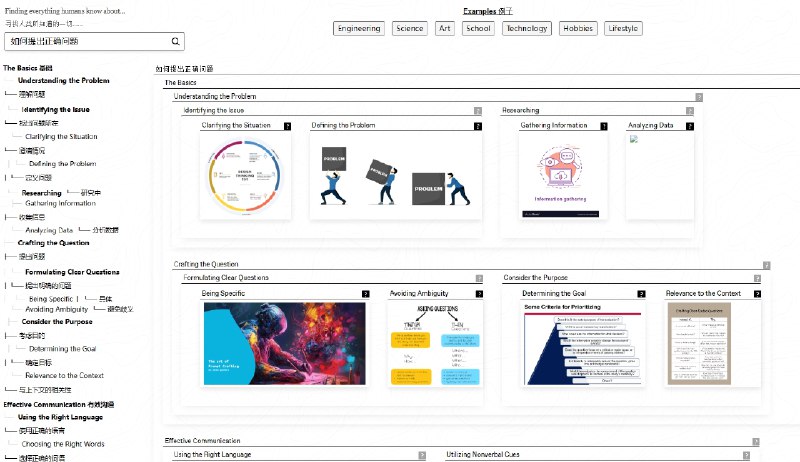
    3、新出的引擎,拓展性和可读性都不错。但信息源准确性不稳定,适合搜“成熟的关键字”,例如学科知识。会比较独特、全面信息源。(图5)

  11. 据安替老师和其他朋友的反馈发现,现在Mistral的聊天应用le Chat已经无法直接登录

    据安替老师和其他朋友的反馈发现,现在Mistral的聊天应用le Chat已经无法直接登录。需要填写Wait list。#ai#

    估计是昨晚负载太大了,临时采取的措施,没有尝试的也可以试试是不是也需要。

    看来负载确实很大,Mistral还是太年轻了,没有体验过被薅羊毛的痛苦,现在稍微长一些的提示词 Large 模型已经无法响应了,一直卡着。

    地址:网页链接