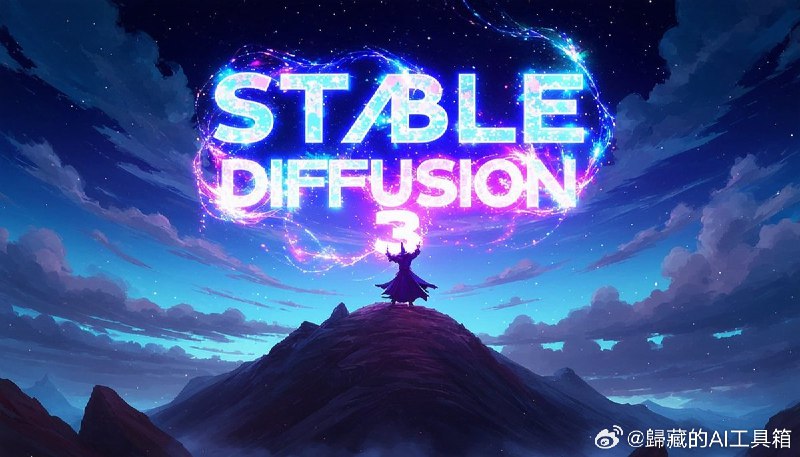
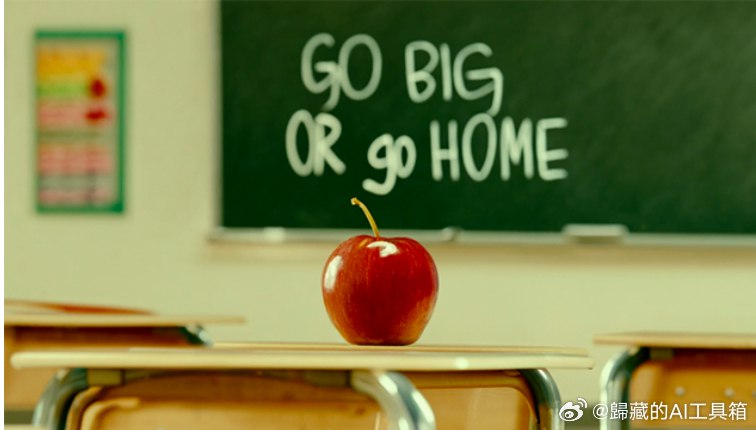
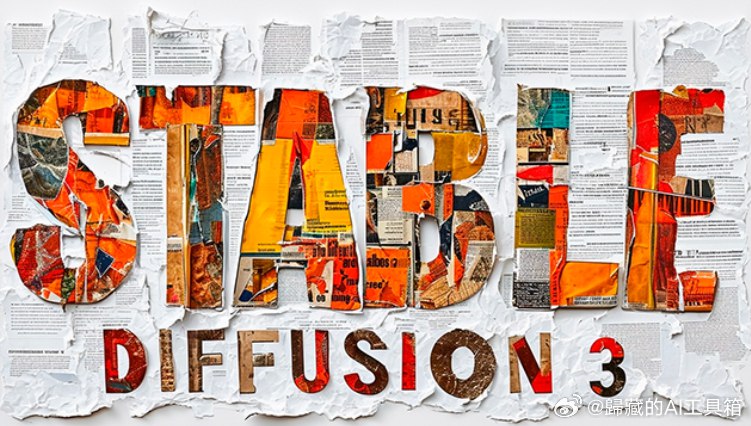
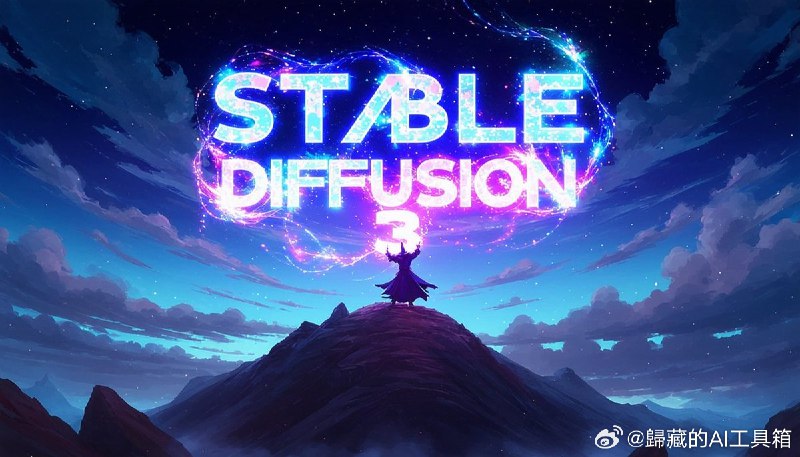
AI探索指南卧槽 Stability AI 还有货,发布了Stable Diffusion 3模型,多主题提示、图像质量和拼写能力方面的性能得到了极大的提高00:45 · 2024年2月23日 · 周五 × × × × 卧槽 Stability AI 还有货,发布了Stable Diffusion 3模型,多主题提示、图像质量和拼写能力方面的性能得到了极大的提高。#ai画图#Stable Diffusion 3 套模型目前参数范围从 800M 到 8B。Stable Diffusion 3采用了和Sora一样的diffusion transformer 架构。公告全文:网页链接00:45 · 2024年2月23日 · 周五
AI探索指南Emad关于Stable Diffusion 3的补充信息: #ai画图#00:45 · 2024年2月23日 · 周五 × Emad关于Stable Diffusion 3的补充信息: #ai画图#这项技术采用了一种新型的扩散变换器(Diffusion Transformer,类似于Sora),并结合了光流匹配(flow matching)及其他技术上的改进。利用变换器(Transformer)的最新改进,这项技术不仅能够实现更广泛的应用范围,还能处理多种类型的输入数据(多模态输入)。关于这项技术的更多技术细节,我们将很快对外公布。来源:网页链接00:45 · 2024年2月23日 · 周五
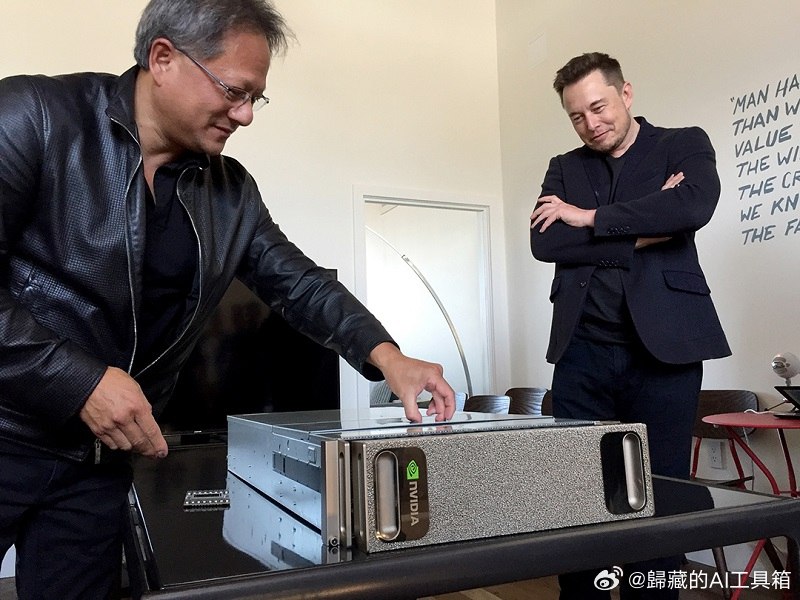
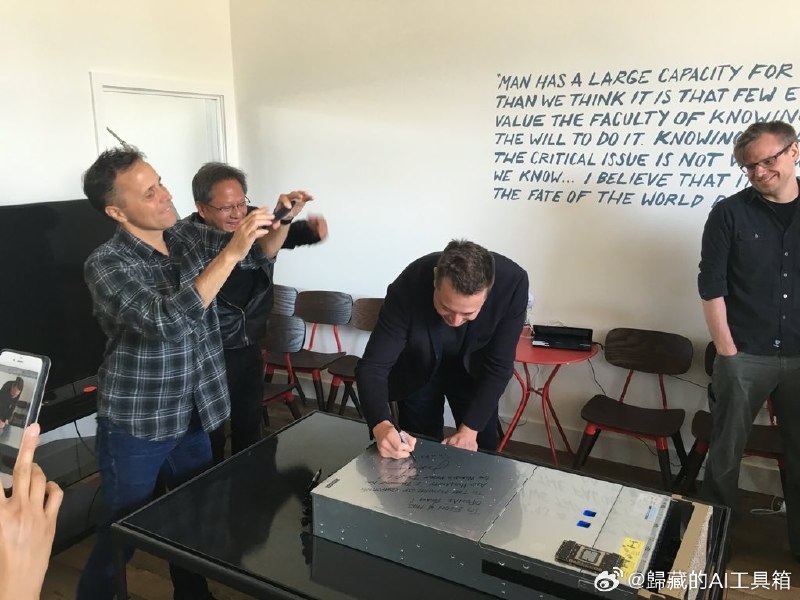
AI探索指南老黄18年把DGX-1 AI 超级计算机捐给Open AI的照片,他也没能想到当时的一个超算,会让英伟达达到这个高度吧00:45 · 2024年2月23日 · 周五 × × × 老黄18年把DGX-1 AI 超级计算机捐给Open AI的照片,他也没能想到当时的一个超算,会让英伟达达到这个高度吧。来源:马斯克推特00:45 · 2024年2月23日 · 周五
AI探索指南下一个全民级的内容平台需要满足两个特点(其实有更多,先不提了):22:55 · 2024年2月22日 · 周四下一个全民级的内容平台需要满足两个特点(其实有更多,先不提了):- 不能是纯被动、低参与、低沉浸的。这类型的内容实质上在被动消费固定信息,在脑机接口这样的传输渠道成熟之前,视频形式在单位时间内传递信息的密度已经到了极限,对人眼和耳朵两个信息采集器官的利用效率到了极致没有新的内容范式就不存在平台的机会,最终都是给抖音Tiktok扩大供给- 不能像游戏一样强制性的高参与高投入。消费成本太高会使得用户对内容消费体验的预期持续抬高,整个游戏工业界都在卷头部精品,这条路的长期趋势是往头号玩家那样终极单品内容的方向走,极致的OGC目前基于LLM的产品探索,进度最靠前的大概还是C.AI,但这种需要用户自我创作自我驱动的体验形式跟大量游戏殊途同归如果内容不成立,就是AI native的小众垂类游戏,内容若成立,最终会逐渐融入现存的各种游戏类型,技术被用于更好的诠释成熟的内容形态这就是为什么我认为在探索AI to C的过程中,持续在“对话”类产品上投入资源是个错误。22:55 · 2024年2月22日 · 周四
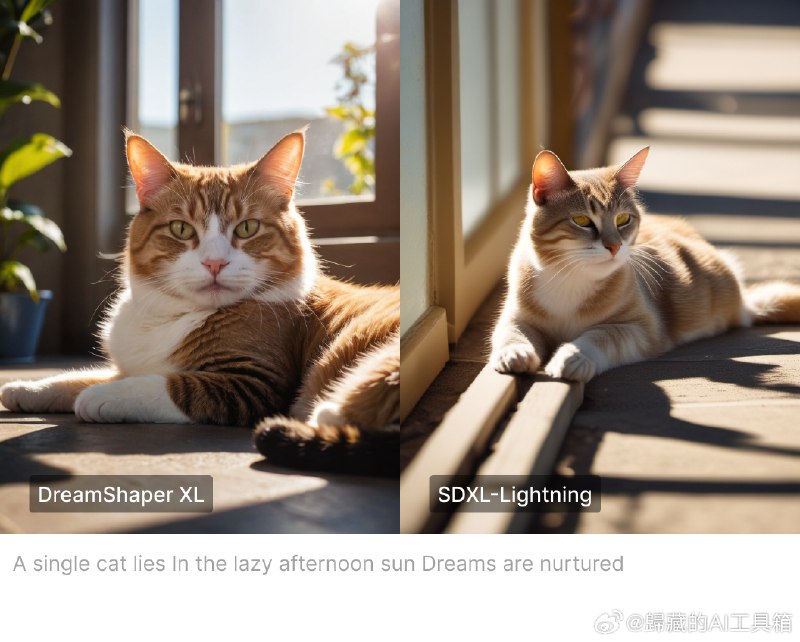
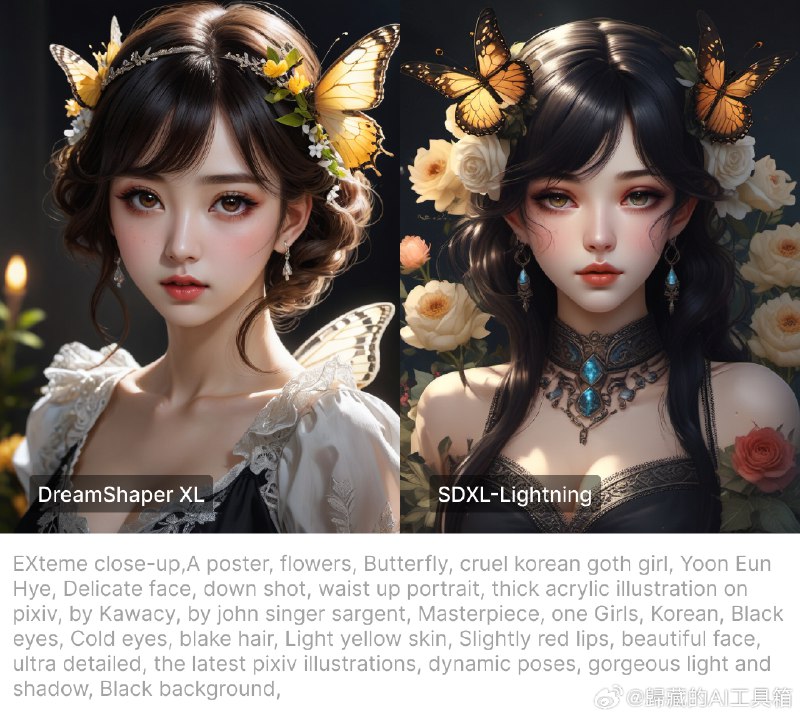
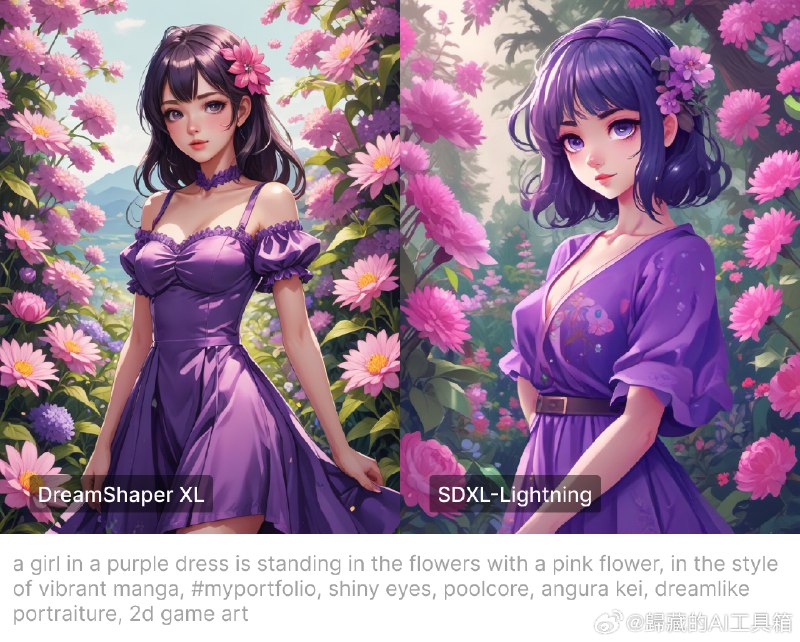
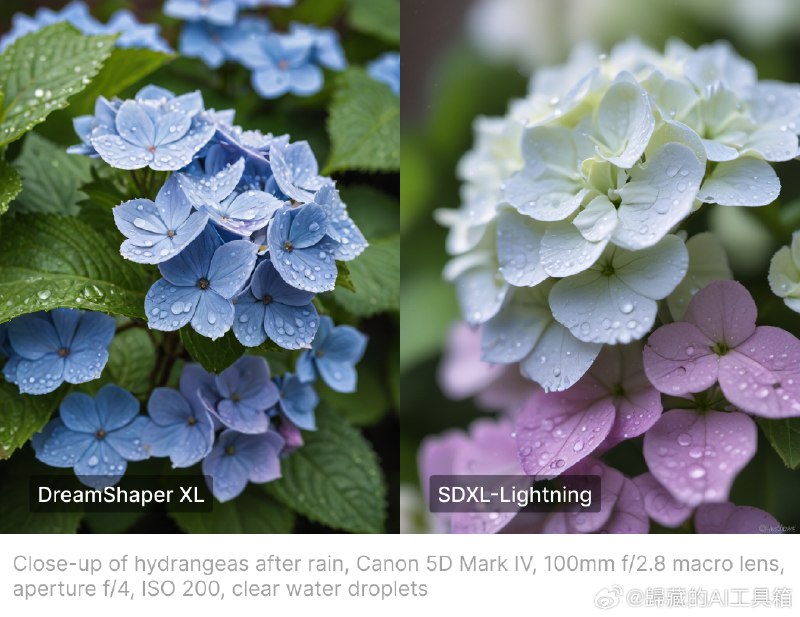
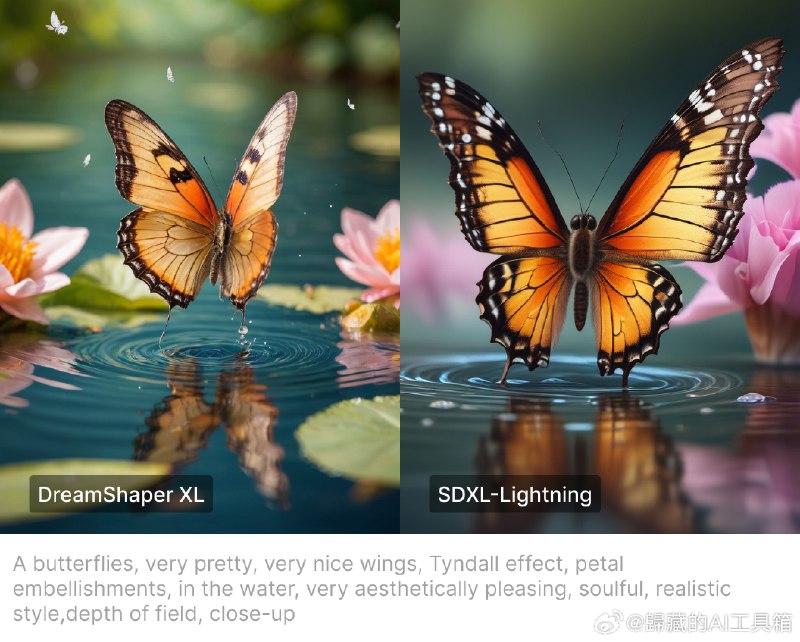
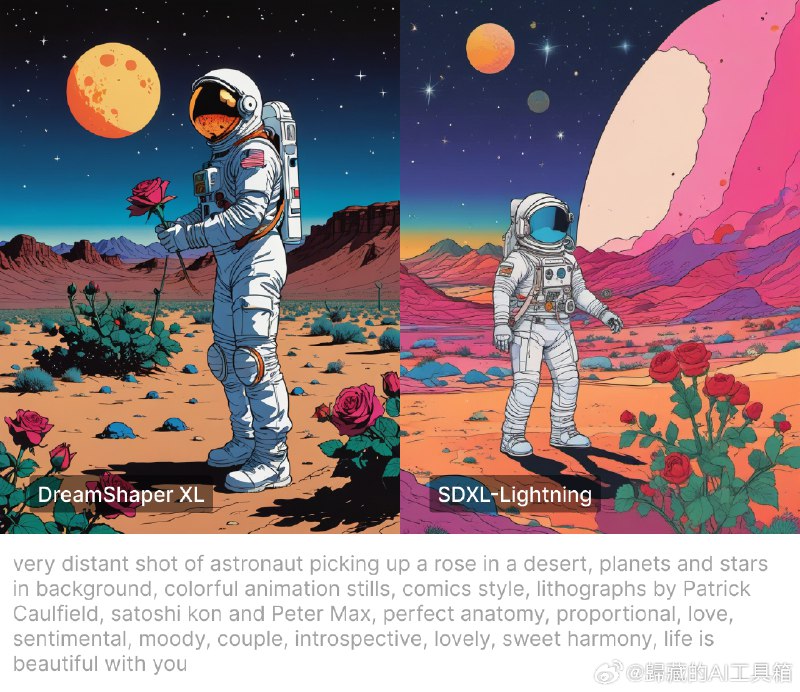
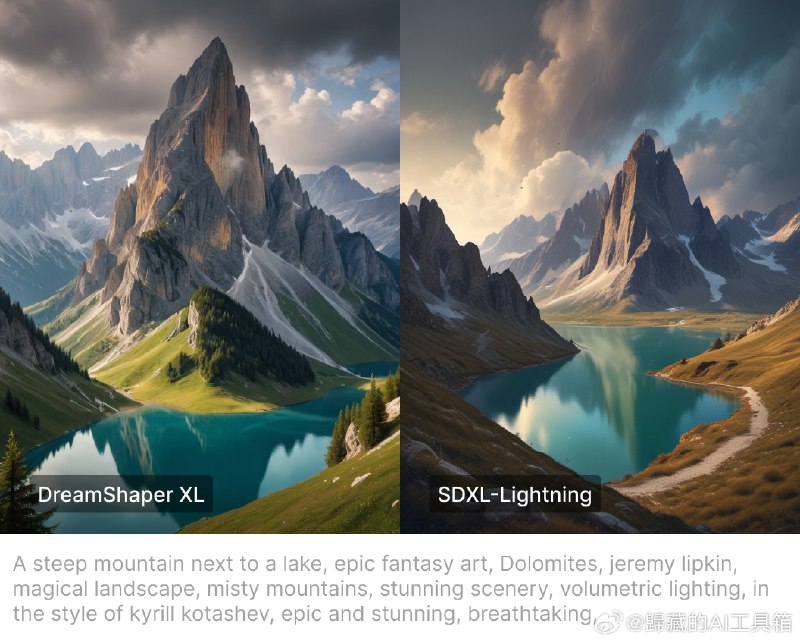
AI探索指南妈的 给字节道歉,下午SDXL-Lightning的 Unet 模型我用的时候参数搞错了21:25 · 2024年2月22日 · 周四 × × × × × × × × 妈的 给字节道歉,下午SDXL-Lightning的 Unet 模型我用的时候参数搞错了。#ai画图#重新下了 CKPT 试了一下跟DreamShaper XL比差的不多,细节没有DreamShaper XL丰富,涂抹感比较重。下面是具体的对比图片。21:25 · 2024年2月22日 · 周四
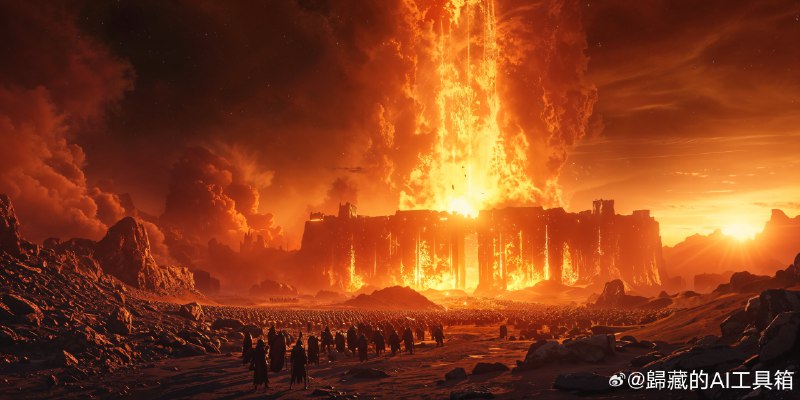
AI探索指南“所罗门王的光柱将所有人都烧成了耸立的岩柱,飘荡在硫磺与焰火的地狱里,只有一个活人在痛苦的挣扎21:25 · 2024年2月22日 · 周四 × “所罗门王的光柱将所有人都烧成了耸立的岩柱,飘荡在硫磺与焰火的地狱里,只有一个活人在痛苦的挣扎。”-无尽债务#ai画图#21:25 · 2024年2月22日 · 周四
AI探索指南Stability AI 官方的 SVD 视频生成平台公测了,功能上就是 SVD 模型增加了镜头控制能力,视频是我用一些图片生成的19:07 · 2024年2月22日 · 周四Stability AI 官方的 SVD 视频生成平台公测了,功能上就是 SVD 模型增加了镜头控制能力,视频是我用一些图片生成的。#ai视频#每天会有 150 的免费额度可以生成 15 个视频,可以去体验一下。平台帮助模型获取标记数据的设计比较有意思。类似的视频生成平台可以参考。首先是在视频生成等待的过程中会出现一个弹窗,会展示两个社区的视频让用户评选哪个好。另外是生成视频之后也会又一个评价的气泡,你可以点赞或者点踩。这里体验:网页链接歸藏的AI工具箱的微博视频19:07 · 2024年2月22日 · 周四
AI探索指南剪映海外版CapCut推出了文字生成视频功能,每人每天可以免费生成五次19:07 · 2024年2月22日 · 周四剪映海外版CapCut推出了文字生成视频功能,每人每天可以免费生成五次。#ai视频#支持中文提示词,目前生成的内容质量比较差,应该不是字节之前发布的自己的视频模型。这里尝试:网页链接歸藏的AI工具箱的微博视频19:07 · 2024年2月22日 · 周四
AI探索指南昨天除了字节的 SDXL-Lightning之外,开源社区的DreamShaper XL也发布了Lightning模型17:00 · 2024年2月22日 · 周四 × × × × 昨天除了字节的 SDXL-Lightning之外,开源社区的DreamShaper XL也发布了Lightning模型。#ai##ai画图#这个模型生成的图片质量非常高,提示词响应也不错,比字节的强很多。也是只需要 4 步就能生成图片,推荐的采样器是DMP++ SED Karras,CFG 值为 2。模型下载:网页链接17:00 · 2024年2月22日 · 周四