AI探索指南

  1. 一封内部信暴露了中美AI竞赛的真实格局

    一封内部信暴露了中美AI竞赛的真实格局
    硅谷最近流传着一份来自顶级风投机构Dimension Capital的内部信,几位合伙人在中国走访调研了一周后,回去给投资者写了一封五页纸的观察,其措辞比任何对外公开表态都要直白得多。
    信中最扎眼的一个数字是大约80%的美国AI初创公司已经在生产环境中部署了至少一个来自的中国的开源模型,而18个月前这个数字几乎是零。
    这是一个渗透率的指数级跃迁,它意味着中国AI产业在软件层面已经完成了一次历史性的跨越。过去20年来,中国的SaaS软件始终没能真正进入西方企业的核心工作流,因为企业软件的采购壁垒天然倾向于保护既有供应商。
    开源模型则绕过了这道墙,因为不存在合同谈判,不存在供应商审查,也不存在黑名单,一个工程师就能直接下载模型然后开始跑工作负载,这种效率是任何销售团队都无法企及的。
    Qwen成为Hugging Face上最快突破10亿次下载的模型家族,OpenRouter平台上中国模型的Token消耗份额在18个月内从不足2%飙升到45%以上,这些数字不是偶然。
    这一切的背后是来自美国的芯片禁令,禁令的本意是拖慢中国AI的发展节奏,但它产生了一个意料之外的副产品。因为算力买不到的时候,只能用人力去替代算力。于是每多一个懂编译器或系统底层架构的工程师,就能永久降低整个团队对算力的依赖。
    这不是一次性的资本开支,它能积累、能复用,能形成一种全栈的工程纪律。美国公司习惯用钱解决问,中国公司被迫用效率替代资源。两种模式没有优劣之分,但它们在塑造完全不同的组织能力。一家公司如果始终可以用钱解决问,就不会有动力去培养那种不用钱也能解决问的肌肉。中国算力的匮乏反而被倒逼成了一种进化压力,DeepSeek当年的横空出世就是一个最好的例子。
    但事情的另一面是中国在吃西方的计算负载,但吃不到收入。因为开源模型的下载是免费的,真正需要花钱的是推理、微调、部署、运维这一层,这笔钱最终流向了美国的推理服务商和云厂商。不过开源模型在长期博弈中的战略价值并不直接体现在API收入上,当一个模型被下载得越多、部署得越广,它就在积累更多使用场景的反馈数据,这些数据在迭代下一代模型时的复用价值是难以估量的。
    当美国80%的AI初创公司已经深度依赖中国的开源模型时,这些公司不仅在使用中国的代码,也在使用中国的技术栈、工具链和最佳实践。标准一旦确立,更换的代价会远高于所支付的Token费用。
    Cursor的Composer 2被发现是基于Kimi K2.5改的,Harvey的Tenet是对Kimi K3后训练的产物。如果是一两年前,这些公司大概率会选择Llama或Mistral。如今,美国垂直AI行业的底层基座正在逐渐变成中国开源模型,而这些模型内部又潜藏着部分来自美国前沿模型的智能。这是一个双向渗透的闭环,仅靠监管砍不断这种连接,因为技术之间的对渠道太多了,单方面切断的代价可能大于收益。
    与此同时,中美AI两边的瓶颈又恰好是镜像的。美国芯片充裕但电力越来越吃紧,中国电力充裕但芯片始终不够用。中期局势取决于哪一侧的障碍率先被推倒,但如果双方在短时间内都解决不了各自的问,竞争就会从“谁能跑得更快”变成“谁能在受限条件下跑得更远”。当算力变成硬约束,效率就成了唯一的变量。
    Dimension Capital认为中国AI公司的收入远低于美国同行但估值倍数却远高于美国是“资本市场不够成熟”的表现,这可能低估了中国资本市场的逻辑。中国投资者经历过消费互联网时代,亲眼见证过“先跑规模再变现”的路径能走通。
    当年抖音、美团、拼多多都是在规模足够大之后才找到商业闭环的,用企业软件的逻辑去套中国市场本身就错位了,但前提是中国的AI公司别也掉入这个陷阱中。另一个被低估的变量是一旦模型能力趋同,胜负手就从“谁有更好的模型”转移到了“谁有更好的数据飞轮”上。今天开源模型和AI产品的用户规模数据,可能比任何Benchmark都更能预示未来的竞争格局。
    基于这些判断,美国接下来会面临一个两难选择。如果继续开放最新模型的API,中国实验室的蒸馏效率已经快到了无法忽视的程度。如果关闭API,他们必须放弃一个巨大的收入来源,把模型生态的主导权拱手让人。而且蒸馏并不完全依赖API权限,它需要的是模型的输出,真正能切断蒸馏的只有完全不公开任何高能力模型权重,这是一个代价极高的选择。如果开源模型的能力已经逼近闭源模型,而闭源模型的商业模式又在承受压力,这个选择会变得越来越紧迫。
    所以我敢下的一个判断是双方的技术渗透已经深到剪不断理还乱了,谁先试图强行切断,谁就要承担那个代价。美国在算力上的优势依然存在,但中国在效率上补回来的那部分已经足够把这场竞赛拖入一个谁都无法单方面终结的僵局。
    开源模型这把刀已经切进去了,它真正切的是标准、是生态,是未来十年全球AI应用层的基座。基座一旦铺好,上层怎么长就不完全由地基说了算了。
    这场中美AI竞赛中真正有意思的部分,才刚刚开始。
    @aigc1024

  2. 卷烟厂和橙子厂要提升产品品质,只能自己种植烟叶和橙树

    卷烟厂和橙子厂要提升产品品质,只能自己种植烟叶和橙树
    Cursor 和 Harvey 要提升服务能力,只能自己训练模型
    把最重要的生产资料掌握在自己手里
    只因为它是最核心的变量和卖点
    商业世界的道理如此朴实无华又亘古不变
    每个企业都在试图改变自己能改变的最大的变量
    喜欢偷懒的人才会去打上应用/模型的标签
    @aigc1024

  3. 一提到智元机器人,所有人第一反应都是B站Up稚晖君

    一提到智元机器人,所有人第一反应都是B站Up稚晖君。
    但很多人不知道,稚晖君根本不是智元的老板,他只是台前的代言人,真正掌控这家百亿独角兽的幕后大佬另有其人。
    刚好这两天行业里两件大事凑到了一起,把这个人彻底推到了台前。
    第一件,第二届世界人形机器人运动会落幕,智元首次参赛就拿下18金16银12铜,总共46枚奖牌,金牌数和奖牌总数双双登顶,直接把宇树甩在了身后。
    第二件,《时代》周刊2026年全球AI百人榜公布,智元入选创新者榜单的人,不是稚晖君,而是董事长兼CEO邓泰华。
    很多人可能第一次听这个名字,看完他的履历,你就知道这人有多厉害。
    邓泰华1977年生人,电子科大毕业,一毕业就进了华为,一干就是20多年。
    最早从无线网络业务做起,管过基站产品线,做过东北欧地区副总裁,把华为运营商业务从技术到销售、从产品到海外交付的完整链条摸了个透。
    2019年升任华为高级副总裁,2020年转头掌舵计算产品线,我们熟悉的鲲鹏通用算力芯片、昇腾AI芯片的产业生态,全是他主导推进的。
    他是华为体系里少有的全能型老将——既懂通信底层技术,又懂算力生态布局;既管过前沿研发,又打过海外市场硬仗;既能做技术战略,又能整合产业资源。
    2022年底,邓泰华从华为离职,拉着当时还是他下属的稚晖君,凑了不到10个人的小团队,创办了智元机器人。
    没错,稚晖君当年在华为昇腾部门做主任工程师,邓泰华就是他顶头上司的顶头上司。
    智元的股权结构是公开可查的工商信息,穿透看完,你就看懂两个人真实的位置差距。邓泰华是公司法定代表人、实际控制人,他除了直接持股,还通过好几家管理层持股平台,合计受益股份超过 26%,表决权更是超过 56%,公司的资本、融资、并购、大方向全部由他说了算。而稚晖君也就是彭志辉,他没有直接持股,是通过合伙平台间接持股,穿透之后大概 3.87%,职务是联合创始人、CTO,主抓技术研发,并不是公司的实际控制人。网上很多人被短视频误导,以为稚晖君是老板,但是股权白纸黑字摆在那里,流量光环不等于控制权。
    那问来了,明明他才是创始人、董事长兼CEO,为什么创业头三年,要把稚晖君推到台前,自己藏得严严实实?
    第一,破圈效率天差地别。创业初期,一家机器人公司想让行业和大众记住,砸市场费用要花多少钱?稚晖君本身就是B站百大UP主,几百万精准的科技粉、工程师粉,他一条离职创业的视频,直接就让智元全国破圈,这效率比任何市场部都高十倍。用个人IP带公司品牌,是成本最低的破圈方式。
    第二,分工决定定位。邓泰华干了20多年产业,最擅长的是战略布局、供应链整合、拿融资、谈大客户、搭生态。这些事都不需要抛头露面,闷声做反而效率更高。而稚晖君懂技术、懂产品,年轻有天才人设,形象正面,站在台前做技术代言人,跟工程师、跟用户沟通,再合适不过。
    第三,进可攻退可守。创业初期变数多,创始人太高调,一旦产品或者融资出点问,很容易反噬公司品牌。把技术IP推到前面,幕后掌舵人专心做事,既能享受流量红利,又能规避舆论风险。等到公司商业化跑通了,要冲IPO了,再正式走到台前,节奏刚刚好。
    其实这种“台前技术明星,幕后产业大佬”的模式,在科技圈一点都不新鲜。比如智能硬件圈的李泽湘,投了大疆、云鲸等一堆明星公司,他自己从来不当某个品牌的门面,都是扶持年轻创始人站到台前。还有最近银河通用更换董事长,背后站的其实是宇树的天使投资人,本质都是同一个路数。
    什么样的人适合做台前代言人?首先得有强个人IP,自带流量,懂技术,能跟专业用户同频;其次形象年轻正向,有故事感,符合大众对天才创业者的期待;最后表达能力强,能把复杂技术讲得通俗易懂。而幕后大佬需要的特质完全相反——懂产业、懂供应链、懂资本、懂商业谈判,能整合资源,能扛住周期,把控公司大方向。这些能力,恰恰不需要上热搜。
    那为什么偏偏机器人行业,这种模式特别普遍?你看大模型公司,创始人很多都是三十多岁的技术精英,自己就能当老板、站C位。但机器人行业完全不一样。
    第一,供应链太复杂。从电机、减速器、传感器到整机制造,每一环都是传统制造业沉淀了几十年的圈子,没有产业老炮的资源,根本拿不到核心零部件,拿不到好的产能和价格,甚至连代工厂都不会理你。
    第二,商业化靠B端。机器人最终要卖给工厂、物流、酒店这些企业客户,人家认的是交付能力、品控和产业资源,不是网红IP。谈大客户、做行业落地,还得是资深的产业人出面才镇得住。
    第三,周期长、烧钱多。机器人从研发到量产到盈利,周期比互联网长得多,融资、合规、产能爬坡,每一步都是坑。技术明星能把原型机做出来,但要把公司做长久,把量跑起来,还得靠幕后懂产业的掌舵人。
    说到这肯定有人问,现在智元这么猛,那它和宇树比,到底谁才是行业老大?
    先客观说,这次运动会智元双榜第一,确实亮眼,但不代表宇树不行。宇树的优势是入局早,四足机器人全球出货量第一,海外市场铺得非常广,品牌国际知名度高,运动控制的极致性能积累很深,高动态动作这块,至今还是行业第一梯队。
    那智元的优势在哪?后发但技术栈更全。它的“三智一体”架构,从作业大模型GO,到世界模型GE,再到真机强化学习RW-RL,从运动控制到灵巧手,全链路自研。尤其是场景落地能力,这次运动会的酒店、图书馆、园林这些真实工作场景赛,智元拿了一大半金牌,说明它的机器人是真能干活,不是只会炫技。而且去年智元出货5100台,量产能力和商业化推进速度非常快,再加上邓泰华带来的华为系供应链和产业资源,成本控制和产能扩张的后劲很足。
    劣势也很明显:宇树在海外市场和极致运动性能上有先发优势,智元的国际品牌认知度还不够;反过来,宇树在大模型融合和场景作业落地的进度上,比智元慢半拍。
    现在说谁是老大还为时尚早,人形机器人赛道才刚起步,一个是深耕多年的先发标杆,一个是势头凶猛的后起黑马,一个偏运动性能,一个偏作业落地。最终谁能先把十万级、百万级的出货量跑起来,把商业模式跑通,谁才是真正的行业龙头。
    想更深入了解人形机器人的技术路线、产业格局和未来机会的朋友,可以看看我的新书《人形机器人:技术、产业与未来社会》,里面详细拆解了智元、宇树这些头部公司的核心能力,也梳理了全球人形机器人的完整发展脉络。
    最后我想说,这个时代从来都不只有一种成功的活法。你可以选择站在聚光灯下,做万众瞩目的明星;也可以选择藏在幕后,做掌控全局的掌舵人。不用羡慕台上的光芒,也不用低估幕后的重量。只要认准方向,沉得住气,什么时候出头都不算晚。
    @aigc1024

  4. 前段时间,美国风投机构Dimension Capital的几个合伙人来中国深度拜访了一圈AI公司,用于修正自己的投资判断,他们回去后发给出资人的内部信传得挺广的,我把全文翻译过来给你们看看:

    前段时间,美国风投机构Dimension Capital的几个合伙人来中国深度拜访了一圈AI公司,用于修正自己的投资判断,他们回去后发给出资人的内部信传得挺广的,我把全文翻译过来给你们看看:
    跨太平洋的AI棋局
    1、稀缺催生进化
    美国的出口管制本意是为了拖慢中国的AI发展,但结果却意想不到的制造出了一种进化压力,导致中国的AI实验室拥有了世界独有的竞争围栏。
    因为缺少算力,中国团队被迫深入到极其底层的架构里去做工程优化,DeepSeek在刻意削弱性能的H800上训练模型,并绕过CUDA在更下面的PTX上编程,甚至要把每张GPU里的一部分流式多处理器专门分配给跨节点通信。
    我们认为,这并不是美国工程师干不了的事情,而是因为两边的刺激机制不同。
    美国的AI公司更愿意用资本解决问,每多投入一美金,就能多买来一美金的算力,但在中国,因为始终没有充足的算力可供购买,所以形成的方案是,每多一个懂编译器的工程师,就能降低整个团队对于算力的需求。
    最后形成的是一种覆盖全栈的效率文化,从系统、优化器、推理算法、一直延伸到芯片,这种能力可以持续积累,不像一次性的资本开支,用完就结束了。
    2、中国开源模型完成了过去20年中国SaaS都没能做到的事情——进入西方生产环境
    不到18个月,中国模型在OpenRouter上的Token消耗份额从不足2%飙升到了45%,Qwen成为Hugging Face上面最快突破10亿次下载的模型家族,大约80%的美国AI初创公司,已经在内部部署了至少一款来自中国的开源模型。
    开源绕过了传统软件采购的审查,当模型可以免费部署,也就不存在「供应商」让你放进黑名单。
    但吊诡的地方在于,中国的开源模型本质上是在承担西方的生产成本,而并没有拿走西方的生产收入。
    因为可以自行部署那些开源模型,所以最主要的利润,仍然流向负责提供Token的云厂商。
    所以中国人把模型价格打了下来,让竞争对手很难受,但最主要的受益者仍然是美国的其他商业公司,因为它们能用到更便宜的模型了。
    这不是说中国AI公司有钱不赚,开源这种生态在客观上就是会把利润的最大头分配给云厂商,而非模型开发商。
    3、中国前沿模型的内部竞争,比西方预计的更加激烈
    我们的判断是,目前中国模型的第一梯队包括DeepSeek、Qwen、Kimi、Doubao和GLM,它们之间的差距非常小,洗牌也相当频繁。
    五家实验室同时比拼发布速度和模型能力,而且全部开源(译注:豆包并没有开源),这与美国主要由两家闭源实验室主导的竞争环境截然不同。
    我们在这一周里最明显的感受就是,中国模型之间的竞争,可能更甚于它们和美国模型之间的竞争。
    4、今天,AI要从太平洋两岸来回跑两趟,才能最终落地到客户那里
    现在的循环大致上是这样的:
    美国的前沿实验室训练出SOTA级的模型;
    中国的前沿实验室对这些模型进行蒸馏,然后开源;
    美国的AI服务商再基于中国的开源模型进行微调,做成产品卖给美国企业……
    Cursor所谓「自主研发」的Composer 2,被发现是用Kimi K2.5改的,Cognition的SWE-1.5看起来也像一个定制版GLM。
    就在我们坐在从上海去北京的高铁上时,Harvey发布了自己的专有模型Harvey Tenet——它是对Kimi K3进行了后训练所得到的产物。
    如果是一年前,这些公司大概率会选择Llama,或者Mistral。
    如今,美国垂直AI行业的底层基座,正在变成中国的开源模型——而这些模型内部,又潜藏着来自美国前沿模型的智能。
    5、数据层似乎也在发生类似的事情
    Mercor、AfterQuery、Turing这些美国的数据标注公司,都已经公开披露与蚂蚁、阿里巴巴和字节跳动存在商业合作关系。
    同时,我们也在中国看到了一批刚刚出现的新公司,它们没有再去做数据标注的生意,而是转为评测和验证基础设施。
    比如UniPat。
    这家公司成立于2025 年12月,创始人是一名北京大学博士生,此前曾在阿里、月之暗面和腾讯工作。
    UniPat发布的 基准测试,已经开始被美国实验室引用到自己的模型报告中,它还声称,通过自己基于Rubric的监督方法训练一个小模型,也取得了很好的效果。
    这种思路还是在用更高质量的监督替代更多算力,与我们在第一点中提到的现象完全一致:资源,尤其是算力受限的环境,会逼迫团队发展出不同的适应性能力。
    我们在北京和上海见到了好几家这样的公司,绝大多数成立不到24个月,其中少数几家的收入已经很快的突破了1亿美金。
    6、美国和中国面临的难完全不同,而且恰好相反
    2024年,中国新增的电力供给是429GW,美国大概是51GW。
    根据预估,一直到2030年,中国每年新增的电力供给,都将在400GW以上。
    美国的情况是,目前光是数据中心的扩建项目,就有241GW的电力缺口,因为电网接入的积压,需要排队等上5年时间。
    中国真正的瓶颈,正如我们提到过的,是算力资源不足。
    最直接的例子就是月之暗面:Kimi K3发布后不到两天,就因为推理能力不足而暂停了新用户注册。
    所以:
    美国芯片充裕,但越来越受制于电力;中国电力充裕,但一直都受制于芯片。
    我们可以确信的是,中期AI局势很大程度上将取决于哪一侧的障碍先被推倒,是美国的电网容量先得到改善,还是中芯国际和华为的先进封装以及良品率提升得更快。
    7、中美两国的AI产值差太远了
    Anthropic在7月的年化收入超过了650亿美金,OpenAI的同期数字在400亿美金左右。
    相比之下,中国收入最高的模型是字节跳动的Seedance,年化收入大概在20-30亿美金之间。
    中国的纯语言模型公司,年化收入都还停留在数亿美金级别,比如DeepSeek正在接近5亿美金的水位。
    消费端也有同样的困扰,豆包的月活用户已经达到3.45亿了,超过Qwen和DeepSeek之和,但每天产生的收入仍然不到100万人民币,而且基本全部都来自购物佣金。
    中国的消费者不愿意为软件付费这个死结,我们也不知道该如何解开。
    当然,拥有如此庞大的用户规模,最终完全可能找到具有中国特色的商业模式,这在十年前的消费互联网已经发生过一次了。
    那就是羊毛出在猪身上,靠电商和广告来实现模型的商业化,中国的创业者身上有种实用主义精神,他们不会因为某种商业模式不够AGI而回避它。
    8、硬件和半导体在脱钩,软件和数据在融合
    两个国家的政策反应速度已经跟不上了:
    美国的产品跑在中国的模型上;
    中国的实验室在新马泰租用英伟达的GPU训练模型;
    专家标注的数据则在两个方向上互相流动;
    所以我们觉得「到底哪边在赢」是一个伪命,在目前的状态下,两个体系已经高度相互绑定,以致于国家层面的胜负很难被清晰定义。
    除非RSI(递归自我改进)的实现能从根本上改变整个系统结构。
    9、中国的一些顶尖研究员相信他们已经拥有弱形式的RSI了
    在此语境下的RSI,仍然受到算力限制。
    更准确的说,这些系统如同RSI的早期雏形:
    研究员自己介入其中,通过人工辅助的方式,加速模型到达原本最终也可能到达的能力,从而节省算力和时间。
    打比方来讲,这一阶段的RSI,最接近1990年到2010年之间流行的「半人马国际象棋」:
    机器加人类的组合,比单独的人类或单独的机器都更强。
    10、接下来会有一个至关重要的分叉
    假设RSI会随着算力规模的增长而进化,那么美国所处的位置就相当有利了。
    目前,美国那两家顶级实验室各自运行有大约2GW的算力基础设施,同时每家已经锁单超过5GW,计划到2030年达到约30GW的水平。
    理论上,这些公司拥有巨额收入和资本市场的全力支持,可以大力出奇迹的推动RSI,而中国根本没有足够的芯片追赶。
    但另一种情况是:
    如果真正的瓶颈并不在于算力,而是质量;
    或者,这条技术线所需要的时间足够长,长到足以让中国的优化能力和替代芯片发展到可用水平;
    那么过去18个月已经出现的趋势可能不仅会继续,还会加速:
    美国前沿模型能力进一步商品化;
    中国开源模型变得越来越无处不在;
    美国垂直AI公司则获得新的机会——在外国开放权重模型上做微调和应用;
    与此同时,大量新增的调用量和利润,会流向负责提供推理服务的公司,目前来看,主要就是超大规模云厂商和新型算力公司。
    当然,这一判断建立在电力基础设施按中性预测发展的前提之上。
    11、还有一种未来的可能性是,美国的前沿实验室不再对外提供最新版本模型的API了
    现实是,目前这一代模型的能力,已经可以满足绝大多数商业需求了。
    未来顶尖的高端模型,可能不会再按调用量定价,而是像交付SaaS系统那样,按结果定价。
    这样做还有另一个效果:限制中国实验室的蒸馏行为。
    美国公司的代价是要放弃不断增长的API调用收入,作为回报,它们可以切断太平洋对面的竞争威胁。
    或者至少,这会迫使中国进行昂贵的预训练,从而进一步挤压中国已经存在的算力资源。
    12、监管政策砍不断跨太平洋的暗通款曲
    到了今天,如果还认为可以简单切断这种联系,实在是过于天真了。
    中美两国的技术人员正在通过各种媒介「对」:
    模型蒸馏、开放权重、数据标注、推理服务,以及越来越多的软件执行框架和智能体基础设施。
    眼下正在讨论的一些粗暴限制措施——实体清单、托管禁令、采购禁令——几乎肯定会抑制美国自身的创新,并让美国在这些领域失去领导地位。
    而空出来的位置,必然会迎来快速跟进的中国竞争者。
    13、西方一直在讨论的估值泡沫,在中国市场明显更加突出
    中国AI公司的收入规模更低,却享有更高的估值倍数,这是资本市场的一大奇观。
    月之暗面的估值是年化收入的115倍,智谱、MiniMax在上市之初也都是100倍,相比之下,Anthropic只有20倍。
    我们的判断是,这可能源于中国的资本市场仍不够成熟。
    过去二十年,这个市场更习惯于给消费软件公司定价,而现在才刚刚开始建立一套能够理解企业软件和开源商业模式的成熟估值框架。
    对于合适的投资机构来说,中国内地和香港存在着相当大的机会,能

  5. 怎么感觉 Anthropic 和 OpenAI 对调了😂

    怎么感觉 Anthropic 和 OpenAI 对调了😂
    OpenAI 宣布断供 Cursor 后不到两小时,Anthropic 联合创始人、首席算力官(Chief Compute Officer)Tom Brown 在 X 上回应:Cursor 从 2024 年的 Sonnet 3.5 时代起就是 Anthropic 信任的合作伙伴,Anthropic 会继续增加算力支持 Cursor 里的 Claude 模型,也期待 Cursor 在 SpaceX 的下一步。

    AI探索 | Hermes/OpenClaw|优质资源|优质信息

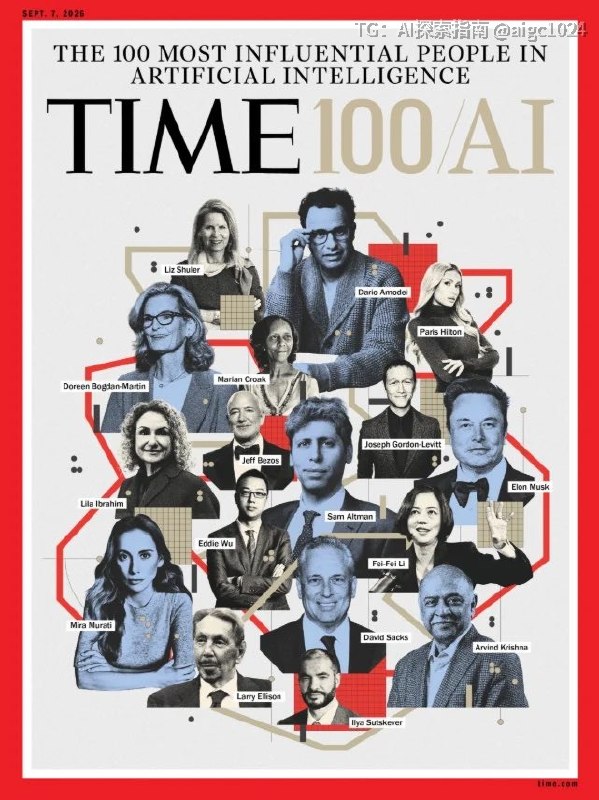
  6. 《时代》2026 AI 百大人物,中美两张图放在一起看很有意思

    《时代》2026 AI 百大人物,中美两张图放在一起看很有意思。
    美国这边,Sam Altman、马斯克、Dario Amodei、Ilya Sutskever 等人,核心集中在大模型、超级智能和前沿研究。
    中国入选的 9 人,则明显更分散:大模型、Agent、芯片、机器人、自动驾驶全面开花。
    某种程度上,这两张图也像是中美 AI 路线的缩影:
    美国继续冲击 AI 能力的上限,中国则在加速把 AI 塞进芯片、汽车、机器人和真实产业。
    AI 的下一阶段,竞争已经从“谁的模型更强”,逐渐走向“谁能把智能变成更大的生产力”。

    AI探索 | Hermes/OpenClaw|优质资源|优质信息

  7. Vercel推出了一个叫 vgpu 的 WebGPU 库

    Vercel推出了一个叫 vgpu 的 WebGPU 库。它的核心是为 AI 智能体设计的一套着色器,既能在浏览器里交互运行,也可以在 Node.js 环境里运行。
    它把 WGSL 着色器当作 TypeScript 处理,支持像模块一样导入导出,在打包时具有非常好的扩展性。
    而且它在安装和使用时,提供了提示词、CLI、SDK、MCP 等多种方式,去告诉 AI 智能体怎么使用。
    我把前几天用智谱 GLM-5.3-Flash 做的那个案例用 vgpu 优化了一下,加了很多细节,比如投影、模糊,以及自定义参数的配置。
    https://vgpu.sh/
    @aigc1024

  8. a16z 刚刚募了 11 亿美元,成立全新的 Machine Age Fund

    a16z 刚刚募了 11 亿美元,成立全新的 Machine Age Fund。
    重点押注 AI 背后的“物理世界”。
    从芯片、内存、网络、存储,到数据中心、电力、散热、机器人和 AI 硬件,全都在投资范围内。
    a16z 的判断是,AI 算力需求增长已经开始撞上现实世界的供应链和物理极限。
    AI 下一阶段最大的机会之一,可能就是把整个基础设施重新造一遍。

    AI探索 | Hermes/OpenClaw|优质资源|优质信息

  9. 早晨我输入了一大段,让 AI 帮我梳理成一篇 1500 字左右文章

    早晨我输入了一大段,让 AI 帮我梳理成一篇 1500 字左右文章
    它梳理了两个小时,各种修改,各种改不对,一直在添油加醋,加一些奇怪的东西
    后来我放弃了
    我打开 md 编辑器,看复制粘贴进去,发现已经 1200 字了
    其实要是自己写的,可能半小时不到就写完了
    在写作方面,AI 提效也不太成立
    @aigc1024

  10. a16z 刚刚募了 11 亿美元,成立全新的 Machine Age Fund

    a16z 刚刚募了 11 亿美元,成立全新的 Machine Age Fund。
    重点押注 AI 背后的“物理世界”。
    从芯片、内存、网络、存储,到数据中心、电力、散热、机器人和 AI 硬件,全都在投资范围内。
    a16z 的判断是,AI 算力需求增长已经开始撞上现实世界的供应链和物理极限。
    AI 下一阶段最大的机会之一,可能就是把整个基础设施重新造一遍。

    AI探索 | Hermes/OpenClaw|优质资源|优质信息

  11. a16z 刚刚募了 11 亿美元,成立全新的 Machine Age Fund

    a16z 刚刚募了 11 亿美元,成立全新的 Machine Age Fund。
    重点押注 AI 背后的“物理世界”。
    从芯片、内存、网络、存储,到数据中心、电力、散热、机器人和 AI 硬件,全都在投资范围内。
    a16z 的判断是,AI 算力需求增长已经开始撞上现实世界的供应链和物理极限。
    AI 下一阶段最大的机会之一,可能就是把整个基础设施重新造一遍。

    AI探索 | Hermes/OpenClaw|优质资源|优质信息

  12. a16z 刚刚募了 11 亿美元,成立全新的 Machine Age Fund

    a16z 刚刚募了 11 亿美元,成立全新的 Machine Age Fund。
    重点押注 AI 背后的“物理世界”。
    从芯片、内存、网络、存储,到数据中心、电力、散热、机器人和 AI 硬件,全都在投资范围内。
    a16z 的判断是,AI 算力需求增长已经开始撞上现实世界的供应链和物理极限。
    AI 下一阶段最大的机会之一,可能就是把整个基础设施重新造一遍。

    AI探索 | Hermes/OpenClaw|优质资源|优质信息

  13. a16z 刚刚募了 11 亿美元,成立全新的 Machine Age Fund

    a16z 刚刚募了 11 亿美元,成立全新的 Machine Age Fund。
    重点押注 AI 背后的“物理世界”。
    从芯片、内存、网络、存储,到数据中心、电力、散热、机器人和 AI 硬件,全都在投资范围内。
    a16z 的判断是,AI 算力需求增长已经开始撞上现实世界的供应链和物理极限。
    AI 下一阶段最大的机会之一,可能就是把整个基础设施重新造一遍。

    AI探索 | Hermes/OpenClaw|优质资源|优质信息