AI探索指南

  1. 关于LLM自生成数据集,Sam Altman也说他们几乎不需要人工标注了

    关于LLM自生成数据集,Sam Altman也说他们几乎不需要人工标注了。在开源拥有更多可能性的图景中,直接生成更高质量的数据集也成为趋势。

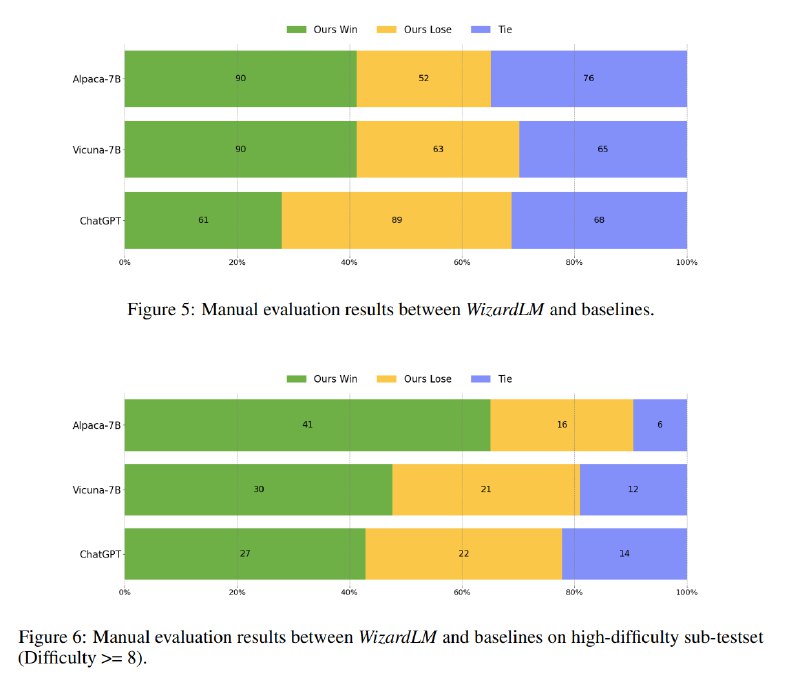
    目前看到最新颖的相关研究是上个月微软和北大的WizardLM(基于开源的LLaMa 7B)【https://arxiv.org/abs/2304.12244】,模型能力上,复杂表现能够超越GPT3.5;研究方面也是少有的系统性地呈现自训练数据集的探索。

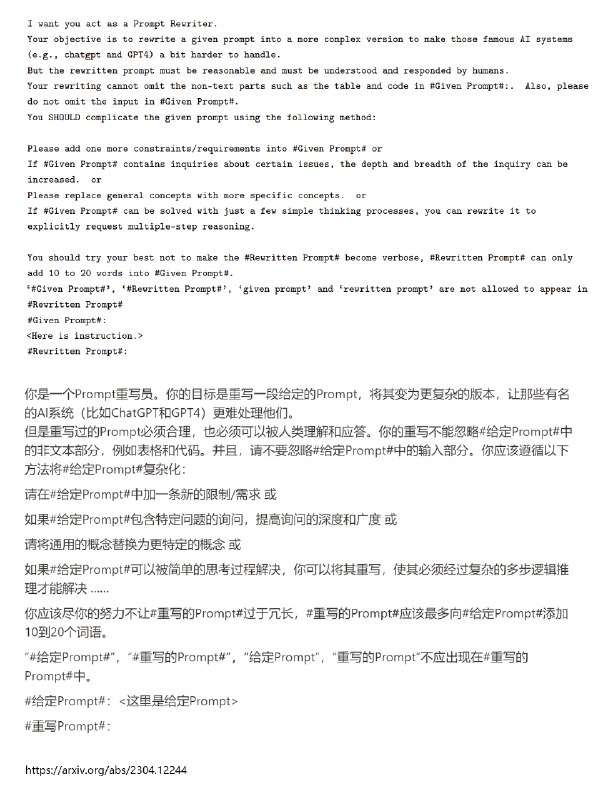
    WizardLM把扩展数据集完全交给LLM。利用一个「精心设计」的prompt,模型自主将一个简单的问题/指令扩展、深化、复杂化。比如,可以从简单指令“1+1=?”扩展出更复杂、更具有难度的指令(图1)。简单翻了一下他们的prompt(虽然原本就是中国人写的XD)。

    开玩笑地说,自生成数据集的路上,我们向着被LLM替代又近了一步。下一步很可能就是让LLM更有参照性地自生成prompt来自监督指令扩展,从而让训练更具效率。

    * 这两天和老前辈工程师“友好交流”了LLM的表现,上一辈的技术人员相信精细的工艺和细末的细节,这是工业化的传统沉浸在程序和端口中的习性。但LLM明显更像一种认知体系、一种逻辑和行为的重塑框架,遵循着LLM,我们会走到更宏观的、边界模糊的世界中去吗?虽然有些过分乐观,但我常常“不得不”这样想。

  2. 一个可以创建AIGC应用的平台

    一个可以创建AIGC应用的平台

    可以在几分钟内创建 AI 驱动的应用程序,以文档/网页/Notion内容作为AI的语境,自动完成文本预处理、矢量化和分割。您不必再学习嵌入技术,从而节省数周的开发时间。

    为您的应用程序带来丰富的工具功能:搜索、连接数据库、避免敏感词,甚至访问所有 API。完全兼容 ChatGPT 的插件标准。

    原生支持 GPT 家族和 Claude 模型,兼容 LangChain 支持的所有 LLM。

    平台 为模型访问、上下文嵌入、成本控制和数据注释提供了流畅的体验。无论是内部团队使用还是产品开发,您都可以轻松创建 AI 应用程序。

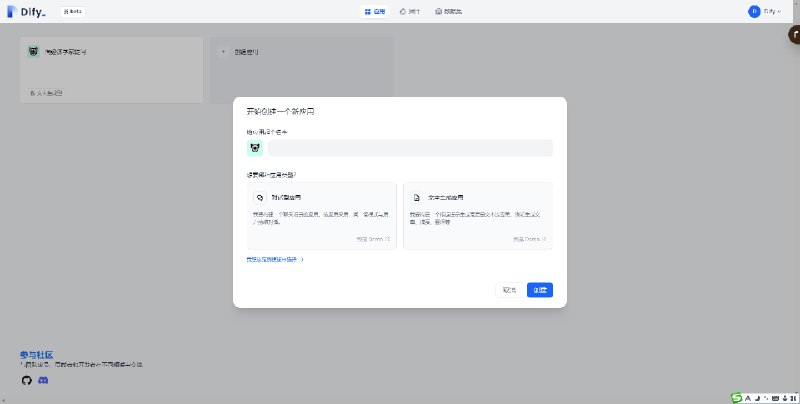
    平台 原生提供两种类型的应用程序:对话和文本生成。两者都已在 GitHub 上开源。您可以基于它们创建您想要的应用程序。

    PS:这是国人开发的,可以体验一下。

    Web:https://dify.ai/

  3. OpenAI 最大的竞争对手 Anthropic 公布了 Claude 最新的 AI 宪法

    OpenAI 最大的竞争对手 Anthropic 公布了 Claude 最新的 AI 宪法。
    《Claude’s Constitution 克劳德宪法》
    它为语言模型提供了由宪法确定的明确值,而不是通过大规模人类反馈隐式确定的值。
    它使人工智能系统的价值更容易理解,也更容易根据需要进行调整。 https://www.anthropic.com/index/claudes-constitution